Die Abmessungen von PDF-Seiten werden zum Zeitpunkt der Seitenerstellung festgelegt, sodass Sie den Inhalt nicht einfach an Ort und Stelle skalieren können, wie Sie es möglicherweise bei einem Bild tun würden. Das Bibliotheksmodell, das das Verkleinern praktikabel macht, ist das Erfassen und Neuzeichnen: Heben Sie den Inhalt jeder Seite aus dem Dokument in ein Handle, erstellen Sie eine neue leere Seite in der ursprünglichen Mediengröße und zeichnen Sie den erfassten Inhalt mit einem reduzierten Begrenzungsrahmen wieder ein. Der umgebende Leerraum wird zum Rand. Bei 70 % Skalierung auf einer A4-Seite fallen beispielsweise 15 % der Breite auf jede Seite und derselbe Bruchteil oben und unten, was genau das ist, was die Randarithmetik unten erzeugt
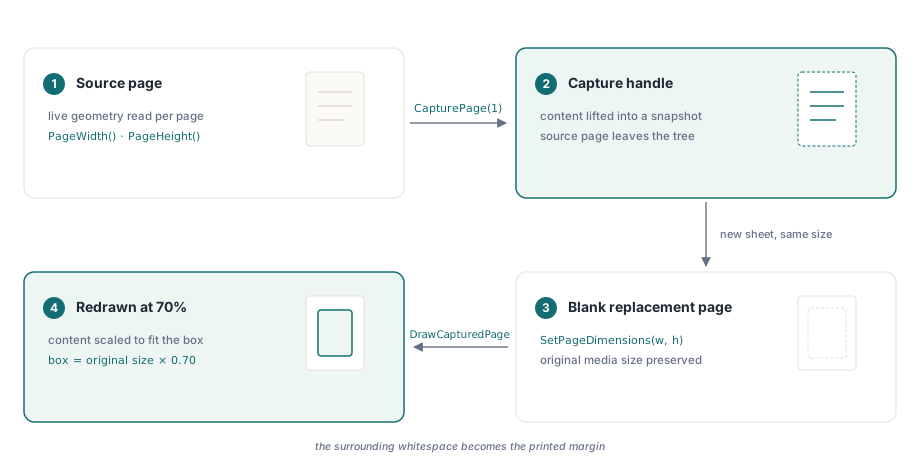
Wie CapturePage funktioniert
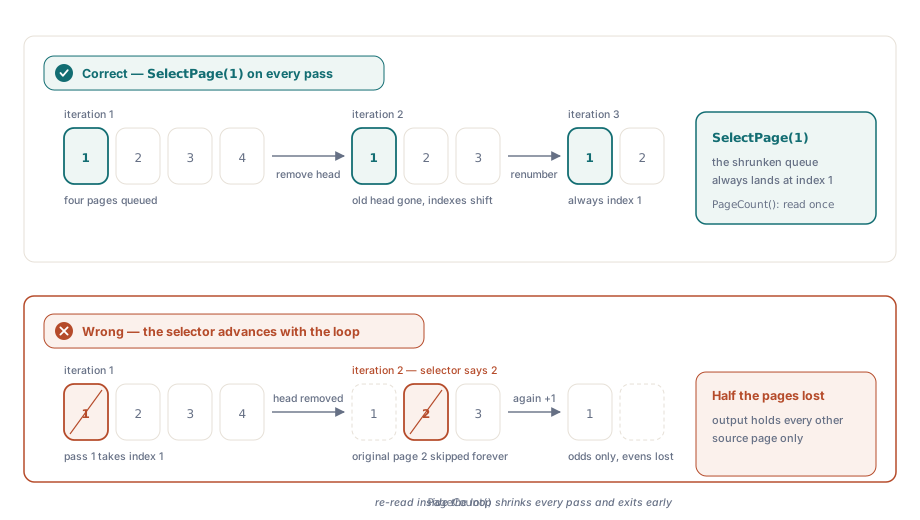
CapturePage nimmt eine Seitenzahl entgegen, stuft den Inhalt dieser Seite in ein In-Memory-Capture-Objekt hoch und entfernt die Seite aus dem Seitenbaum des Dokuments. Diese Entfernung ist beabsichtigt und der Grund dafür, dass die Schleife unabhängig vom Iterationsindex immer Seite 1 auswählt: Sobald Seite 1 erfasst und gelöscht wurde, wird die ehemalige Seite 2 zur neuen Seite 1 und so weiter. Wenn Sie den Seitenwähler zusammen mit dem Schleifenzähler erhöhen, überspringen Sie jede zweite Seite und erhalten nur die Hälfte der erwarteten Ausgabe
Das Capture-Handle, das CapturePage zurückgibt, ist keine Seitenreferenz; es ist eher ein Inhalts-Snapshot. Es bleibt nach dem Zeichnen gültig, dasselbe Capture lässt sich also mehrfach platzieren, bis Sie es mit ReleaseCapturedPage freigeben oder das Dokument verschwindet. DrawCapturedPage nimmt dieses Handle plus ein Zielrechteck entgegen, angegeben als linke Kante, obere Kante, Breite und Höhe, standardmäßig alles in Punkt. Die Bibliothek skaliert den erfassten Inhalt exakt auf dieses Rechteck; das Seitenverhältnis bleibt nur erhalten, wenn Ihr Rechteck zufällig den Originalproportionen entspricht. Für gleichmäßige Skalierung soll das Rechteck die Originalgröße mal dem Skalierungsfaktor sein, zentriert auf der Seite
Die Zentrierungsmathematik
Bei einem Skalierungsfaktor von 70 % werden die verbleibenden 30 % jeder Abmessung gleichmäßig auf die beiden Seiten aufgeteilt. Der horizontale Versatz beträgt also pageWidth * (1.0 - 0.70) / 2, was 15 % der Breite entspricht, und der vertikale Versatz folgt derselben Formel unter Verwendung der Seitenhöhe. Das Zielrechteck für DrawCapturedPage beginnt dann bei (horizBorder, vertBorder) und erstreckt sich über pageWidth - 2 * horizBorder mal pageHeight - 2 * vertBorder. Diese Arithmetik ist nicht bibliotheksspezifisch; es ist einfach die Geometrie, ein kleineres Rechteck symmetrisch in ein größeres einzupassen
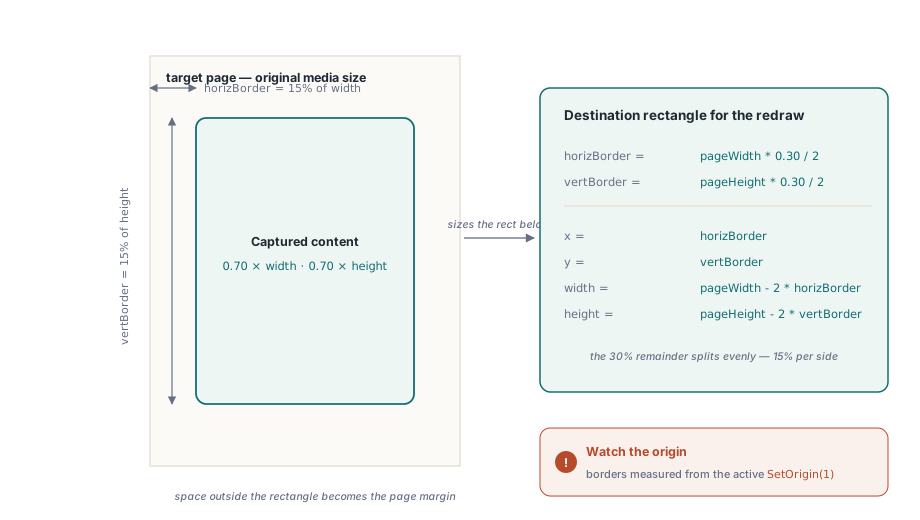
Eine Sache lohnt die Notiz: SetOrigin(1) legt den Koordinatenursprung oben links statt unten links. Der zweite Wert, den Sie DrawCapturedPage übergeben, ist die Oberkante des Rechtecks, gemessen ab dem Ursprung, den Sie gesetzt haben. Deshalb rufen die Beispiele zuerst SetOrigin(1) auf: Mit dem Default-Ursprung unten links würde dasselbe vertBorder die Oberkante nahe an den unteren Seitenrand setzen und den Großteil des Inhalts von der Seite drängen
C#-Beispiel
Der folgende Code schickt jede Seite von Pages.pdf durch den Erfassen-und-Neuzeichnen-Zyklus und schreibt das Ergebnis nach newpages.pdf. PDFL ist eine Instanz der Import-Klasse PDFlibrary, die mit der DLL-Edition kommt, erzeugt mit new PDFlibrary("PDFlibDLL64.dll"); die ActiveX-Edition legt dieselben Methoden über PDFlibAX.PDFlibrary offen
private void ScalePages_Click(object sender, EventArgs e)
{
    File.Delete("newpages.pdf");

    double pageWidth, pageHeight, horizBorder, vertBorder;
    double scaleFactor = 0.70;
    int capturedPageId, ret;

    PDFL.LoadFromFile("Pages.pdf", "");
    PDFL.SetOrigin(1);

    int numPages = PDFL.PageCount();

    for (int i = 1; i <= numPages; i++)
    {
        // Immer Seite 1 wählen: CapturePage entfernt die Seite, also wird
        // Seite 2 in der nächsten Iteration zur Seite 1.
        PDFL.SelectPage(1);

        pageWidth  = PDFL.PageWidth();
        pageHeight = PDFL.PageHeight();

        horizBorder = pageWidth  * (1.0 - scaleFactor) / 2;
        vertBorder  = pageHeight * (1.0 - scaleFactor) / 2;

        capturedPageId = PDFL.CapturePage(1);
        // 0 = nichts erfasst, z. B. eine einseitige Quelle: die einzige Seite kann nicht entfernt werden
        if (capturedPageId == 0)
            throw new InvalidOperationException("CapturePage failed on source page " + i);

        PDFL.NewPage();
        PDFL.SetPageDimensions(pageWidth, pageHeight);

        ret = PDFL.DrawCapturedPage(
            capturedPageId,
            horizBorder, vertBorder,
            pageWidth  - 2 * horizBorder,
            pageHeight - 2 * vertBorder);
        if (ret != 1)
            throw new InvalidOperationException("DrawCapturedPage failed on source page " + i);
    }

    PDFL.SaveToFile("newpages.pdf");
}
Delphi-Beispiel
Die Delphi-Version benutzt TPDFlib direkt statt über die DLL-Import-Klasse, die Aufrufsequenz ist aber identisch. Ein praktischer Unterschied ist die Absicherung der Ausgabedatei: FileExists plus DeleteFile statt File.Delete, denn SaveToFile scheitert, wenn das Ziel von einem früheren Lauf gesperrt ist, der noch in einem Viewer offen ist
procedure TForm1.ScalePagesClick(Sender: TObject);
var
  PDFLib: TPDFlib;
  pageWidth, pageHeight, horizBorder, vertBorder: Double;
  scaleFactor: Double;
  capturedPageId, ret, numPages, i: Integer;
begin
  if FileExists('newpages.pdf') then
    DeleteFile('newpages.pdf');

  scaleFactor := 0.70;

  PDFLib := TPDFlib.Create;
  try
    PDFLib.LoadFromFile('Pages.pdf', '');
    PDFLib.SetOrigin(1);

    numPages := PDFLib.PageCount();

    for i := 1 to numPages do
    begin
      PDFLib.SelectPage(1);

      pageWidth  := PDFLib.PageWidth();
      pageHeight := PDFLib.PageHeight();

      horizBorder := pageWidth  * (1.0 - scaleFactor) / 2;
      vertBorder  := pageHeight * (1.0 - scaleFactor) / 2;

      capturedPageId := PDFLib.CapturePage(1);
      // 0 = nichts erfasst, z. B. eine einseitige Quelle: die einzige Seite kann nicht entfernt werden
      if capturedPageId = 0 then
        raise Exception.CreateFmt('CapturePage failed on source page %d', [i]);

      PDFLib.NewPage();
      PDFLib.SetPageDimensions(pageWidth, pageHeight);

      ret := PDFLib.DrawCapturedPage(
        capturedPageId,
        horizBorder, vertBorder,
        pageWidth  - 2 * horizBorder,
        pageHeight - 2 * vertBorder);
      if ret <> 1 then
        raise Exception.CreateFmt('DrawCapturedPage failed on source page %d', [i]);
    end;

    PDFLib.SaveToFile('newpages.pdf');
  finally
    PDFLib.Free;
  end;
end;
Was der Skalierungsfaktor tatsächlich steuert
Der Wert 0.70 bedeutet hier, dass der gerenderte Inhalt 70 % jeder Seitendimension einnimmt, nicht dass die Datei 70 % ihrer ursprünglichen Bytegröße hat. Die Dateigröße nach dieser Operation hängt von der Komplexität des Originalinhalts ab; eine Seite mit großen Bildern schrumpft nicht proportional, weil die Pixeldaten in derselben Auflösung in eine kleinere Fläche neu gezeichnet werden. Zielte eine kleinere Datei, schauen Sie sich CompressContent für unkomprimiert ausgegangene Seiten-Content-Streams an und die Bild-Rekompression (OptimizeImages in der Delphi-Edition), nicht die geometrische Skalierung. LinearizeFile ist ein anderes Werkzeug: Es ordnet die Datei für Seite-für-Seite-Laden um (Fast Web View), was Viewern hilft, große Dateien übers Netzwerk zu öffnen, aber die Datei schrumpft dabei nicht
Die 70-%-Zahl ist auch keine harte Grenze. Jeder Wert zwischen 0.0 und 1.0 funktioniert, und Werte über 1.0 vergrößern den Inhalt über die ursprüngliche Seitengrenze hinaus, was an der MediaBox-Kante abgeschnitten wird, sofern Sie nicht auch die Seitendimensionen erhöhen. Dokumente mit gemischten Seitengrößen werden nebenbei mit abgedeckt, weil PageWidth und PageHeight je Seite vor der Randberechnung abgefragt werden; ein Dokument, dessen ungerade Seiten A4 und dessen gerade Seiten A3 sind, liefert also auf jeder Seitengröße korrekt zentrierte Ausgabe ohne jeden Sonderfall
Wo die Dinge schiefgehen können
In der Praxis treten zwei Fehlermodi auf. Der erste ist eine Ausgabedatei, die in einem PDF-Viewer aus einem vorherigen Durchlauf geöffnet gelassen wurde: SaveToFile schlägt fehl oder schreibt je nach Plattform null Byte, und die neue Ausgabe landet nie. Der Datei-Lösch-Schutz oben in der Funktion handhabt dies für die Entwicklung, aber in einer Produktionspipeline ist das Schreiben in einen temporären Pfad und das Umbenennen bei Erfolg sicherer
Der zweite Fehlermodus ist eine Seitenzahl-Diskrepanz. Weil CapturePage Seiten beim Verarbeiten aus dem Dokument entfernt, ist die Anzahl, die Sie vor der Schleife aus PageCount() lesen, die richtige Grenze, gegen die zu iterieren. PageCount() innerhalb der Schleife zu rufen hilft ebenfalls nicht: Jeder Durchlauf entfernt eine Seite und hängt eine an, die Zahl bleibt also konstant und verrät nichts darüber, wie viele Quellseiten übrig sind. Die Schleifenvariable in den Beispielen dient nur als Zähler für verbleibende Iterationen; sie wird nie zur Seitenauswahl benutzt, denn die zu wählende Seite ist aus dem zuvor erklärten Grund immer die 1
Die hier gezeigten Aufrufe zur Seitenmanipulation, einschließlich CapturePage, DrawCapturedPage und SetPageDimensions, sind Teil der losLab PDF-Bibliothek für Delphi, C#, VB.NET und C++