Zwei Minuten, um drei Seiten aus einem 40-seitigen PDF zu kopieren, ist kein Performance-Tuning-Problem. Es ist ein Signal, dass der falsche API-Pfad verwendet wird. Als ich dieses Timing zum ersten Mal bei Seitenkopier-Code sah, der auf der HotPDF Delphi Component aufbaute, war mein Instinkt, zuerst die Dokumentstruktur anzusehen und erst danach den Code. Diese Reihenfolge stellte sich als verkehrt heraus
Was tatsächlich langsam war
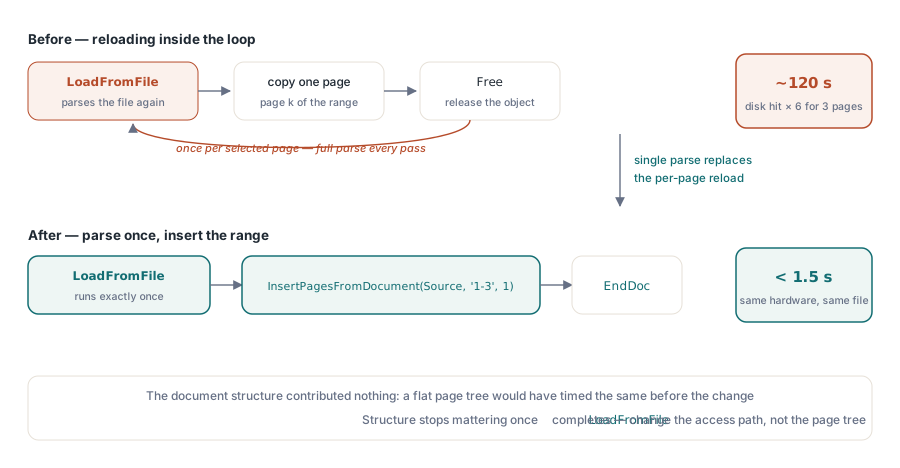
Das PDF war ein 40-seitiges Referenzdokument mit einem nicht-trivialen Seitenbaum: mehrere Zwischen-/Pages-Knoten statt eines einzelnen flachen Arrays. Der Code rief LoadFromFile auf, baute dann mit BeginDoc ein neues Dokument, lief über ausgewählte Seitennummern und lud bei jeder Iteration das Quelldokument erneut von der Festplatte, um eine Seite zu ziehen. Das sind die vollen Parse-Kosten multipliziert mit der Anzahl der Seiten, die man haben will. Eine 12-MB-Datei kam bei einer dreiseitigen Extraktion sechsmal auf die Festplatte, weil niemand prüfte, ob die Datei über die Iterationen hinweg offen bleiben muss
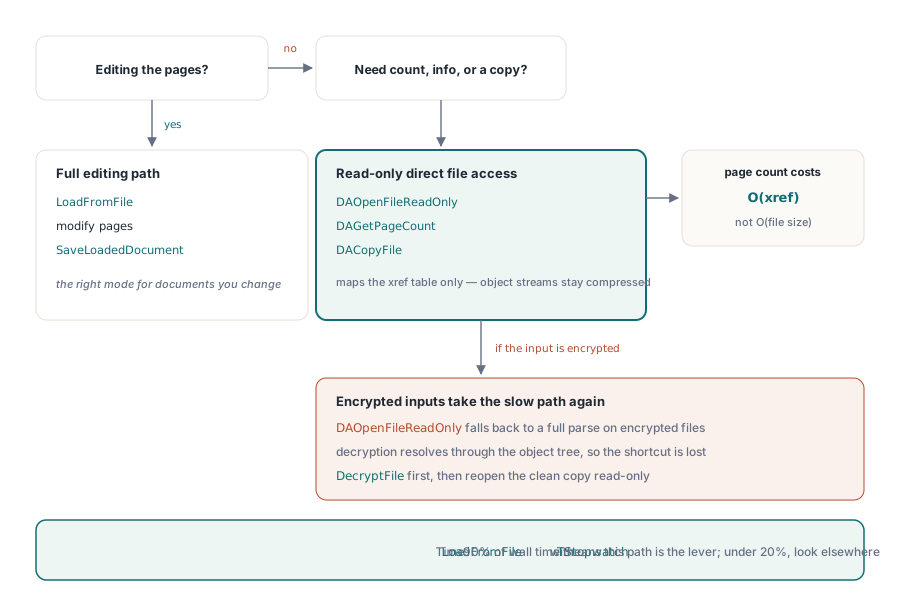
Der zweite Beitragende war im Code unsichtbar: HotPDFs LoadFromFile baut das In-Memory-Objektmodell auf, auf dem die Bearbeitungs-API arbeitet. Das ist das richtige Verhalten für ein Dokument, das man gleich ändern will, aber es ist mehr Arbeit als nötig, wenn man nur die Seitenzahl und eine Teilmenge von Seiten will. Für schreibgeschützten Zugriff auf die Struktur vermeidet DAOpenFileReadOnly die Deserialisierung des gesamten Objektbaums, was bei komprimierten Dateien mit großen Bildressourcen zählt
Beides läuft darauf hinaus, eine API, die für eine Aufgabe entworfen wurde, für eine andere einzusetzen
Seitenextraktion mit ExtractPagesToFile
Der richtige Weg, einen Bereich von Seiten aus einem geladenen HotPDF-Dokument in eine neue Datei zu kopieren, ist ExtractPagesToFile, aufgerufen nach LoadFromFile der Quelle. Sie laden die Quelle einmal, und der Aufruf baut das Zieldokument, kopiert die ausgewählten Seiten hinein und schreibt es auf die Festplatte, alles aus der bereits im Speicher befindlichen Kopie:
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source: THotPDF;
begin
  Source := THotPDF.Create(nil);
  try
    // Quelle einmal laden: das vollständige Parsen passiert hier und nur hier
    if Source.LoadFromFile(SourceFile) <= 0 then
      raise Exception.Create('Source PDF has no pages');

    // Den gewünschten Bereich ('1-3', '1,5,7-9') direkt in eine neue Datei schreiben
    Source.ExtractPagesToFile(DestFile, PageRange);
  finally
    Source.Free;
  end;
end;
Der Parameter PageRange akzeptiert dasselbe Format wie das Kommandozeilen-Beispiel: eine kommaseparierte Liste von Seitennummern oder Bereichen wie '1-3' oder '1,5,7-9'. Seiten sind 1-basiert. ExtractPagesToFile kopiert jede ausgewählte Seite zusammen mit den Content-Streams und Ressourcen, auf die sie verweist, sodass bei einer dreiseitigen Extraktion aus einem 40-seitigen Dokument der Arbeitssatz klein bleibt
Timing auf derselben 12-MB-Datei, die zuvor zwei Minuten lief: etwa 1,3 Sekunden mit diesem Muster. Der Großteil dieser Zeit ist der einzelne LoadFromFile-Aufruf. Die Dokumentstruktur ist irrelevant, sobald die Objekttabelle beim ersten Mal aufgelöst ist
Wenn LoadFromFile zu viel ist: die Direct File API
Wenn Sie nur Seiten zählen, Dokumentinformationen inspizieren oder eine Datei kopieren müssen, ohne ihren Inhalt anzurühren, vermeidet die Direct File API das vollständige Parsen gänzlich. DAOpenFileReadOnly bildet die Querverweistabelle ab, ohne Objektstreams zu dekomprimieren, sodass die Seitenanzahl O(xref-Größe) statt O(Dateigröße) kostet:
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile ist eine byteerhaltende Kopie, keine Neuserialisierung
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;
Der Vorbehalt: DAOpenFileReadOnly akzeptiert einen Passwortparameter, fällt aber bei verschlüsselten Eingaben auf ein vollständiges Parsen zurück, weil die Entschlüsselung den Objektbaum braucht, um das Verschlüsselungs-Dictionary aufzulösen. Sind Ihre Quelldateien verschlüsselt, entschlüsseln Sie sie zuerst mit DecryptFile, um eine unverschlüsselte Kopie zu erhalten, und öffnen Sie diese dann mit der Direct File API. Die Funktion DecryptFile auf Dateiebene nimmt für die Standardverschlüsselung einen direkten AES-256-Umschreibpfad und ist bei großen Dateien schneller als LoadFromFile gefolgt von SaveLoadedDocument, weil sie nicht das vollständige Objektmodell im Speicher aufbaut
Speicher bei der Verarbeitung großer Batches
Batch-Jobs, die Dutzende Dateien in einer Schleife verarbeiten, haben ein Muster, das korrekt aussieht, aber Speicher ansammelt: THotPDF innerhalb der Schleife erzeugen, LoadFromFile aufrufen, Arbeit erledigen, Free aufrufen. Das ist strukturell in Ordnung. Das Problem entsteht, wenn die innere Arbeit Hilfsobjekte anlegt, Exceptions abfängt und diese Hilfsobjekte auf Fehlerpfaden am Leben lässt. Der Speichermanager von Delphi kompaktiert nicht, sodass hundert Fehlerpfad-Lecks über einen Batch-Lauf den Speicher hoch genug treiben können, um die Allokation für alles andere zu verlangsamen
Die Abhilfe ist nicht exotisch. Jedes THotPDF und jeder zwischengeschaltete TStream oder TBitmap, der an PDF-Arbeit beteiligt ist, gehört in einen try/finally-Block, in dem Free die letzte Anweisung ist. Setzen Sie lokale Zeiger vor dem try auf nil, damit der finally-Zweig if Assigned(x) then x.Free sicher verwenden kann, wenn die Initialisierung auf halbem Weg fehlschlägt. Das ist Standard-Delphi-Besitzdisziplin und die ganze Geschichte für diese Problemklasse
Noch etwas, das man im Batch-Kontext wissen muss: AddImage registriert jedes Bild bei dem Dokument, das gerade gebaut wird, und HotPDF gibt diese Registrierungen frei, wenn EndDoc diese Datei abschließt. Die Registrierung folgt dem BeginDoc/EndDoc-Zyklus, nicht LoadFromFile, daher ist das saubere Muster für einen Batch eine THotPDF-Instanz pro Dokument: erzeugen, Arbeit erledigen, speichern, freigeben
Messen, bevor irgendetwas geändert wird
Bevor Sie zu einem dieser Muster greifen, messen Sie. Delphis TStopwatch aus System.Diagnostics kapselt QueryPerformanceCounter und ist für das Wanduhr-Profiling von Datei-E/A genau genug. Umhüllen Sie LoadFromFile allein und sehen Sie, wie viel Zeit darauf entfällt. Sind es 90 % der Gesamtzeit, ist die Abhilfe die Direct File API oder eine Verringerung der Häufigkeit, mit der Sie dieselbe Datei parsen. Sind es unter 20 %, liegt der Engpass woanders und Sie jagen dem Falschen hinterher
Die zweiminütige Extraktion, die diesen Beitrag auslöste, erwies sich als vollständig das wiederholte Lade-Muster. Die Dokumentstruktur trug nichts dazu bei; ein flacher Seitenbaum wäre genauso gelaufen. Der Wechsel zu einem einzelnen LoadFromFile gefolgt von einem ExtractPagesToFile-Aufruf brachte sie auf etwa 1,3 Sekunden auf derselben Hardware, ohne irgendetwas anderes anzufassen
Die hier gezeigte API zur Seitenmanipulation ist Teil der HotPDF Delphi Component für Delphi und C++Builder