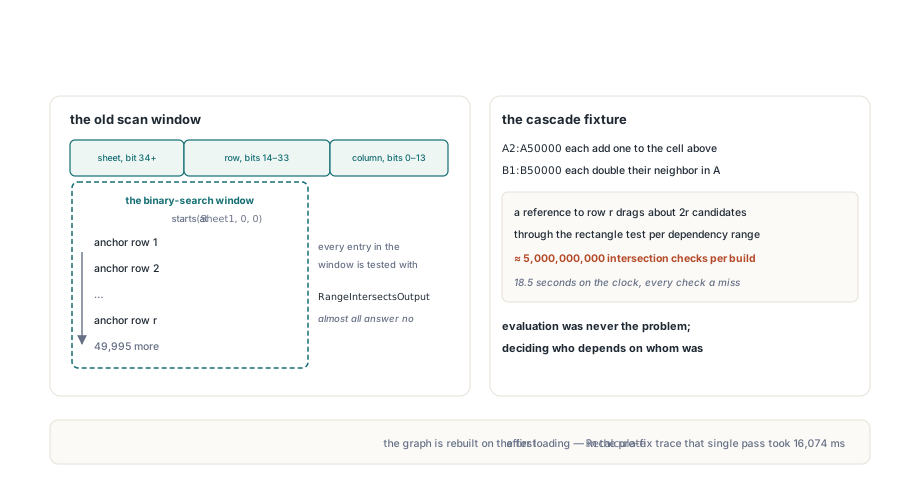
Ein Blatt mit 50.000 Formeln in Spalte A, die jeweils eins auf die Zelle darüber addieren, und weiteren 50.000 in Spalte B, die ihren Nachbarn verdoppeln, ist so schlicht, wie ein Tabellenmodell nur sein kann. Auswerten kostet 100.000 Additionen und Multiplikationen. Die Auswertungsreihenfolge zu bestimmen kostet weit mehr, wenn der Edge-Builder auf die naheliegende Weise geschrieben ist: jede Formel vom oberen Rand des referenzierten Blatts bis zur referenzierten Zeile durchsuchen, jede auf Überlappung prüfen und die Treffer behalten. Für dieses eine Blatt sind das grob fünf Milliarden Rechtecktests, und fast jeder davon endet mit Nein
Die fünf Milliarden sind Rechnung, keine Stoppuhr-Messung. Eine Referenz auf Zeile r zieht etwa 2r Kandidaten ins Suchfenster, einen pro Spalte für jede Zeile darüber, und summiert über 100.000 Referenzen landet das im Milliardenbereich. Das Interessante daran: Das Fenster muss wirklich am oberen Rand des Blatts beginnen, und zwar aus einem Grund, der mit Bequemlichkeit nichts zu tun hat
Wo ein Dependency-Graph-Neuaufbau seine Zeit verbringt
Die HotXLS-Recalculation-Engine baut ihren Formel-Dependency-Graph jedes Mal neu auf, wenn sich die Formel-Topologie ändert: beim ersten Recalculate, nachdem eine Arbeitsmappe geladen oder erzeugt wurde, und beim ersten danach, wenn Formeln umgeschrieben, Blätter hinzugefügt oder entfernt oder ein Zellblock geklont wurden. Beide Workbook-Klassen, TXLSWorkbook und TXLSXWorkbook, bauen dafür einen TXLSDepGraph aus der Unit lxDepGraph. Jede Formelzelle wird zu einem Knoten mit Anker (Row, Col) und einem Ausgaberechteck, das bis (OutRow2, OutCol2) läuft. Bei einer gewöhnlichen Formel ist das Rechteck die Ankerzelle selbst
Die Knoten sind nach einem gepackten 64-Bit-Schlüssel aus XLSDepMakeKey geordnet: die Spalte sitzt in Bit 0–13, die Zeile in Bit 14–33, der Blattindex ab Bit 34. Sortiert man nach diesem Schlüssel, ergibt sich eine Ordnung zuerst nach Blatt, dann nach Zeile; die letzte Formel zu finden, die für eine Referenz in Frage kommen könnte, ist daher eine einzige binäre Suche nach (Sheet2, Row2, 16383). Der erste ist das Problem. Die Untergrenze muss (Sheet1, 0, 0) sein, ganz oben am referenzierten Blatt, und alles zwischen den beiden Grenzen wird zum Kandidaten
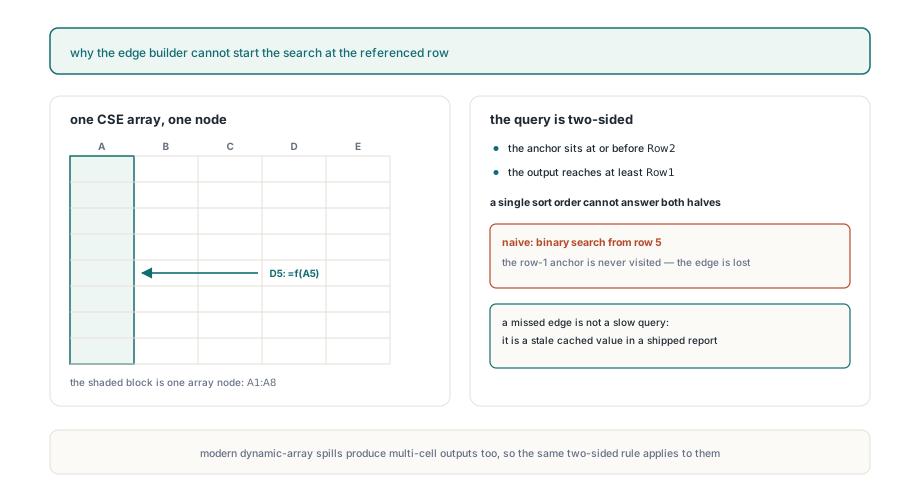
Warum kann die Suche nicht an der referenzierten Zeile beginnen?
Eine Array-Formel, die über einem Bereich verankert ist, kann Zellen in ihm besitzen. In einer TXLSXWorkbook ist ein als CSE-Array eingegebenes A1:A8 ein einzelner Knoten mit Anker A1, dessen Ausgabe bis Zeile 8 reicht, wie der Artikel zu inkrementeller Recalculation und dem Dependency-Graph beschreibt. Eine Formel in D5, die nur A5 liest, braucht trotzdem eine Kante von diesem Knoten. Beginnt die binäre Suche bei Zeile 5, wird der Anker in Zeile 1 nie besucht, die Kante nie eingetragen, und D5 kann ausgewertet werden, bevor das Array, von dem es abhängt, dran ist. Das Symptom ist ein veralteter Cache-Wert in der gespeicherten Mappe, und der fällt viel schwerer auf als eine langsame Recalculation
Die echte Abfrage hat also zwei Seiten. Ein Knoten ist Kandidat, wenn sein Anker auf oder vor Row2 liegt und seine Ausgabe mindestens bis Row1 reicht, auf einem Blatt innerhalb der Referenz und mit überlappenden Spalten. Eine Sortierung nach Anker beantwortet die erste Hälfte. Über die zweite Hälfte sagt die Ankerordnung nichts, denn eine Formel in Zeile 3 kann eine Zelle ausgeben oder tausend Zeilen. What-if-Datentabellen haben dieselbe Gestalt: TXLSXWorkbook registriert jede Datentabelle als einen Knoten, der ihren ganzen Ergebnisbereich abdeckt. Dynamic-Array-Formeln gehen einen anderen Weg und werden als volatil markiert, sodass sie in jedem Durchlauf neu berechnet werden; wie übergelaufene Bereiche sich verhalten, behandelt der Artikel zu Dynamic-Array-Spill-Formeln
TXLSDepGraph ist eine öffentliche Klasse, daher lässt sich der Fall ohne Workbook leicht nachstellen. Blattindizes zählen ab 1, Zeilen und Spalten ab 0, passend zu den Koordinaten des Calculators. Die Probe unten registriert den Array-Root und den Leser, baut die Kanten und schickt zusätzlich eine umgekehrte Punkt-Referenzkette durch denselben Graph-Typ, um den Zähler zu zeigen, auf den die nächsten Abschnitte bauen
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // CSE-Array: Anker A1 (Zeile 0, Spalte 0), Ausgabe bis A8 (Zeile 7)
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5 (Zeile 4, Spalte 3) liest nur A5
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1, der A1-Root
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2: A1-Root und D5 selbst
  finally
    G.Free;
  end;

  // Kette A1..A100000, jede Zelle liest die darüber, von unten nach oben eingefügt
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
Teilbäume anhand ihrer größten Ausgabezeile beschneiden
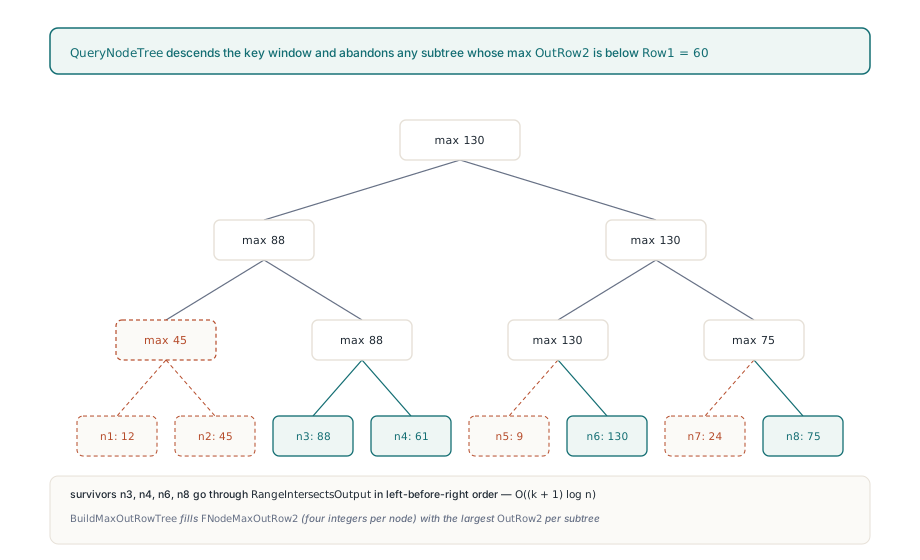
TXLSDepGraph.BuildEdges behält die Anker-Sortierung für die Obergrenze bei und beantwortet die Untergrenze mit einem Max-Segmentbaum, der über der sortierten Ordnung liegt. Jeder Baumeintrag speichert das größte OutRow2 aller Knoten unter ihm. Die Abfrage steigt nur innerhalb des Schlüsselfensters hinab und verwirft jeden Teilbaum, dessen gespeichertes Maximum oberhalb von Row1 liegt, weil keine Formel in diesem Teilbaum die referenzierten Zeilen erreichen kann. Überlebende Knoten bekommen trotzdem den vollen Rechtecktest, sodass Blattspanne und Spalten genau wie bisher geprüft werden
Die Technik ist klein genug, um sie komplett zu zeigen. Der Sketch unten ist eine Minimalversion, die eigens für diesen Artikel geschrieben wurde, mit eigenen Namen; keiner davon gehört zur HotXLS-API, und die Arrays füllt der Leser aus einer bereits nach Ankerschlüssel sortierten Liste von Ausgabezeilen
uses
  System.Math, System.Generics.Collections;

// Nur ein Sketch: ein Max-Segmentbaum über Knoten, sortiert nach Ankerschlüssel.
// OutRow2[i] ist die letzte Ausgabezeile des i-ten Knotens in sortierter Ordnung.
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// Sammelt von links nach rechts jeden Knoten in [Lo, Hi), dessen Ausgabe Row1 erreicht
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // außerhalb des Fensters, oder nichts erreicht Row1
  if L = R then
  begin
    Hits.Add(L);                 // der Aufrufer führt weiterhin den vollen Rechtecktest aus
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // links zuerst
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // erhält die Scan-Reihenfolge
end;

// Einmal mit BuildMax(Ix, 1, 0, Count - 1) aufbauen,
// dann pro Referenz Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits) aufrufen
Pro Referenz sinkt der Aufwand von der Größe des Fensters auf O((k + 1) log n), wobei k die Zahl der Knoten ist, deren Ausgabe die referenzierten Zeilen tatsächlich erreicht. Zurück beim Modell aus der Einleitung: Eine Referenz von Br auf Ar testet jetzt zwei Rechtecke, Ar und Br selbst, und eine Referenz von Ar auf die Zelle darüber testet die beiden Knoten dieser Zeile. Aus der Hand gerechnet sind das rund 200.000 Tests für den vollen Aufbau statt fünf Milliarden
Dieselben Kanten, in derselben Ordnung
Die Links-vor-Rechts-Rekursion ist wichtiger, als sie aussieht. Überlebende Knoten werden in genau der Ordnung besucht, in der eine schlichte Schleife über das Fenster sie besuchen würde, also füllen sich die Dependents- und Precedents-Arrays jedes Knotens in derselben Sequenz, und die daraus gebildete topologische Ordnung fällt bei jedem Lauf gleich aus. Diese Ordnung ist nicht nur interne Buchhaltung: Ist der Graph aktuell, schreibt der XLSX-Writer xl/calcChain.xml in der Reihenfolge, in der FullTopoOrder sie liefert, sodass eine nichtdeterministische Besuchsordnung als verrauschte Diffs zwischen zwei Speicherungen einer unveränderten Mappe auffallen würde
Auch die Kantenarten behalten ihre Regeln. Referenzen im Lookup-Array-Argument von VLOOKUP, MATCH, XLOOKUP und ähnlichen Funktionen erzeugen Lookup-Scan-Kanten, die Dirty-Markierungen weiterreichen, aber aus der Zykluserkennung rausbleiben. Hat ein Knoten sowohl eine harte Referenz als auch eine Lookup-Referenz auf denselben Vorgänger, unterdrückt eine zuerst eingetragene harte Kante die spätere Scan-Kante, und eine zuerst eingetragene Scan-Kante behält ihren Platz, während die harte Kante trotzdem noch dazu kommt. Genau diese Ordnung verhindert, dass Lookup-Bereiche falsche Zirkelbezüge produzieren, und sie hält nur, wenn der beschnittene Durchlauf die Kandidaten in Scan-Ordnung besucht
Die Eigenschaft EdgeCandidateChecks macht das Beschneiden beobachtbar. Sie zählt die Ausgaberechtecke, die der letzte BuildEdges-Aufruf wirklich getestet hat, und setzt sich zu Beginn jedes Aufbaus zurück. In der Probe oben meldet die umgekehrte Kette 99.999, ein Test pro Referenz, obwohl die Knoten von unten nach oben eingefügt wurden und die Sortierung alle neu ordnen musste. AddNode markiert sowohl die Sortierung als auch die Kanten als veraltet, daher baut der nächste BuildEdges- oder NodeIndexOf-Aufruf den Index neu, statt ihn zu flicken
Wo die restlichen Kosten liegen
Der Baum beschneidet nur nach Zeilen, und diese Entscheidung bestimmt, wofür ein großes Modell weiterhin bezahlt
- Spalten-Fehltreffer werden an den Blättern des Baums bezahlt: Die 2.626 Formeln, die
A100:Z200füllen, erreichen alle Zeile 100, daher testet eine Referenz aufAA100:AA200jede davon, bevor sie sie an den Spalten ausschließt - Ganzspalten- und andere breite Referenzen haben tatsächlich viele Vorgänger; der Index entfernt sinnlose Tests, und der Aufbau der echten Kanten bleibt proportional zu deren Anzahl
- Eine Referenz über mehrere Blätter öffnet ein Fenster, das das ganze erste Tabellenblatt abdeckt, sodass Formeln dort mit tiefen Ausgaben bis zum Test im Baumblatt durchkommen; die Kanten fallen genauso aus, nur das Beschneiden ist schwächer
- Der Baum kostet vier Integers pro Knoten, rund 1,6 MB für 100.000 Formeln, und jede Topologieänderung zahlt beim nächsten Kantenaufbau eine komplette O(n log n)-Neusortierung plus einen O(n)-Baumaufbau
Zeilen sind die richtige einzige Dimension zum Indizieren. Generierte Berichte, Kontenbücher und Finanzmodelle wachsen nach unten, daher stammen fast alle sinnlosen Kandidaten aus dem Zeilenabstand, während ein Spalten-Fehltreffer vom Rechtecktest in einer Handvoll Integervergleiche aussortiert wird. Eine zweite Dimension im Baum würde jede Abfrage verkomplizieren, um Tests zu sparen, die ohnehin billig sind
Auf der Aufruferseite ist der teure Schritt der Neuaufbau, und Wertänderungen lösen ihn nicht aus. Recalculate baut den Graph beim ersten Aufruf; spätere Aufrufe werten nur Formeln unterhalb geänderter Werte neu aus, plus der volatilen. Alle Formeln erst schreiben und einmal recalculieren ist das Muster, auf das es hinauslaufen soll. Das Harness unten misst beide Durchlaufarten auf der klassischen Engine, wo Recalculate die Zahl der Formelzellen zurückgibt, die es nicht auswerten konnte; fahren Sie es auf der Hardware aus, die später den Batchjob trägt, denn absolute Zeiten hängen stark an der Maschine
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // Kette mit 49.999 Gliedern in Spalte A
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // 50.000 Abhängige in Spalte B
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // baut den Graph, wertet alles aus
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // Wertänderung: der Graph wird wiederverwendet
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // nur der schmutzige Teilgraph
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
In diesem Modell wertet der Wertedurchlauf trotzdem alle 99.999 Formeln neu aus, weil die ganze Spalte A an A1 hängt; was er überspringt, ist der Graphaufbau. Eine Formelzelle mit einem schlichten Wert zu überschreiben ist etwas anderes, denn das ändert die Topologie, und das nächste Recalculate baut den Graph von Null auf
Dieselbe quadratische Gestalt bei geklonten definierten Namen
Berichtsbänder verstecken dasselbe Muster an einem anderen Ort. TXLSXWorksheet.CloneRangeTo kopiert definierte Namen, die direkt auf einen Bereich innerhalb des geklonten Blocks zeigen, und jede Kopie braucht einen Namen, der in ihrem Gültigkeitsbereich eindeutig ist: Total_2, Total_3 und so weiter. Eine Suche, die für jede Kopie bei _2 neu ansetzt, takst jedes Mal einen Kandidaten mehr, sodass ein Blatt aus hunderten geklonter Bänder bereits für die Namensgebung allein eine quadratische Zahl von Namensnachschlagen verbrennt
TXLSXDefinedNames vermeidet das mit einem Suffix-Hinweis, der in seinem Namensindex liegt, einer pro Basisname und Gültigkeitsbereich. Die nächste Suche startet vom zuletzt gelieferten Suffix und prüft es zuerst erneut, denn der Aufrufer darf diesen Namen auch weglassen. Ein Name löschen, ihn über Name umbenennen, mit SheetIndex verschieben oder die Sammlung leeren wirft den Index samt allen Hinweisen weg, sodass der nächste Klon zum ersten freien Suffix zurückkehrt und jede Lücke füllt, die die Änderung aufgerissen hat
Für Delphi- und C++Builder-Anwendungen, die große Tabellen erzeugen oder neu berechnen, nutzt die HotXLS-Excel-Komponente für Delphi und C++Builder diesen indizierten Dependency-Graph in der Recalculation-Engine beider Workbook-Klassen, der klassischen wie der XLSX-Variante