HotXLS bildet Excel-Trendline-Gleichungs- und R²-Labels in Delphi über XLSTrendlineEquationLabel in der Unit lxStandard nach. Die Funktion passt die Punkte der besitzenden Serie für lineare, exponentielle, logarithmische, polynomiale (Ordnung 2 bis 6), Potenz- und Moving-Average-Trendlines an und liefert denselben Text zurück, den Excel in DataLabel.Text meldet — Codepunkt für Codepunkt — oder False, wenn der Fit undefiniert ist
Der Grund, warum das überhaupt eine Funktion braucht: Das Label steht nicht in der Datei. Ein XLSX-Diagramm speichert ein c:trendline-Element mit einem c:trendlineType, den Schaltern c:dispEq und c:dispRSqr und einem optionalen c:trendlineLbl für Position und Formatierung, aber ECMA-376 DrawingML Charts gibt dem Label keinen eigenen Text. Excel rechnet y = 1.96x + 0.14 jedes Mal neu, wenn es das Diagramm zeichnet. Jeder Delphi-Code, der diesen Text zeigen, exportieren, durchsuchen oder vergleichen will, ohne Excel zu starten, muss ihn ebenfalls neu berechnen — und zwar so, wie Excel es tut, bis hin zu den Leerzeichen um das Minuszeichen
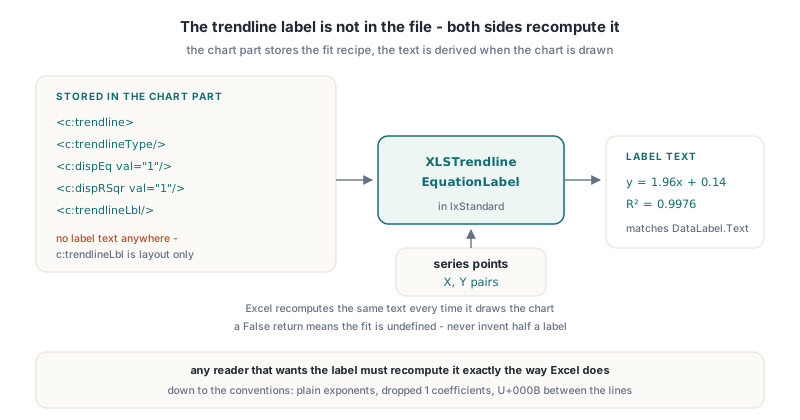
Warum formatiert man die Regressionskoeffizienten nicht einfach selbst?
Handformatierte Koeffizienten passen fast nie zum Excel-Label, denn das Label folgt etlichen kleinen Konventionen, die leicht zu übersehen und leicht gegenzuprüfen sind. HotXLS hat diese Konventionen aus Live-Excel-COM-Rücklesevorgängen von DataLabel.Text an einem Punktdiagramm eingefroren und dann den Formatter gegen diese Referenz geschrieben statt gegen die Intuition
Die Konventionen, die in der Praxis beißen:
- Exponenten sind schlichte Zeichen im Labeltext. Das polynomial Label liest sich
x2, nichtx², und das Potenz-Label liest sichx0.9732; die hochgestellte Optik ist ein Renderattribut des Diagramms, nicht Teil des Strings - Das einzige Nicht-ASCII-Zeichen ist das hochgestellte Zwei U+00B2 im Präfix
R² = - Ein Koeffizient von exakt 1 oder -1 wird weggelassen, also schreibt Excel
y = x + 3, nichty = 1x + 3 - Terme verbinden sich über ihre Vorzeichen mit Leerzeichen (
+und-), während ein führender negativer Koeffizient ein nacktes Minus bekommt, wie iny = -0.0429x2 + 2.2171x - 0.16 - Wenn Excel beide Zeilen zeigt, verbindet
DataLabel.Textsie mit U+000B, einem vertikalen Tab, nicht mit einem CR/LF-Paar
Auch die Zahlenformatierung ist begrenzt. XLSTrendlineEquationLabel druckt null als 0, wechselt bei einer Magnitude unter 0,0001 oder ab 1000000 zu einstelliger wissenschaftlicher Notation wie 2E+06 und verwendet sonst feste Notation mit vier Dezimalstellen bis 99,9999, je weiterer Ganzzahlstelle eine weniger, und getrimmten nachlaufenden Nullen. Deshalb erscheint 1.96 als 1.96 und nicht als 1.9600
XLSTrendlineEquationLabel aus Delphi aufrufen
XLSTrendlineEquationLabel nimmt die Trendline-Art als ganzzahligen Ordinalwert von TXLSXChartTrendlineType, eine Polynomordnung, ein offenes Array von TXLSTrendlineLabelPoint-Records mit X- und Y-Feldern sowie die beiden Anzeige-Schalter. Es liefert die Gleichungs- und R²-Strings über out-Parameter als WideString zurück und lässt einen String leer, wenn sein Schalter aus ist. Das Order-Argument zählt nur für xlsxTrendPolynomial; übergeben Sie 0 für die anderen Arten
uses
  lxStandard, lxHandleX;

procedure ShowFiveTrendlines;
const
  YS: array[0..4] of Double = (2.1, 3.9, 6.2, 8.1, 9.8);
var
  Points: array[0..4] of TXLSTrendlineLabelPoint;
  Eq, R2: WideString;
  I: Integer;
begin
  for I := 0 to 4 do
  begin
    Points[I].X := I + 1;
    Points[I].Y := YS[I];
  end;

  // Linear: Eq = 'y = 1.96x + 0.14', R2 = 'R' + #$00B2 + ' = 0.9976'
  if XLSTrendlineEquationLabel(Ord(xlsxTrendLinear), 0, Points,
    True, True, Eq, R2) then
    Writeln(Eq, ' | ', R2);

  // Polynomial order 2: 'y = -0.0429x2 + 2.2171x - 0.16', R2 0.9983
  if XLSTrendlineEquationLabel(Ord(xlsxTrendPolynomial), 2, Points,
    True, True, Eq, R2) then
    Writeln(Eq, ' | ', R2);

  // Exponential: 'y = 1.6767e0.3812x', R2 0.9386
  if XLSTrendlineEquationLabel(Ord(xlsxTrendExponential), 0, Points,
    True, True, Eq, R2) then
    Writeln(Eq, ' | ', R2);

  // Derselbe Text, den Excel in DataLabel.Text ablegt, wenn beide Zeilen gezeigt werden
  Eq := Eq + #$000B + R2;
end;
Die fünf Werte in dieser Probe sind der eingefrorene Excel-Bezugswert, den die HotXLS-Testsuite für jede Familie prüft. Der logarithmische Fit kommt als y = 4.7635ln(x) + 1.4589 mit R² = 0.9519 zurück, der Potenz-Fit als y = 2.0719x0.9732 mit R² = 0.9978. Weicht Ihre Ausgabe bei denselben Daten von Excel ab, widersprechen sich Bibliothek und Referenz, und das ist ein meldenswerter Bug, keine Rundungspräferenz
Wie berechnet Excel R-squared für exponentielle und Potenz-Trendlines?
Für das Trendline-Label ist R² die quadrierte Pearson-Korrelation zwischen den angepassten Werten und den tatsächlichen Y-Werten im ursprünglichen Datenraum, und XLSTrendlineEquationLabel berechnet es auf dieselbe Weise. Die Koeffizienten eines exponentiellen, logarithmischen oder Potenz-Fits stammen weiterhin aus gewöhnlichen kleinsten Quadraten auf log-transformierten Daten: ln(y) gegen x für exponentiell, y gegen ln(x) für logarithmisch und ln(y) gegen ln(x) für Potenz. Nur die Gütezahl wird zurück im natürlichen Domain gemessen
Das ist das Detail, das die meisten Nachimplementierungen falsch machen, denn der Lehrbuchansatz misst R² im transformierten Raum, in dem die Gerade angepasst wurde. Auf der Referenzpopulation zeigt sich der Unterschied bereits in der zweiten Dezimalstelle. Der exponentielle Fit im transformierten Raum liefert 0,9477, während Excels Label, live zurückgelesen, R² = 0.9386 sagt — die Korrelation im natürlichen Domain. Ein Label-Generator, der seine Regressionsstatistik aus dem transformierten Raum wiederverwendet, druckt die falsche Zahl auf das erste Diagramm, das ein Nutzer vergleicht
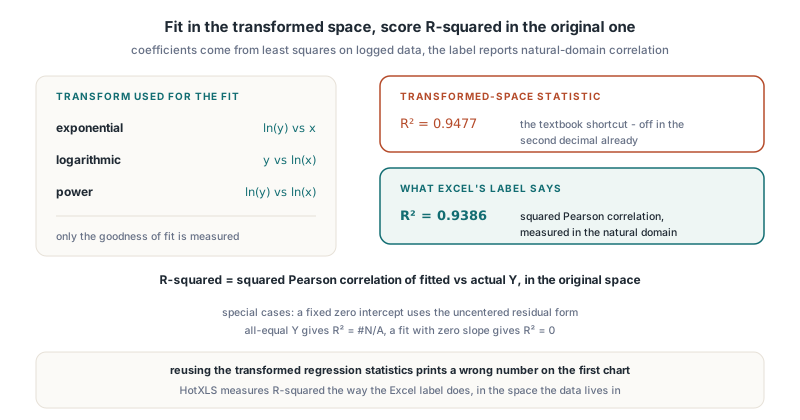
Zwei Sonderfälle ändern die Formel. Eine lineare Trendline mit festem Achsenschnittpunkt null verwendet die unzentrierte Residuenform — 1 minus die Residuenquadratsumme über die Summe der quadrierten Y-Werte —, was dem entspricht, was Excel für diese Konfiguration zeigt. Eine Population, deren Y-Werte alle gleich sind, hat keine zu erklärende Varianz, also lautet das Ergebnis R² = #N/A neben einer konstanten Gleichung wie y = 5. Eine nichtkonstante Population, deren Fit zufällig die Steigung null hat, bekommt stattdessen R² = 0
Feste Achsenschnittpunkte und die zweite Überladung
Die zweite XLSTrendlineEquationLabel-Überladung ergänzt InterceptSet: Boolean und Intercept: Double vor den Ausgabeparametern, was das c:intercept-Element der Trendline und die Eigenschaften InterceptSet und Intercept von TXLSXChartTrendline spiegelt. Excel bietet einen festen Achsenschnittpunkt nur für lineare, exponentielle und polynomial Trendlines an, und die Funktion setzt dieselbe Regel durch: Ein fester Achsenschnittpunkt bei einem logarithmischen oder Potenz-Fit gibt False zurück, und ein exponentieller Fit braucht einen positiven Achsenschnittpunkt, weil der Fit mit seinem Logarithmus arbeitet
procedure LabelForTrendline(Trend: TXLSXChartTrendline;
  const Points: array of TXLSTrendlineLabelPoint);
var
  Eq, R2: WideString;
begin
  if not XLSTrendlineEquationLabel(Ord(Trend.TrendlineType), Trend.Order,
    Points, Trend.DispEq, Trend.DispRSqr, Trend.InterceptSet,
    Trend.Intercept, Eq, R2) then
  begin
    // Undefinierter Fit: kein Label erfinden
    Writeln('No label for this trendline');
    Exit;
  end;
  if Eq <> '' then Writeln(Eq);
  if R2 <> '' then Writeln(R2);
end;

procedure AddQuadraticThroughOrigin(Series: TXLSXChartSeries);
var
  Trend: TXLSXChartTrendline;
begin
  Trend := Series.AddTrendline(xlsxTrendPolynomial);
  Trend.Order := 2;
  Trend.DispEq := True;
  Trend.DispRSqr := True;
  Trend.InterceptSet := True;
  Trend.Intercept := 0;
end;
Die eigenen Eigenschaften der Trendline direkt in die Überladung zu speisen hält das Label im Takt mit dem, was die Arbeitsmappe Excel zu zeichnen auftragen wird. Ist InterceptSet auf False, wird der Intercept-Wert ignoriert, die Eigenschaft bedingungslos zu übergeben ist also sicher. Ein fester Achsenschnittpunkt senkt zudem die Punkteanforderung um eins: Ein Polynom der Ordnung n braucht normalerweise n + 1 Punkte, aber nur n, wenn das konstante Glied festgenagelt ist
Welche X-Werte verwendet eine Line-Chart-Trendline tatsächlich?
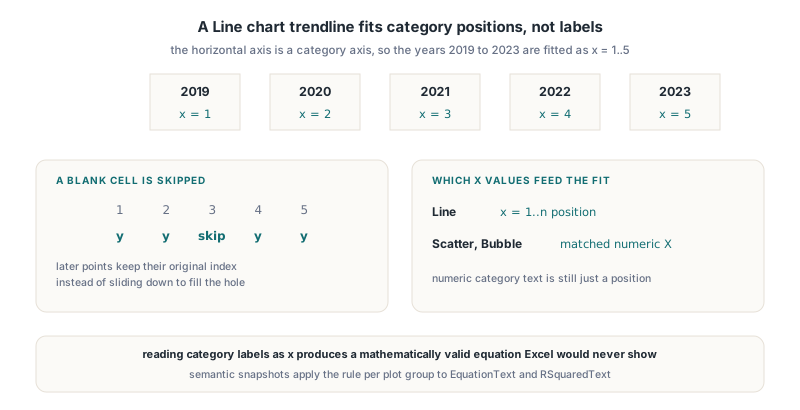
Eine Trendline an einem gewöhnlichen Liniendiagramm passt gegen die 1-basierte Kategorieposition an, nicht gegen das Kategorie-Label, selbst wenn die Labels Zahlen sind. Excel behandelt die horizontale Achse eines Liniendiagramms als Kategorieachse, also wird eine Serie über die Jahre 2019 bis 2023 als x = 1..5 angepasst, und der Achsenschnittpunkt der Gleichung spiegelt das. Punkt- und Blasendiagramme sind anders: Sie passen gegen die abgeglichenen numerischen X-Werte jedes Punkts
HotXLS hat das auf die harte Tour gelernt. Die erste Version der semantischen Snapshot-Projektion las numerischen Kategorietext als tatsächliches x, was eine mathematisch gültige Gleichung produzierte, die Excel nie zeigen würde. Die Folgeberichtigung verlegte Line-Fits auf die ursprüngliche Kategorieposition für jede Kategorie, numerisch oder nicht, und klärte auch, was mit Lücken passiert: Eine leere Y-Zelle bleibt aus dem Fit heraus, aber spätere Punkte behalten ihren ursprünglichen Index, statt nach unten zu rutschen, um das Loch zu füllen. Dieselbe Unterscheidung zwischen Kategoriepositionen und echten Werten steckt hinter den kalendergenauen Datumsachsen-Ticks in HotXLS-Charts
uses
  Math, lxStandard, lxHandleX;

// Values hält eine Line-Serie in Kategorie-Reihenfolge; NaN markiert eine leere Zelle
function LinePointsFromCategories(const Values: array of Double):
  TArray<TXLSTrendlineLabelPoint>;
var
  I, N: Integer;
begin
  SetLength(Result, Length(Values));
  N := 0;
  for I := 0 to High(Values) do
  begin
    if IsNan(Values[I]) then
      Continue;                  // die Leere überspringen, spätere Indizes halten
    Result[N].X := I + 1;        // 1-basierte Kategorieposition
    Result[N].Y := Values[I];
    Inc(N);
  end;
  SetLength(Result, N);
end;
Diesen Schritt falsch zu machen verschenkt jede andere Konvention dieses Artikels, denn das Label ist dann korrekt formatierter Text für die falsche Regression. Die Arbeitsmappen-semantischen Snapshots in HotXLS wenden die Regel bereits pro Plot-Gruppe an, wenn sie die Eigenschaften EquationText und RSquaredText emittieren, also trägt ein Snapshot eines importierten Diagramms den Labeltext, den Excel zeigen würde, nebst dem Rest des bewahrten ChartML für importierte Excel-Diagramme
Wann gibt XLSTrendlineEquationLabel False zurück?
XLSTrendlineEquationLabel gibt False zurück und lässt beide Strings leer, wann immer der Fit undefiniert ist, statt ein partielles oder geratenes Label zu veröffentlichen. Die Funktion emittiert nie eine halbe Gleichung, ein True-Ergebnis bedeutet also stets, dass beide angeforderten Strings vollständig sind
- Weniger als zwei Punkte, eine Trend-Art außerhalb 0..5 oder eine Polynomordnung außerhalb 2..6
- Ein nicht positiver X für logarithmische oder Potenz-Fits, oder ein nicht positives Y für exponentielle oder Potenz-Fits, da beide einen Logarithmus brauchen
- NaN- oder unendliche Eingaben, oder beliebiges X, Y oder ein Achsenschnittpunkt mit Magnitude über 1E50
- Zu wenige Punkte für die Polynomordnung, alle X-Werte gleich bei einem Nicht-Polynom-Fit ohne festen Achsenschnittpunkt, oder ein singuläres polynomial System
- Angepasste Werte, die den endlichen Bereich verlassen (über 1E100), oder Exponenten, die überlaufen würden
Moving Average ist die absichtliche Ausnahme. Excel legt keine Gleichungs- oder R²-Texte für eine Moving-Average-Trendline offen, selbst wenn die gespeicherten Schalter dispEq und dispRSqr an sind, also gibt die Funktion True mit beiden Strings leer zurück, was dem Aufrufer korrekt sagt, dass es nichts zu zeichnen gibt
Numerische Stabilität und aktuelle Grenzen
Polynomiale Trendlines sind der Ort, an dem naiver Code Ziffern verliert. Rohe Normalgleichungen für einen Fit sechster Ordnung über X-Werte in den Tausendern sind schlecht konditioniert, also zentriert und skaliert HotXLS X, bevor es das System aufbaut, löst es mit Gauss-Jordan-Elimination und partieller Pivotisierung und expandiert die Koeffizienten erst danach zurück auf die ursprüngliche Variable. Lineare Fits und die R²-Korrelation verwenden aus demselben Grund inkrementelle Mittelwert- und Varianzakkumulation, und ein Achsenschnittpunkt, der gegenüber den Daten bloß Gleitkomma-Rauschen ist, wird auf null gesnappt, damit das Label nicht in + 4E-17 endet
Die ehrlichen Grenzen liegen in der Formatierung. Die Funktion produziert Excels Standard-Labelzahlen; ein benutzerdefiniertes LabelNumberFormat am Trendline-Label wird von TXLSXChartTrendline persistiert, aber nicht auf den berechneten Text angewendet. Hochgestellte Exponentenformatierung im gerenderten Output und automatische Labelplatzierung sind separates Werk, und Fits sehr hohen Grades über Daten mit großem Offset oder nahe Kolinearität können weiterhin als singulär abgewiesen statt gelöst werden. Für eine Bibliothek, die mit Excel übereinstimmen will, ist die Weigerung der sicherere Fehlschlag
FAQ
Speichert die XLSX-Datei den Trendline-Gleichungstext?
Nein. Das c:trendline-Element speichert den Fit-Typ, Ordnung oder Periode, den optionalen Achsenschnittpunkt, Forecasts und die Schalter c:dispEq und c:dispRSqr, und c:trendlineLbl speichert Label-Layout und -Formatierung. Excel berechnet den Gleichungs- und R²-Text zur Render-Zeit, weshalb HotXLS ihn mit XLSTrendlineEquationLabel berechnet
Warum zeigt das polynomial Label x2 statt eines hochgestellten Zeichens?
Weil genau das in Excels DataLabel.Text steht. Der Exponent ist eine schlichte Ziffer im String, und Excel wendet die hochgestellte Formatierung an, wenn es das Diagramm zeichnet. Das Zeichen U+00B2 erscheint nur im Präfix R² = der R²-Zeile
Kann ich Labels für Diagramme berechnen, die mit der klassischen XLS-Engine gebaut wurden?
XLSTrendlineEquationLabel lebt in lxStandard und wird von beiden HotXLS-Engines geteilt, es funktioniert also mit jeder Punktmenge, die Sie extrahieren können. Die automatische Projektion des Labeltexts in semantische Snapshots deckt derzeit OOXML-Charts ab; für andere Quellen bauen Sie das TXLSTrendlineLabelPoint-Array selbst und folgen der Kategoriepositions-Regel für Liniendiagramme
Trendline-Label-Berechnung, Diagramm-Authoring und der Rest des Excel-Objektmodells kommen in HotXLS, der nativen Delphi-Spreadsheet-Komponente für XLS und XLSX, ohne dass zur Laufzeit eine Excel-Installation nötig ist