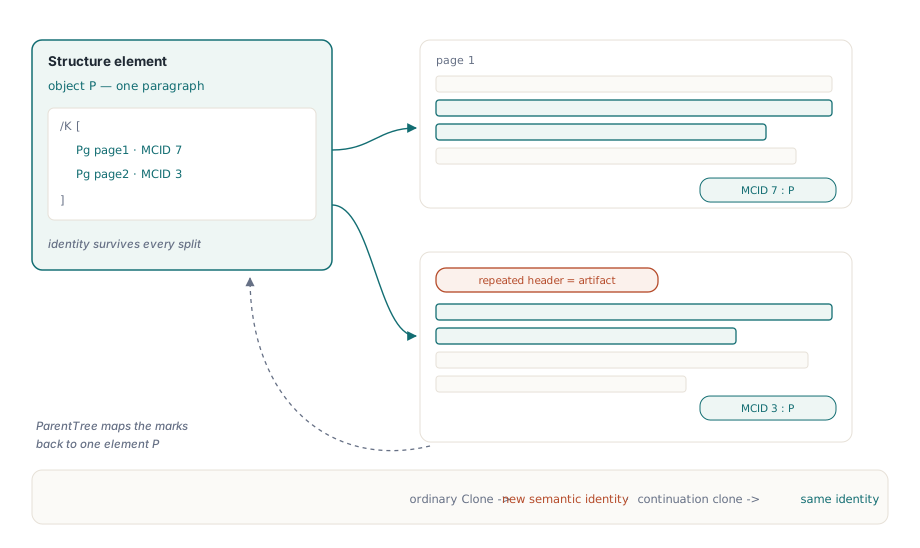
Ein Absatz, der unten auf Seite 4 beginnt und oben auf Seite 5 endet, ist für die lesende Person ein einzelner Absatz. In einem getaggten PDF lebt er in zwei Content-Streams, und jede Seite nummeriert ihre Marked-Content-Sequenzen für sich, sodass der Strukturbaum ein einziges P-Element braucht, dessen /K-Array etwa auf MCID 7 auf Seite 4 und MCID 3 auf Seite 5 zeigt. Zeichnet man die Seiten mit Koordinatencode und settelt das Tagging hinterher an, zeigt der Tag-Baum in einem Accessibility-Checker typischerweise zwei Absätze, wo einer war, dazu einen Satz von Spaltentiteln, der in den Daten jeder fortgesetzten Tabelle wiederholt wird
Der Koordinatenansatz hat eine zweite Kostenart, die früher zuschlägt. Die erste Version eines Berichts funktioniert. Dann wächst eine Kundenadresse auf drei Zeilen, eine lokalisierte Überschrift bricht um, eine Tabelle gewinnt vierzig Zeilen, und jede y-Position unterhalb dieses Punkts ist falsch. Seitenumbruch-Prüfungen landen verstreut in der Geschäftslogik, und Code, der nur je nach x und y kannte, weiß nicht, wo ein Absatz beginnt, wenn die Barrierefreiheits-Anforderung zwei Jahre später auftaucht
Einen HotPDF-Layoutbaum in Delphi aufbauen
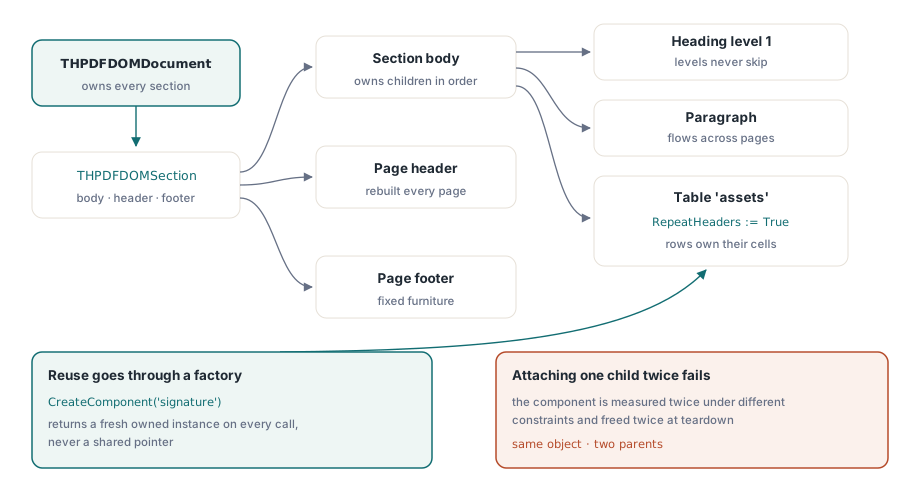
HotPDF beantwortet beide Probleme mit einem deklarativen Layoutbaum in der Unit HPDFLayoutDOM. Ein THPDFDOMDocument hält Abschnitte; jeder THPDFDOMSection hat eine Seitengröße, Ränder, einen optionalen Header und Footer und einen Body-Stapel, in den man Text, Überschriften, Abstandshalter, Listen, Bilder, Container und Tabellen legt. Nichts im Baum trägt eine y-Koordinate. THPDFDOMRenderer vermisst den Baum, entscheidet die Seitenumbrüche, zeichnet Header und Footer auf jeder Seite und schreibt, weil GenerateStructure standardmäßig True ist, den Strukturbaum gleich mit
Der Besitz im Baum ist strikt. Das Dokument besitzt seine Abschnitte, ein Abschnitt besitzt seinen Body, Header und Footer, und Stapel, Container und Tabellen besitzen ihre Kinder, daher übergibt Section.Body.Add(Table) die Tabelle endgültig. Eine Komponente, die an zwei Eltern hinge, würde unter unterschiedlichen Einschränkungen zweimal vermessen und beim Abbau zweimal freigegeben. Wiederkehrende Teile wie ein Unterschriftenblock kommen deshalb aus Clone, aus SetHeaderClone / SetFooterClone oder aus einer bei RegisterComponent registrierten Factory, womit jeder CreateComponent('signature')-Aufruf eine frische Instanz zurückgibt
uses
  SysUtils, HPDFDoc, HPDFLayoutDOM;

type
  TAssetRow = record                    // eigener Datentyp
    Name, ServiceDate, Status: WideString;
  end;

function BuildMaintenanceReport(const Assets: array of TAssetRow): THPDFDOMDocument;
var
  Doc: THPDFDOMDocument;
  Section: THPDFDOMSection;
  Heading: THPDFDOMText;
  Table: THPDFDOMTable;
  Row: THPDFDOMTableRow;
  I: Integer;
begin
  Doc := THPDFDOMDocument.Create;       // GenerateStructure = True, Language = 'en-US'
  try
    Section := Doc.AddSection;          // A4 hoch, 36 pt Ränder als Vorgabe
    Section.MarginLeft := 56;
    Section.MarginRight := 56;
    Section.Style.FontName := 'Helvetica';
    Section.Style.FontSize := 10;
    Section.Style.LineHeight := 13;
    Section.Body.Style.Spacing := 6;    // Abstand zwischen Body-Kindern
    Section.Footer := THPDFDOMText.Create('Plant maintenance - internal');

    Heading := Section.Body.AddHeading('Annual maintenance report', 1);
    Heading.Style.FontSize := 18;
    Heading.Style.LineHeight := 22;     // LineHeight richtet sich nicht nach FontSize
    Section.Body.AddText('Every asset inspected during the reporting ' +
      'period is listed below, grouped by site.');

    Table := THPDFDOMTable.Create('assets');  // RepeatHeaders ist standardmäßig True
    Table.AddColumn(3);                 // Gewichtungen, keine Breiten in Punkt
    Table.AddColumn(1);
    Table.AddColumn(1);
    Row := Table.AddRow(18, True);      // Kopfzeilen müssen zuerst kommen
    Row[0].Text := 'Asset';
    Row[1].Text := 'Last service';
    Row[2].Text := 'Status';
    for I := 0 to High(Assets) do
    begin
      Row := Table.AddRow(16);
      Row[0].Text := Assets[I].Name;
      Row[1].Text := Assets[I].ServiceDate;
      Row[2].Text := Assets[I].Status;
    end;
    Section.Body.Add(Table);            // der Body besitzt die Tabelle ab hier
    Result := Doc;
  except
    Doc.Free;
    raise;
  end;
end;
Zwei Vorgaben in diesem Listing sind Stolperfallen. LineHeight löst sich zu 12 Punkten auf, sofern kein Style in der Kette ihn setzt, egal was FontSize sagt, also bekommt eine 18-pt-Überschrift ohne eigenes LineHeight 12-pt-Zeilen und überlappt die nächste. Und eine Tabellenzeile ist genau so hoch wie die Höhe, die an AddRow übergeben wird: Zelltext kommt auf eine Zeile heraus, also bemessen Sie die Zeilen für die Schrift, die Sie gewählt haben
Render öffnet und schließt das Dokument selbst
THPDFDOMRenderer.Render(Doc, Pdf) ruft BeginDoc am Ziel auf, rendert jeden Abschnitt und ruft EndDoc, bevor es zurückkehrt. Wickeln Sie es nicht in ein eigenes BeginDoc / EndDoc-Paar ein. Alles, was vor dem Dokumentstart gesetzt sein muss, kommt zuerst auf die THotPDF-Instanz: FileName, Title und, wenn die Ausgabe PDF/UA beanspruchen soll, PDFUACompliance. Bei eingeschalteter Strukturgenerierung schaltet Render außerdem EnableTaggedPDF ein und kopiert Doc.Language nach Pdf.Lang, falls man es leer gelassen hat
var
  Doc: THPDFDOMDocument;
  Pdf: THotPDF;
  Renderer: THPDFDOMRenderer;
  Stats: THPDFDOMRenderStatistics;
begin
  Doc := BuildMaintenanceReport(Assets);
  Pdf := THotPDF.Create(nil);
  Renderer := THPDFDOMRenderer.Create;
  try
    Pdf.FileName := 'maintenance-report.pdf';
    Pdf.Title := 'Annual maintenance report';
    Pdf.PDFUACompliance := True;        // aktiviert auch die Prüfung des Figuren-Alt-Texts
    // Kein BeginDoc / EndDoc hier: Render öffnet und schließt das Dokument
    Stats := Renderer.Render(Doc, Pdf);

    Writeln(Format('%d page(s), %d placement(s), %d split(s)',
      [Stats.PageCount, Stats.PlacementCount, Stats.SplitCount]));
    Writeln(Format('structure elements=%d marked content=%d artifacts=%d',
      [Stats.StructureElementCount, Stats.MarkedContentCount,
       Stats.ArtifactCount]));
    Writeln(Format('header draws=%d footer draws=%d deepest chain=%d',
      [Stats.HeaderDrawCount, Stats.FooterDrawCount,
       Stats.MaximumContinuationDepth]));
  finally
    Renderer.Free;
    Doc.Free;
    Pdf.Free;
  end;
end;
Protokollieren Sie den Statistikdatensatz bei jedem Lauf, denn er zeigt Vorlagen-Regressionen, die nie eine Exception auslösen. Ein springender SplitCount nach einer Vorlagenänderung bedeutet meist, dass eine Komponente nun höher misst als der Platz, in den sie früher passte. Ein schleichend wachsender MaximumContinuationDepth zeigt auf eine Komponente, deren Split zu wenig Inhalt pro Seite weiterreicht. ArtifactCount umfasst Seitenköpfe und -füße, dekorative Rahmen wie den voreingestellten 0,5-pt-Rahmen der Tabelle und wiederholte Kopfzeilen; vergleichen Sie ihn also zwischen Läufen derselben Vorlage statt gegen ein handgerechnetes Ziel
Wie paginiert eine lange Tabelle, ohne sich auf jeder Seite selbst zu kopieren?
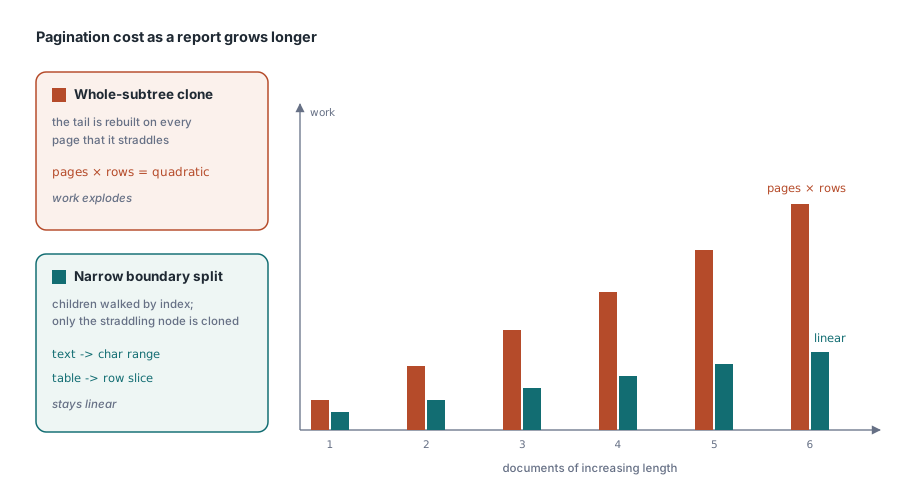
Der Renderer splittet nur, was über die Seitengrenze hinausragt. Die naive Art, einen Baum zu paginieren, besteht darin, alles zu klonen, was nicht passte, und die Kopie auf die nächste Seite zu tragen; bei einer Tabelle mit 10.000 Zeilen klont das die verbleibenden Zeilen einmal pro Seite und macht aus einem linearen Job einen quadratischen. HotPDF geht die Body-Kinder nach Index durch und klont niemals einen ganzen Abschnitt oder Body. Ein verschachtelter Stapel oder Container, der eine Seitengrenze kreuzt, bekommt nur seinen betroffenen Teilbaum geklont, und die beiden schwergewichtigen Blatttypen tragen einen Cursor statt einer Kopie
Ein fortgesetzter Absatz ist eine Referenz auf den Originaltext plus den Zeichenbereich, den er noch schuldet, und er nutzt die Zeilenumbrüche wieder, die bereits für diese Breite berechnet wurden. Eine fortgesetzte Tabelle ist eine Referenz auf die Originaltabelle plus die Scheibe von Zeilen, die noch zu platzieren sind. Ein Absatz mit 300 Zeilen kostet gleich viel, ob er einmal oder fünfmal umbricht
Die Platzierung selbst läuft über die öffentliche Routine THotPDF.PlaceLayoutElement. Sie vermisst das Element gegen die verbleibende Body-Höhe, zeichnet es ganz, wenn es passt, und fordert sonst ein Split, vermisst die platzierte Hälfte erneut, zeichnet sie und gibt den Rest als Overflow-Objekt zurück, das der Renderer auf eine frische Seite trägt. Measure darf niemals etwas zeichnen; es kann für eine Platzierung mehrfach laufen. Der DOM-Renderer setzt Seitenrahmenelemente, Abstände zwischen Kindern und Entscheidungen über neue Seiten oben auf diese Routine
Warum kann eine einzelne Kopfzeile den gesamten Render anhalten?
Wiederholte Tabellenköpfe tragen zwei Regeln, und beide existieren, damit ein Bericht keine Seiten ohne Daten erzeugt. Kopfzeilen müssen den ersten Lauf von Zeilen bilden: AddRow(Height, True) nach einer Body-Zeile löst EInvalidOpException mit „Table header rows must precede body rows“ aus. Und der erste Split einer Tabelle muss jede Kopfzeile plus mindestens eine Body-Zeile unterbringen. Eine Tabelle, die den Kopf am Fuß einer Seite stranden ließe, rückt stattdessen auf die nächste Seite
Die zweite Regel hat eine harte Kante. Passen die Kopfzeilen plus eine Body-Zeile nicht einmal auf eine leere Seite, gibt es keine Seite, auf der die Tabelle beginnen könnte, und Render wirft „Layout component ... cannot fit an empty body page“ mit dem Komponentenpfad, etwa Sections[0]/Body/Items[2]/assets. Das ist das Verhalten, das man haben will. Eine Layout-Engine, die weiter Seiten hinzufügt in der Hoffnung, die nächste wäre geräumiger, macht aus einem überdimensionierten Kopf eine festplattenfüllende Schleife
Benutzerdefinierte Komponenten bekommen denselben Schutz. Man leitet THPDFDOMComponent ab, implementiert Clone, Measure, Draw und Split, und der Renderer zählt, wie viele Fortsetzungen jedes Body-Kind erzeugt. Oberhalb von THPDFDOMRenderer.MaximumContinuationDepth (standardmäßig 100.000) stoppt das Rendern mit „exceeded the continuation depth limit“. Ein Split, der immer einen gleichwertigen Rest zurückgibt und daher keinen Fortschritt macht, scheitert mit einem Komponentenpfad, statt zu laufen, bis die Festplatte voll ist
Auf Fortsetzungsseiten werden die Kopfzeilen erneut gezeichnet, innerhalb einer /Artifact-Marked-Content-Sequenz, und der Strukturbaum behält das ursprüngliche TR genau einmal. Die Textextraktion fügt daher keine doppelte Kopfzeile zwischen Datenzeilen ein, und Assistenztechnik verkündet die Spaltentitel nicht erneut mitten in der Tabelle. Jede Kopfzelle ist als TH mit einem /Scope /Column-Attribut getaggt
Ein logischer Absatz, mehrere Seitenfragmente
Ein geteilter Absatz bleibt ein P-Strukturelement. Jedes sichtbare Fragment öffnet eine neue Marked-Content-Sequenz auf seiner eigenen Seite, und HotPDF hängt ein Marked-Content-Referenzwörterbuch, << /Type /MCR /Pg page /MCID n >>, an das /K-Array dieses Elements an und registriert die MCID im ParentTree-Eintrag der Seite mit Rückverweis auf dasselbe Element. Das ist die Anordnung, die ISO 32000-1 §14.7.4 für Inhaltselemente beschreibt, die sich über Seiten verteilen, und sie ist der Grund, warum eine Tag-Baum-Ansicht einen Absatz zeigt, wo die Seiten zwei Stücke zeigen
Semantische Identität ist der Grund, warum Fortsetzungskopien sich anders verhalten als eigene Klone. Ein Clone-Aufruf bedeutet „neuen logischen Inhalt“, und das Ergebnis bekommt beim Zeichnen ein neues Strukturelement. Die Kopien, die während der Paginierung entstehen, erben die Identität der Komponente, die sie fortsetzen, sodass ein über drei Seiten geteilter Stapel weiterhin ein Div liefert und eine über zwei Seiten geteilte Liste weiterhin ein L. Seitenköpfe und -füße nehmen einen anderen Weg: Sie werden auf jeder Seite als /Artifact << /Type /Pagination /Subtype /Header >> (oder /Footer) verpackt und betreten den Strukturbaum nie
Strukturregeln, die beim Rendern des Baums geprüft werden
Mit GenerateStructure an verweigert der Renderer Struktur, die eine PDF/UA-Validierung später zurückweisen würde. Die erste Überschrift muss H1 sein, und spätere Überschriften dürfen keine Ebene überspringen, sodass ein H3 direkt nach einem H1 „Semantic heading levels cannot skip an intermediate level“ wirft. LI braucht einen L-Elternknoten, Lbl und LBody brauchen ein LI, TR braucht eine Tabelle oder Zeilengruppe, und TH / TD brauchen ein TR. Wenn das Ziel PDFUACompliance gesetzt hat, wird auch ein Figure ohne Alternativtext zurückgewiesen. Jede Verletzung stoppt Render mit einer Exception
var
  List: THPDFDOMList;
  Bmp: TBitmap;                         // Vcl.Graphics
begin
  Section.Body.AddHeading('Findings', 2);     // H1 kam zuerst, H2 ist also legal

  List := THPDFDOMList.Create('Decimal');     // als L getaggt, ListNumbering /Decimal
  List.AddItem('1.', 'Replace the intake filter on pump P-14');
  List.AddItem('2.', 'Re-torque the flange bolts on line 3');
  Section.Body.Add(List);                     // AddItem erzeugt LI, Lbl und LBody

  Bmp := TBitmap.Create;
  try
    Bmp.LoadFromFile('site-plan.bmp');
    // Das Bild kopiert die Grafik; leerer Alt-Text scheitert unter PDFUACompliance
    Section.Body.Add(THPDFDOMImage.Create(Bmp, 240, 160,
      'Site plan of plant 3 with the inspected pumps circled'));
  finally
    Bmp.Free;
  end;
end;
Die Prüfung während des Renderns ist der richtige Ort für diese Regeln. Das Timing ist der Grund. Ein Validator, der einen fehlenden Alternativtext meldet, nachdem die Datei geschrieben wurde, sagt einem, dass eine Charge von 10.000 Belegen neu erzeugt werden muss; eine Exception während Render nennt die Regel, die scheiterte, während der Datensatz, der sie erzeugte, noch im Gültigkeitsbereich liegt. Formale Konformitätsprüfung gehört weiterhin in die Pipeline, und weil die Objekte des Dokuments nach der Rückkehr von Render lesbar bleiben, kann sie sofort laufen. PDF/A-, PDF/X- und PDF/UA-Validierung behandelt diesen Schritt, und Strukturreihenfolge und Textextraktion zeigt, wie der Tag-Baum steuert, was Extraktionstools zurücklesen
Wann man besser von Hand zeichnet
Der Baum zeichnet auf dieselben THPDFPage-Objekte wie die direkte API. Weil Render das Dokument von BeginDoc bis EndDoc besitzt, gehört handplatzierte Grafik wie ein Unterschriftsbild in den Baum: Das Draw einer benutzerdefinierten Komponente erhält die Seite und ihre Grenzen und kann dort die gewöhnlichen Seitenmethoden aufrufen. Der Seitenabschluss bleibt bei AddPage und EndDoc, daher werden mit gesetztem ImmediateFlushLayout auf der THotPDF-Instanz fertige Seiten geschrieben, während das Rendern läuft, und der Renderer hält keine abgeschlossenen Seiten; der Speicher hängt dann an den offenen Fortsetzungen, den Schriftressourcen und dem Objektgraphen des Dokuments
Die DOM-Textkomponente bricht Zeilen nach einem geschätzten mittleren Vorschub von 0,55 × Schriftgröße pro Zeichen und gibt jeder Zeile das aufgelöste LineHeight. Das hält die Vermessung billig und auf jeder Maschine gleich, und für datengetriebene Berichte reicht es locker. Text mit breiten Glyphen, etwa Kapitälchen, fette Passagen oder CJK, kommt breiter heraus als geschätzt, also lassen Sie in diesen Spaltenbreiten Spielraum und testen Sie das Layout einmal mit dem längsten realen String. Gesetzte Seiten mit exakten Glyphenmetriken, mehreren Schriften in einer Zeile oder Blocksatz sind besser bei der direkten Text-API aufgehoben; Textausrichtung geht diesen Weg durch, und wenn nur die Tabellenpaginierung schmerzt, ist Tabellen in PDF erzeugen die kleinere Änderung
Der Layoutbaum, sein Renderer, das hier beschriebene Tagging und die direkte Zeichen-API liegen in einer Komponente für Delphi und C++Builder; Editionen und die vollständige Funktionsliste finden sich auf der HotPDF-Delphi-PDF-Komponentenseite