Ein CMYK-JPEG, das mit matschigen, verschobenen oder negativen Farben aus einem PDF herauskommt, bedeutet fast immer, dass der Dekodierer eine von zwei Tatsachen verkehrt verstanden hat: ob die Samples als YCCK gespeichert wurden und konvertiert werden müssen, oder ob sie nach Adobe-Konvention invertiert gespeichert wurden. HotPDFs Dekodierer beachten den DCTDecode-/ColorTransform-Parameter für Drei- und Vierkanal-Bilder, weisen Werte ab, die die Spezifikation nicht definiert, und lassen einen Adobe-APP14-Marker in den JPEG-Daten Vorrang vor dem Dictionary-Eintrag haben, wie ISO 32000-1 Table 13 es verlangt. Zwei Nachbarregeln gehören zur selben Fallenfamilie: Multi-Filter-Streams müssen stufenbezogene /DecodeParms-Arrays tragen, und JPEG-2000-Bilder behalten ein explizites /Decode-Mapping
Alle drei teilen ein Thema. Das PDF sagt bereits, was es meint, und die Falle ist ein Renderer, der eine leicht andere Frage beantwortet
Warum rendert ein CMYK-JPEG in einem PDF invertiert oder blass?
Ein CMYK-JPEG gerät in einem PDF aus einem von zwei Gründen schief, und beide sehen auf dem Bildschirm verschieden aus. Ein Negativbild, in dem weißes Papier schwarz wird und helle Töne dunkel, zeigt auf invertierte Speicherung. Ein blasses oder im Farbton verschobenes Bild, in dem Haut grün wird und Schwarz grau, während das K-Detail scharf bleibt, zeigt auf eine Farbtransformation, angewendet, obwohl sie nicht hätte angewendet werden dürfen, oder übersprungen, obwohl sie nötig war
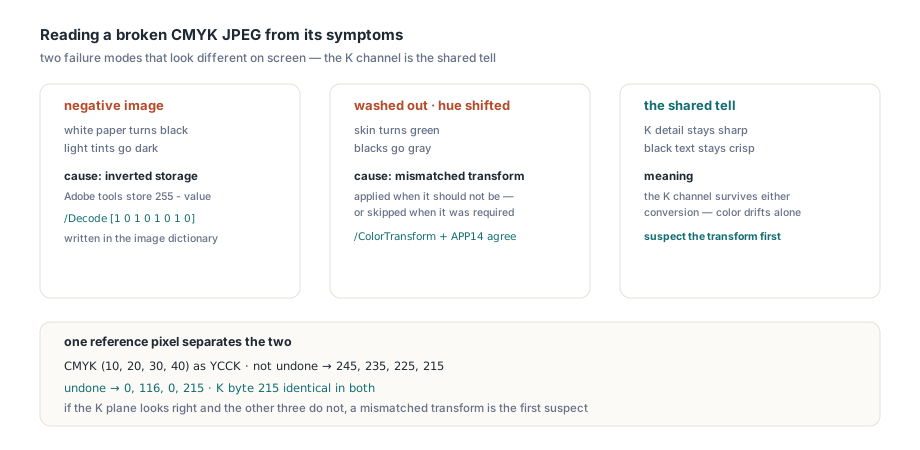
Das Transformationsproblem kommt daher, wie JPEG Farbe komprimiert. Baseline-JPEG komprimiert am besten, wenn Luminanz von Chrominanz getrennt ist, also konvertieren Encoder üblicherweise RGB vor der Kompression nach YCbCr, und Vierkanal-Encoder konvertieren CMY nach YCC, während K unangetastet durchgereicht wird, was das Format namens YCCK ergibt. Der Dekodierer muss exakt die Konversion rückgängig machen, die der Encoder angewendet hat. Ehe rückgängig machen, die nie stattfand, oder eine überspringen, die stattfand, und jedes Pixel wandert. Der Schwarzkanal überlebt beides, weshalb ein kaputtes CMYK-Bild oft knackscharfen schwarzen Text behält, während alles andere driftet
Das Inversionsproblem ist historisch. Photoshop und andere Adobe-Werkzeuge schreiben CMYK-JPEGs mit jedem Sample als 255 - value gespeichert und markieren die Datei mit einem Adobe-APP14-Marker. Nichts im JPEG-Standard sagt das; es ist eine Konvention, und jeder Consumer muss sie kennen. In einem PDF wird vom Erzeuger erwartet, dass er die Inversion im Image-Dictionary ausdrückt, statt sie zum Raten freizugeben
Was sagt /ColorTransform dem Dekodierer?
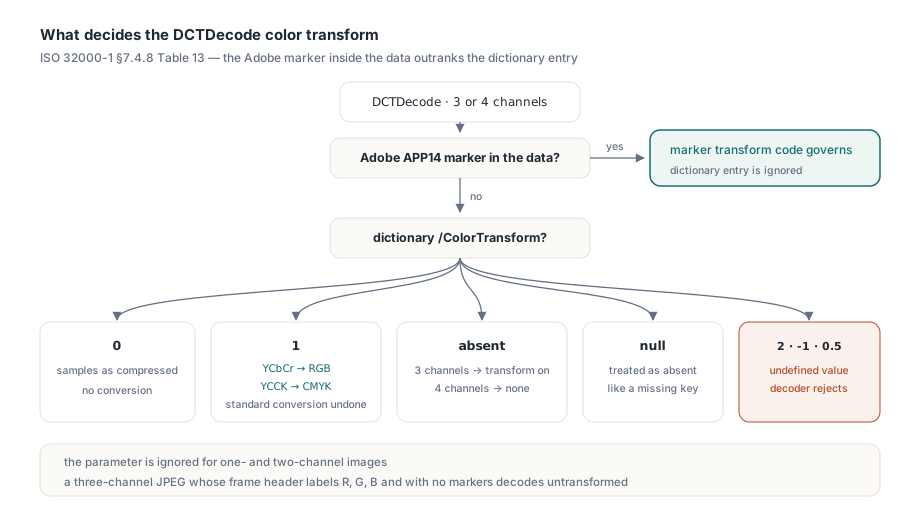
/ColorTransform ist die Aussage auf PDF-Ebene, welche Konversion der Dekodierer rückgängig machen muss. ISO 32000-1 §7.4.8, Table 13, definiert zwei Werte. Null heißt keine Transformation: Der Dekodierer liefert die Samples, wie komprimiert. Eins heißt, der Encoder hat die Standardkonversion angewendet, also geht ein Dreikanal-Bild von YCbCr zurück nach RGB und ein Vierkanal-Bild von YCCK zurück nach CMYK. Der Parameter wird bei Ein- und Zweikanal-Bildern ignoriert. Table 13 legt zudem eine Vorrangsregel fest, die leicht übersehen wird: Trägt die kodierten Daten einen Adobe-Marker mit eigenem Transform-Code, herrscht jener Code, und der Dictionary-Eintrag wird ignoriert. Nur ein JPEG ohne jenen Marker fällt aufs Dictionary zurück, und wenn auch der Eintrag fehlt, defaultet ein Dreikanal-Bild auf die Transformation und ein Vierkanal-Bild auf keine
Der einfache Fehler ist ein Bildpfad, der das Parameter-Dictionary entgegennimmt, es aber nie an den JPEG-Dekodierer weiterreicht. Ein Ein-Pixel-RGB-JPEG mit der Farbe (128, 63, 31) legt ihn sofort offen: Ein solcher Dekodierer liefert [128, 63, 31] für sowohl /ColorTransform 0 als auch /ColorTransform 1, während die richtige Antwort für null das rohe YCbCr-Tripel [79, 101, 163] ist
HotPDF wendet den Parameter auf Byte-Ebene an. HPDFDecodeHeadlessTerminalImage geht zuerst die JPEG-Segmentstruktur bis zum Start-of-Scan-Marker durch und sucht nach einem Adobe-APP14-Segment; Bytes, die bloß einem ähneln, innerhalb eines Kommentar-Segments zählen nicht. Trägt der Datenbestand den Marker, entscheidet sein Transform-Code, und der Dictionary-Wert wird ignoriert. Tut er es nicht, baut der Dekodierer eine private Kopie des JPEG mit einem APP14-Segment, eingefügt direkt vor dem Start-of-Scan-Marker, mit Transform-Code 0, 1 oder, bei einem Vierkanal-Bild mit Wert 1, dem YCCK-Code 2. Wann immer die effektive Transformation eines Dreikanal-Bildes 0 ist, entschärft die Kopie zusätzlich den JFIF-Header, denn ein JFIF-Header allein sagt libjpeg-turbo, YCbCr anzunehmen. Der Buffer des Aufrufers wird nie angefasst, und wenn ein Segment eingefügt wird, werden seine 16 Extra-Bytes auf das Working-Byte-Budget angerechnet, bevor der Dekodierer irgendetwas allokiert
Nur dann einzufügen, wenn kein Marker existiert, ist wegen eines libjpeg-Details wichtig: Es verwendet das letzte APP14-Segment, das es sieht. Ein Segment hinter einem bestehenden Marker einzufügen lässt einen expliziten Dictionary-Wert stillschweigend einen widersprüchlichen Marker in den Daten überstimmen, was genau verkehrt herum zu Table 13 ist. HotPDF wendet die Table-13-Ordnung auf dem Pfad für komplette Image-XObjects und auf dem Inline-Image-Pfad gleichermaßen an
Denselben Terminal-Dekodierer kannst du direkt aufrufen, wenn ein einzelnes Bild falsch aussieht und du seine Samples sehen willst, ohne die Seite zu rendern. Die Funktion liegt in der Unit HPDFHeadlessImageCodecs, nimmt den Filternamen, die kodierten Bytes, ein optionales Parameter-Dictionary und die Geometrie aus dem Image-Dictionary, die zum JPEG-Frame-Header passen muss
uses
  SysUtils, HPDFObjs, HPDFHeadlessImageCodecs;

// ColorTransform < 0 heißt "Eintrag fehlt": die JPEG-Marker entscheiden lassen
function DecodeDCT(const Encoded: TBytes; Width, Height, Channels,
  ColorTransform: Integer): TBytes;
var
  Parms: THPDFDictionaryObject;
begin
  Parms := nil;
  if ColorTransform >= 0 then
  begin
    Parms := THPDFDictionaryObject.Create(nil);
    Parms.AddNumericValue('ColorTransform', ColorTransform);
  end;
  try
    Result := HPDFDecodeHeadlessTerminalImage('DCTDecode', Encoded, nil, Parms,
      Width, Height, Channels, 8, 64 * 1024 * 1024, nil);
  finally
    Parms.Free;
  end;
end;
Der Dekodierer ist streng, was als legaler Wert zählt. Ein explizites -1, ein 2 oder ein Nicht-Integer wie 0.5 wirft EHPDFHeadlessImageError, statt auf einen Default zurückzufallen, denn ein Wert, den die Spezifikation nicht definiert, gibt dem Dekodierer nichts Verlässliches, worauf er sich stützen könnte. Die Prüfung bleibt bestehen, selbst wenn ein Adobe-Marker in den Daten den Eintrag irrelevant macht, denn ein undefinierter Wert ist ein struktureller Fehler im Dokument selbst. Ein zu kleines Budget für die transformierte Kopie scheitert genauso, mit einer Meldung, die das Working-Byte-Budget benennt
Ein explizites null ist ein anderer Fall, denn es ist überhaupt kein Wert. ISO 32000-1 §7.3.9 sagt, ein Dictionary-Eintrag mit Wert null ist äquivalent zu einem fehlenden Eintrag, also fällt /ColorTransform null zum Marker oder zum Komponentenzahl-Default durch, exakt so, als fehlte der Schlüssel. HotPDF behandelt es auf jedem Pfad so, headless wie VCL, Stream wie Inline
Noch ein Default verdient eine Erwähnung, denn hier geht HotPDF bewusst über den Buchstaben von Table 13 hinaus. Ein JPEG mit drei Komponenten, weder mit JFIF-Header noch mit Adobe-Marker, dessen Frame-Header seine Komponenten R, G und B benennt, sagt in seinen eigenen Bytes, dass es RGB enthält. Table 13 würde es weiterhin auf die Transformation defaulten, aber libjpeg und die darauf gebauten Reader dekodieren es untransformiert, und HotPDF genauso. Die Headless- und VCL-Dekodierer behandeln es beide so, Rot und Blau bleiben also, wo die Daten sie hinlegten. Ein explizites Dictionary-0 oder 1 übersteuert diesen Schluss weiterhin
uses
  System.IOUtils;

var
  Jpeg, Stored, Converted, ByMarkers: TBytes;
begin
  // rohe DCTDecode-Bytes eines 640 x 480 CMYK-Bildes, gesichert aus dem PDF-Stream
  Jpeg := TFile.ReadAllBytes('suspect-image.jpg');
  try
    // Mit einem Adobe-APP14-Marker in den Daten sind sich alle drei Aufrufe einig:
    // der Marker entscheidet, und der Dictionary-Wert wird ignoriert
    Stored    := DecodeDCT(Jpeg, 640, 480, 4, 0);   // ohne Marker: Samples, wie komprimiert
    Converted := DecodeDCT(Jpeg, 640, 480, 4, 1);   // ohne Marker: YCCK nach CMYK zurückgeführt
    ByMarkers := DecodeDCT(Jpeg, 640, 480, 4, -1);  // ohne Marker: Vierkanal-Default, keine
    Writeln(Format('pixel 0: stored %d,%d,%d,%d  converted %d,%d,%d,%d',
      [Stored[0], Stored[1], Stored[2], Stored[3],
       Converted[0], Converted[1], Converted[2], Converted[3]]));
  except
    on E: EHPDFHeadlessImageError do
      Writeln('Decoder refused the image: ', E.Message);
  end;
end;
Ein Vierkanal-Referenzpixel zeigt, worauf zu achten ist. Ein CMYK-Pixel von (10, 20, 30, 40), gespeichert als YCCK, kommt als [245, 235, 225, 215] zurück, wenn die YCCK-Konversion nicht rückgängig gemacht wurde, und als [0, 116, 0, 215], wenn doch. Das K-Byte, 215, ist in beiden identisch. Sieht die K-Ebene richtig aus und die anderen drei nicht, ist eine falsch passende Transformation der erste Verdächtige
Die invertierte CMYK-Konvention gehört zu /Decode
Der HotPDF-Terminal-Dekodierer liefert CMYK-Samples exakt so, wie libjpeg-turbo sie erzeugt, und dreht sie nicht allein auf die Autorität eines Adobe-Markers hin um. Die Zahlen oben machen die Konvention sichtbar: 245, 235, 225, 215 sind schlicht 255 minus 10, 20, 30, 40, die invertierte Form, die Adobe-artige Encoder speichern. Das zurück in Tintenmengen zu verwandeln, ist Aufgabe des Image-Dictionarys, wo ein Erzeuger, der so ein JPEG einbettet, /Decode [1 0 1 0 1 0 1 0] schreiben sollte. Der Renderer wendet das /Decode-Array auf jede Komponente an, also druckt eine korrekt geschriebene Datei korrekt
Die Kehrseite verdient es, klar gesagt zu werden. Ein PDF, das ein Adobe-invertiertes CMYK-JPEG ohne das passende /Decode-Array einbettet, rendert in HotPDF als Negativ, denn die Datei beschreibt das Bild selbst so. Manche Viewer erkennen den APP14-Marker und gleichen stillschweigend aus. HotPDF fügt diese Heuristik nicht hinzu, also gehört die Reparatur solcher Dateien in die Software, die sie schrieb
Warum ist ein DecodeParms-Dictionary für zwei Filter ein Fehler?
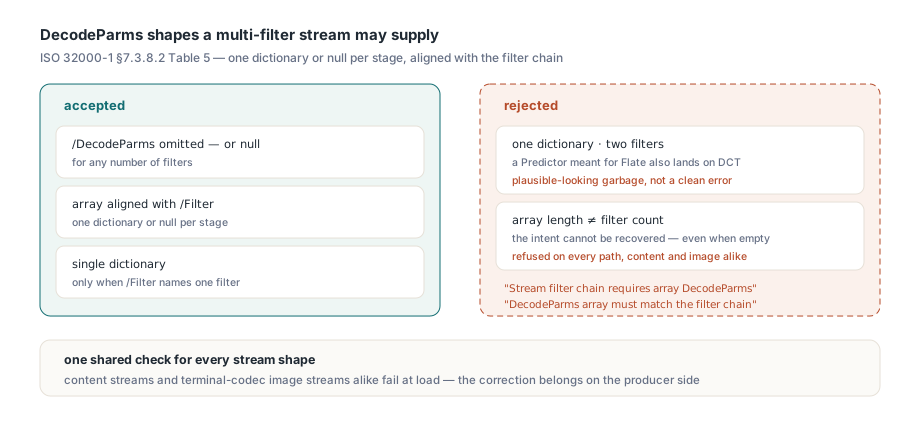
Ein Stream, dessen /Filter ein Array aus mehreren Stufen ist, muss /DecodeParms als gleichlanges Array liefern, ein Parameter-Dictionary oder null pro Stufe. ISO 32000-1 §7.3.8.2, Table 5, stellt diese Regel auf, und HotPDF setzt sie durch: Ein Multi-Filter-Stream, der ein gemeinsames Dictionary liefert, wird als ungültiges Dokument gemeldet, statt dekodiert zu werden
Die kulante Alternative ist schlimmer, als sie aussieht. Ein Dekodierer, der die Länge nur prüft, wenn /DecodeParms bereits ein Array ist, wird bei einem einzelnen Dictionary und zwei Filtern jenes Dictionary stillschweigend in jeder Stufe wiederverwenden. Harmlos, solange das Dictionary leer ist, destruktiv, wenn nicht: Ein /Predictor 12, gedacht für die innere Flate-Stufe, würde auch auf die äußere angewendet, und die Ausgabe wird zu plausibel aussehendem Datenmüll statt zu einem sauberen Fehler. Weil sich die Absicht so einer Datei nicht rekonstruieren lässt, weist HotPDF sie ab, selbst im leeren Fall, etwa bei einem Seiteninhalt-Stream mit /Filter [/FlateDecode /FlateDecode] und /DecodeParms << >>
Die akzeptierten und abgelehnten Formen lassen sich leicht aufzählen:
- Akzeptiert:
/DecodeParmsweggelassen odernull, bei beliebiger Filterzahl - Akzeptiert: ein Array, dessen Länge der Filterzahl entspricht, jeder Eintrag ein Dictionary oder
null - Akzeptiert: ein einzelnes Dictionary, wenn
/Filtergenau einen Filter nennt - Abgelehnt: ein einzelnes Dictionary, geteilt von zwei oder mehr Filtern, mit der Diagnose "Stream filter chain requires array DecodeParms"
- Abgelehnt: ein Array, dessen Länge von der Filterzahl abweicht, mit "DecodeParms array must match the filter chain"
Dieselbe Prüfung läuft für gewöhnliche Content-Streams und für Image-Streams, deren letzter Filter ein Terminal-Codec wie DCTDecode ist, also scheitert eine missgestaltete Kette an derselben Stelle, was auch immer der Stream trägt. Das Zusammenspiel mit Dekomprimierungs-Limits behandelt der Artikel zu Filterketten-Budgets und PDF-Decode-Bomben. Aus Anwendungscode tritt der Fehler auf, wenn die Seite gerendert wird
uses
  SysUtils, HPDFHeadlessDocument, HPDFHeadlessCairoDevice;

var
  Document: THPDFHeadlessDocument;
  Options: THPDFHeadlessRenderOptions;
  Info: THPDFHeadlessRenderResult;
begin
  Document := THPDFHeadlessDocument.Create;
  try
    try
      Document.LoadFromFile('catalog-cmyk.pdf');
      Options := THPDFHeadlessRenderOptions.Default;
      Info := HPDFRenderHeadlessPagePNGFile(Document.GetRenderAccess(0),
        'page1.png', Options);
      Writeln('images=', Info.Images, ' decoded bytes=', Info.DecodedBytes);
    except
      on E: Exception do
        Writeln('Rejected: ', E.ClassName, ': ', E.Message);
    end;
  finally
    Document.Free;
  end;
end;
JPEG-2000-Bilder behalten ihr explizites /Decode
Ein JPEG-2000-Bild ignoriert /Decode nur, wenn sein Dictionary kein /ColorSpace hat und es keine Bildmaske ist. ISO 32000-1 §8.9.5 macht das bedingt, und HotPDF folgt dem. /Decode bei jedem Nicht-Stencil-JPX-Bild wegzuwerfen ist der bequeme Kurzschluss, und er lässt eine explizite Inversion schlicht verschwinden: Ein DeviceGray-JPX-Sample von 64 unter /Decode [1 0] muss als 191 rendern, nicht als 64
Diese eine Bedingung richtig zu treffen genügt nicht allein. Farbraum-Zweige wie Lab und ICCBased, die Default-Komponentenbereiche setzen, sobald das Bild JPX ist, würden ein legitim angewendetes Array ein zweites Mal überschreiben, also hält der Renderer fest, ob ein gültiges /Decode-Array tatsächlich angewendet wurde, und fügt Default-Bereiche nur ein, wenn keins war. Explizite Lab- und ICCBased-Bereiche überleben so, und die Codestream-Farbdeklaration herrscht weiterhin, wenn das Dictionary schweigt. Die Dekodiererseite des Formats beschreibt der Artikel zu JPEG 2000 und JPXDecode
Welche Decode-Pfade folgen diesen Regeln?
Beide Pipelines folgen ihnen. Auf der Headless-Seite heißt das: das Laden durch THPDFHeadlessDocument, der gemeinsame Stream-Dekodierer und der Cairo-basierte Seitenrenderer hinter HPDFRenderHeadlessPagePNGFile. Auf der VCL-Seite heißt es: Extraktion geladener Bilder in ein TBitmap und VCL-Seitenrendering, die dieselbe Table-13-Ordnung bei Vollbild- und Bereichs-Dekodierung gleichermaßen anwenden, sodass ein JFIF-Header YCbCr nicht über eine Adobe-Transformation von 0 erzwingen kann und ein illegaler Wert das Bild auch dort undekodierbar macht. Inline-DCT-Bilder folgen denselben Marker-, null-, Default- und Ablehnungsregeln wie Image-XObjects, mit abgekürzten und vollen Schlüsselnamen gleichermaßen, inklusive eines /DP << … >>-Dictionarys und abgekürzter Filterarrays wie /F [/AHx /DCT], und ein Inline-Bild mit illegalen Parametern wird übersprungen, während der Rest der Seite rendert. Der Leitfaden zum Extrahieren von Bildern aus einem geladenen PDF behandelt den Rest der Filter-Handhabung jener API
Ein paar praktische Hinweise, bevor du dich auf dieses Verhalten verlässt:
- Die JPEG-Dekodierung braucht zur Laufzeit eine kompatible TurboJPEG-Bibliothek;
HOTPDF_TURBOJPEG_LIBRARYübersteuert das Defaultturbojpeg.dlloderlibturbojpeg.so.0 - Strenge Strukturprüfungen weisen Dateien ab, die kulante Reader öffnen, namentlich das geteilte leere
/DecodeParms-Dictionary, und die Reparatur solcher Dateien liegt beim Erzeuger
Für einen farbverwalteten Druckworkflow fällt das praktische Fazit kurz aus. Schreibe CMYK-JPEGs mit einem expliziten /ColorTransform, das zu jedem Adobe-Marker in den Daten passt, plus dem /Decode-Array, das zu ihrer Speicherung passt, gib jedem Multi-Filter-Stream ein stufenbezogenes /DecodeParms-Array, und erwarte von HotPDF, dass es Dateien bei dem festhält, was sie tatsächlich sagen
Der hier gezeigte Headless-Loader, die Stream-Dekodierer und der Cairo-Seitenrenderer kommen mit der HotPDF Delphi PDF component für Delphi, C++Builder und Lazarus, neben der klassischen VCL-Document-Engine