HotPDF bettet OpenType-Variable-Fonts mit CFF2-Outlines ein, indem es sie bei den gewählten Achsenwerten in ein CID-keyed CFF1-Font-Programm umwandelt, das PDF-Reader bereits verstehen. Gewöhnlicher nativer Text, registriert über RegisterUnicodeTTF, nutzt die eigenen cmap- und hmtx-Tabellen des Fonts, und der Writer bettet das konvertierte Programm unter /FontFile3 mit /Subtype /CIDFontType0C ein, wobei jeder CID dem ursprünglichen Glyph-ID gleich bleibt
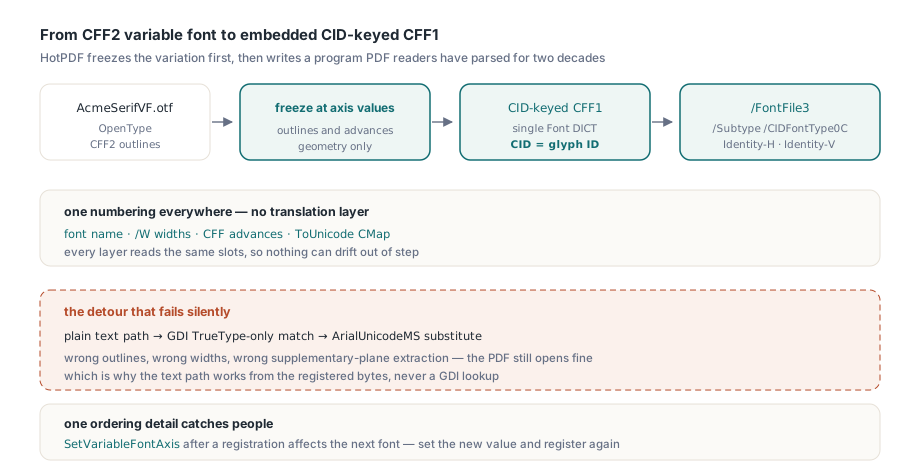
Der naheliegende Weg ist es wert, beschrieben zu werden, denn er scheitert, ohne es jemandem zu sagen. Parse und cache die CFF2-Tabellen und lass dann den Plain-Text-Pfad den Font über Windows GDI mit einem TrueType-only-Match auflösen: GDI hat keine Ahnung, was es mit CFF2-Outlines anfangen soll, und ersetzt stillschweigend durch ArialUnicodeMS. Alles Downstream, das den Ersatz liest, bekommt die falschen Outlines, die falschen Breiten und die falsche Extraktion für Supplementary-Plane-Zeichen. Das PDF öffnet sich einwandfrei. Es ist nur nicht in dem Font gesetzt, den du angefragt hast, weshalb der Text-Pfad aus den registrierten Bytes arbeiten muss statt aus einer GDI-Suche
Warum kann ein PDF keinen CFF2-Font direkt einbetten?
PDF hat keinen Slot für ein CFF2-Programm. ISO 32000-2 §9.9 listet die eingebetteten Font-Programmtypen auf, die ein Reader beherrschen muss: Type 1 unter /FontFile, TrueType unter /FontFile2, und unter /FontFile3 ein nacktes CFF-Programm (Type1C oder CIDFontType0C) oder einen OpenType-Wrapper um TrueType- oder CFF-Outlines. Jede CFF-Variante in jener Liste meint CFF-Version 1, das Format, das Reader seit zwei Jahrzehnten parsen
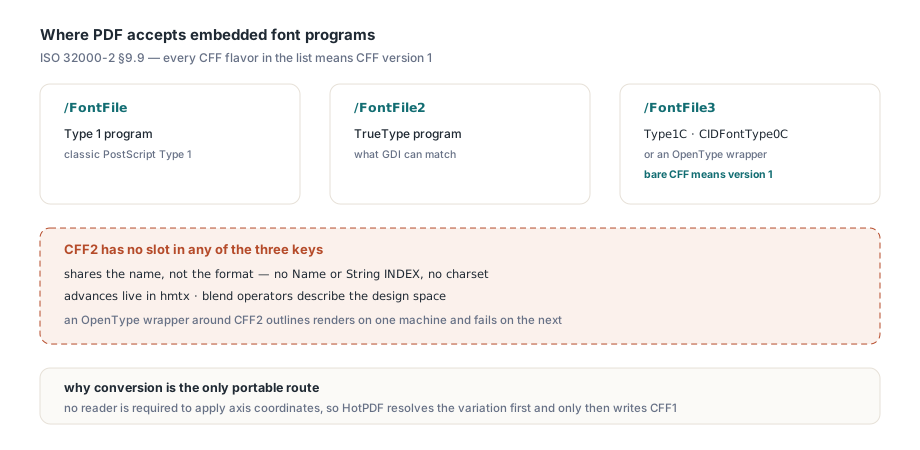
CFF2 ist ein anderes Format, das nur zufällig den Namen teilt. Es streicht den Name- und String-INDEX, streicht den charset, nimmt die Glyph-Advances aus den CharStrings heraus und überlässt sie hmtx, und es fügt Blend-Operatoren hinzu, sodass eine einzige Outline den ganzen Designraum beschreiben kann. Ein CFF1-Parser, der auf eine CFF2-Tabelle trifft, hat keine Grundlage zum Raten, und nichts in der PDF-Spezifikation verpflichtet ihn, es zu versuchen. Den CFF2-Font in einen OpenType-Stream zu wickeln und auf das Beste zu hoffen, ist genau die Art Datei, die auf einer Maschine rendert und auf der nächsten scheitert, also tut HotPDF das nicht
Die Umwandlung muss außerdem statisch sein. Wie der Artikel zum statischen Instancing von Variable-Fonts erklärt, ist ein PDF-Font ein fester Satz von Outlines mit festen Metriken, und kein Reader ist verpflichtet, Achsenkoordinaten anzuwenden. HotPDF löst daher zuerst die Variation auf und schreibt erst danach CFF1
Nativen Text in einem CFF2-Font schreiben
Für Anwendungscode verhält sich ein CFF2-Font wie jeder andere registrierte Unicode-Font: Achsenwerte wählen, Datei registrieren, Familie per Name wählen und zeichnen. RegisterUnicodeTTF behält eine separate Kopie der ursprünglichen Name-Tabelle, daher matcht SetFont den Familiennamen, den vollen Namen, den PostScript-Namen oder den typografischen Familiennamen und wählt die eingefrorenen statischen Font-Bytes, ganz ohne Windows-Installation oder GDI-Suche
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'brochure.pdf';
    Pdf.BeginDoc;
    // Achsenwerte gelten für Fonts, die nach diesem Aufruf registriert werden
    Pdf.SetVariableFontAxis('wght', 650);
    Pdf.RegisterUnicodeTTF('C:\Fonts\AcmeSerifVF.otf');
    // Familien-, voller, PostScript- oder typografischer Familienname aus der Name-Tabelle
    Pdf.CurrentPage.SetFont('Acme Serif VF', [], 12, DEFAULT_CHARSET);
    Pdf.CurrentPage.UnicodeTextOut(72, 100, 0, 'Variable weight 650, CFF2 outlines');
    Pdf.EndDoc;
  finally
    Pdf.Free;
  end;
end;
Glyph-IDs kommen aus der registrierten cmap, Advances aus der registrierten hmtx. Ein Glyph, dessen Advance echt null ist, bleibt null, statt auf eine GDI-Messung zurückzufallen, und ein UTF-16-Surrogate-Pair erzeugt genau einen Advance, nicht zwei. BMP-Zeichen, Supplementary-Zeichen und synthetische Shaping-Träger behalten ihre Unicode-Mappings je Font, sodass der Wechsel zu einem anderen eingebetteten Font oder der Beginn einer neuen Seite jenem Font nicht erlaubt, den Subset-Zustand dieses Fonts zu aktualisieren oder seine Glyph-IDs zu entleihen
Die Messung folgt denselben Bytes. THPDFPage.GetWideTextWidth und THPDFPage.GetWideCharAdvances lesen die Metriken des gewählten byte-basierten Fonts, also stimmen Zeilenumbruch und Rechtsausrichtung mit dem überein, was gezeichnet wird. Ein Ordnungsdetail bringt Leute zu Fall: SetVariableFontAxis-Änderungen nach der Registrierung betreffen den nächsten Font, den du registrierst, nicht die bereits eingefrorene Instanz. Für ein zweites Gewicht: neuen Wert setzen und erneut registrieren
Wie baut HPDFConvertCFF2ToCFF das CID-keyed Programm auf?
HPDFConvertCFF2ToCFF erzeugt ein rohes CID-keyed CFF1-Programm mit einem einzigen Font-DICT, in dem der CID für jeden Slot dem ursprünglichen Glyph-ID entspricht, auch für leere und ungenutzte. Diese Identität ist der ganze Entwurf. Der Fontname, die PDF-/W-Breiten, die CFF-Advances und die ToUnicode-CMap beziehen sich alle auf dieselbe Nummerierung, also muss keine Schicht zwischen Glyph-IDs und CIDs übersetzen, und nichts kann aus dem Tritt geraten
Auf der PDF-Seite ist der Nachfahre ein CIDFontType0-Font mit Identity-H- oder Identity-V-Encoding, und der Programm-Stream sitzt unter /FontFile3 mit /Subtype /CIDFontType0C. Weil der CID bereits dem GID entspricht, trägt der Nachfahre keine /CIDToGIDMap, und der Stream bleibt vom späteren Stream-Ersetzungs-Hook für registrierte TrueType-Fonts ausgeschlossen. Anders als der /Subtype /OpenType-Wrapper hebt der konvertierte Stream die PDF-1.6-Versionsanforderung nicht an
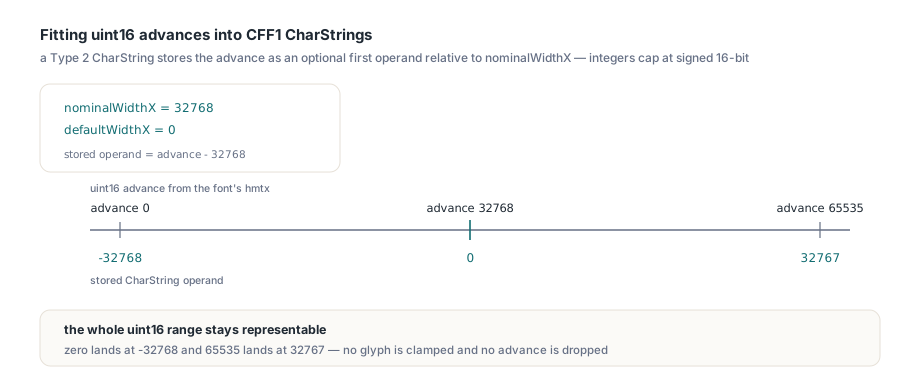
Die Breiten brauchten einen kleinen Trick. Ein CFF1-Type-2-CharString speichert den Advance als optionalen ersten Operanden relativ zu nominalWidthX, und Integer-Operanden sind auf den vorzeichenbehafteten 16-Bit-Bereich beschränkt. Ein OpenType-Advance ist ein vorzeichenloser 16-Bit-Wert, bis 65535. HotPDF setzt nominalWidthX auf 32768 und defaultWidthX auf 0 und schreibt dann jeden Advance explizit als advance - 32768. Ein null-Advance wird zu -32768, ein 65535-Advance wird zu 32767, also ist der volle uint16-Bereich darstellbar, ohne ein einziges Glyph zu klemmen
Die Geometrie bekommt dieselbe Sorgfalt. Die FontMatrix ist [1/UnitsPerEm 0 0 1/UnitsPerEm 0 0], also behält ein Font mit 2048 Einheiten seine nativen Koordinaten. Relative Moves und Linien, zu groß für einen Operanden, werden in darstellbare Schritte gespalten, und kubische Kurven werden so unterteilt, dass ihre Form erhalten bleibt. Die ursprünglichen Copyright- und Lizenz-Einträge, die ursprüngliche Name-Tabelle und die Embedding-Flags reisen im CFF-Notice-String mit
Den Konverter außerhalb eines Dokuments aufrufen
Der Konverter ist eine öffentliche Funktion in der Unit HPDFOpenTypeAdvanced, in Pascal geschrieben, ohne HarfBuzz-Abhängigkeit und ohne System-Font-Installationsschritt. Das macht ihn eigenständig nutzbar, etwa um einen Font zur Build-Zeit vorzuwandeln oder nachzusehen, was der PDF-Writer einbetten wird
uses
  System.SysUtils, System.IOUtils, HPDFOpenTypeAdvanced;

procedure ConvertWeight650;
var
  Source, Cff: TBytes;
  Axes: THPDFVariableFontAxisValueArray;
begin
  Source := TFile.ReadAllBytes('C:\Fonts\AcmeSerifVF.otf');
  SetLength(Axes, 1);
  Axes[0].Tag := 'wght';
  Axes[0].Value := 650;
  Cff := HPDFConvertCFF2ToCFF(Source, Axes);
  if Length(Cff) = 0 then
    raise Exception.Create('Not convertible: not CFF2, embedding denied or bad axes');
  TFile.WriteAllBytes('AcmeSerif-650.cff', Cff);
end;
Variabler Input läuft durch reine Geometrie-statische Instancierung bei den gegebenen Koordinaten, mit Cover für Outlines und Advances. Ein statischer CFF2-Font akzeptiert nur eine leere Auswahl; ihm Achsenwerte zu übergeben gilt als Fehler, statt ignoriert zu werden. Das Ergebnis ist ein nacktes CFF1-Programm, kein sfnt-Container, gib es also nicht an Code weiter, der eine OpenType-Datei erwartet
Für die erwarteten Fälle ist das Scheitern ein leeres TBytes, keine Exception: Input, der kein CFF2 ist, eine Achsenauswahl, die der Instancer nicht annimmt, nicht finite Werte wie NaN und Fonts, deren OS/2-fsType Restricted-License-Embedding (0x0002) oder Bitmap-only-Embedding (0x0200) setzt. Prüfe immer die Länge. Innerhalb von EndDoc macht der Writer das für dich und wirft "StoreFont: CFF2 outline conversion failed", was die richtige Entscheidung ist: Ein leeres Font-Programm in einem ausgelieferten PDF ist viel schlimmer als ein sichtbarer Fehler im Log
Budgets und Abbruch für Server-Workloads
Der optionale dritte Parameter, THPDFVariableFontControl, begrenzt den Speicher und erlaubt dir, eine lange Konvertierung abzubrechen. Ohne ihn nutzt der Konverter seine Defaults: 128 MiB Grenze für Font-Input und -Output, ein kumulatives Arbeitsbudget von 1 GiB und die CFF1-Grenze von 65535 Bytes pro CharString
type
  TFontJob = class
  private
    FCancelled: Boolean;
    procedure CheckCancel;
  public
    function Convert(const Source: TBytes): TBytes;
    property Cancelled: Boolean read FCancelled write FCancelled;
  end;

procedure TFontJob.CheckCancel;
begin
  if FCancelled then
    Abort;  // pflanzt sich aus HPDFConvertCFF2ToCFF heraus fort
end;

function TFontJob.Convert(const Source: TBytes): TBytes;
var
  Control: THPDFVariableFontControl;
begin
  Control := THPDFVariableFontControl.Create(
    32 * 1024 * 1024,           // maximale Output-Bytes
    Int64(256) * 1024 * 1024,   // kumulatives Arbeitsbudget
    CheckCancel);
  try
    // nil-Auswahl: Default-Instanz eines Variable-Fonts oder ein statischer CFF2-Font
    Result := HPDFConvertCFF2ToCFF(Source, nil, Control);
  finally
    Control.Free;
  end;
end;
Budget-Überschreitungen und Abbruch werden als Exceptions gemeldet, bewusst getrennt vom Pfad mit leerem Ergebnis. Ein leeres Array heißt, der Font lässt sich nicht konvertieren; eine Exception heißt, dieser Versuch wurde gestoppt. Halte beide in deiner Fehlerbehandlung auseinander, denn ein nicht konvertierbarer Font hilft auch ein größeres Budget nicht weiter
Wie schwer ist ein eingebetteter CFF2-Font?
Das Hauptthema, das du einplanen musst, ist die Dateigröße: HotPDF bettet bei CFF2-Fonts den vollständigen konvertierten Glyph-Satz ein, ob EnableFontSubsetting an oder aus ist. Ein Font mit mehreren tausend Glyphen fügt alle zu jedem Dokument hinzu, das ihn verwendet, selbst wenn die Seite nur eine Überschrift zeigt. Für eine Broschüre ist das akzeptabel. Für einen Report-Server, der tausende kleine PDFs schreibt, ist es ein echter Kostenfaktor, den du vor dem Festlegen messen solltest
Die verwandten Größen-Features folgen derselben Regel. Konvertierte CFF2-Fonts werden als Ganzes eingebettet, also greift weder der von CompressDocument aktivierte kompakte Font-Subset noch der persistente Font-Subset-Cache auf sie. TrueType-Fonts im selben Dokument werden weiterhin wie gewohnt gesubsetet und gecacht. Der eine Vorteil, alle Glyphen zu behalten: Fonts, deren Lizenz Subsetting verbietet, werden in einer Form eingebettet, die das respektiert
Die Ressourcengrenzen sind endliche Konvertierungsgrenzen, und CFF1 selbst begrenzt, was ein einzelner CharString fassen kann. Ein Glyph, dessen konvertierter CharString 65535 Bytes überschreitet, oder ein Font, der das Arbeitsbudget sprengt, scheitert sichtbar, statt mit leerer Outline geschrieben zu werden. Das ist der beabsichtigte Trade-off: Ein lauter Fehler an einem exotischen Font schlägt ein Dokument mit lautlos fehlenden Glyphen
Nativer CFF2-Text und der portable CFF1-Konverter kommen mit der HotPDF Delphi PDF component für Delphi und C++Builder, neben den Feature-Feldern Variable-Font-Instancing, Color-Glyph und Font-Subsetting, die an anderer Stelle dieses Blogs behandelt werden