Ein LZW-Encoderwörterbuch ist dem Decoder, der seine Ausgabe liest, immer einen Eintrag voraus, daher können beide Seiten keine gemeinsame Codebreitenschwelle teilen. PDFlibPas gibt TPLLZWEncoder und TPDFLZWDecompressor getrennte Schwellen, die aus demselben EarlyChange-Flag abgeleitet werden – und genau dieser Ein-Eintrag-Vorsprung ist der Grund, warum das Flag überhaupt existiert
Fast jede selbstgebaute LZW-Implementierung scheitert an derselben Stelle. Sie schreiben zuerst den Decoder, weil Sie ihn brauchen, um Dateien zu öffnen. Er funktioniert. Dann schreiben Sie den Encoder, spiegeln die Decoderlogik zeilenweise, weil LZW doch symmetrisch ist, lassen einen Round-Trip-Test laufen – und er besteht. Sie liefern aus. Sechs Monate später öffnet ein Kunde Ihre Ausgabe in einem Viewer, der nicht Ihrer ist, und ab irgendwo in der Mitte des Streams ist alles Müll. Die Spiegelung war der Bug: Die beiden Hälften von LZW sind nicht symmetrisch, und wer so tut, als wären sie es, produziert Streams, die nur der eigene Code lesen kann
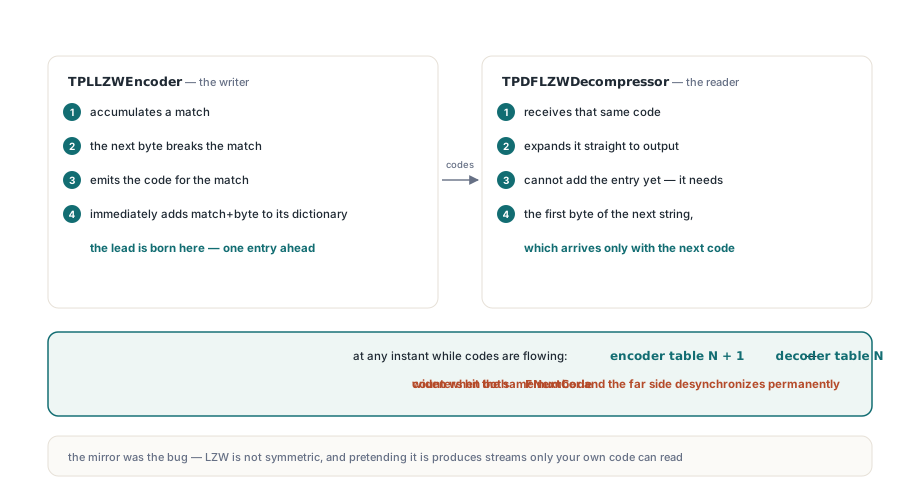
Warum braucht der Encoder eine andere Schwelle als der Decoder?
Weil der Encoder jeden Dictionaryeintrag einen Schritt früher lernt, als der Decoder es kann. Das ist in PDFlibPas keine Designentscheidung, es liegt in der Natur von LZW, und jede korrekte Implementierung muss es irgendwo ausgleichen. Gehen Sie die Schleife durch, und Sie sehen, woher der Vorsprung kommt. Der Encoder akkumuliert einen Match, merkt, dass das nächste Byte ihn bricht, emittiert den Code für den Match und fügt Match-plus-Byte sofort seinem Dictionary hinzu. Der Decoder empfängt denselben Code und expandiert ihn, kann den zugehörigen Eintrag aber noch nicht anlegen, denn der neue Eintrag braucht das erste Byte des nächsten Strings, das erst mit dem nächsten Code ankommt. Zu jedem Zeitpunkt, während Codes fließen, hält die Encodertabelle also einen Eintrag mehr als die Decodertabelle. Weiten beide Seiten den Code von 9 auf 10 Bits, wenn ihr eigenes FNextCode dieselbe Zahl erreicht, weiten sie einen Code auseinander, und der Bitreader auf der Gegenseite desynchronisiert dauerhaft. In TPDFLZWDecompressor.ResetDictionary wird die Decoderschwelle einmal berechnet und in FChangeCode abgelegt:
// TPDFLZWDecompressor.ResetDictionary: die Decoderseite der Schwelle
FCodeSize := FInitialCodeSize;                 // 9 für PDF LZWDecode
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // erweitern, wenn FNextCode 511 erreicht
else
  FChangeCode := FBitMask + 1;                 // erweitern, wenn FNextCode 512 erreicht
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
Die Decoderschleife weitet direkt nach dem Anhängen eines Eintrags und testet dabei (FNextCode = FChangeCode) and (FCodeSize < 12), wobei sie FBitMask und FChangeCode für die neue Breite neu berechnet. Neun Bits schlagen bei 511 oder 512 an, zehn Bits bei 1023 oder 1024, elf Bits bei 2047 oder 2048, und zwölf Bits sind die Decke, an der das Dictionary mit einem ClearCode geleert statt gewachsen werden muss. Der Encoder kann keine dieser Zahlen wiederverwenden. Sein GrowCodeSize addiert eins, um den Vorsprung auszugleichen, daher weitet er bei gesetztem EarlyChange bei 512, während der Decoder bei 511 weitet:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 while at 9 bits
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 while at 9 bits
  // Der Decoder fügt seinen letzten ausstehenden Eintrag hinzu, bevor er EOI liest.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;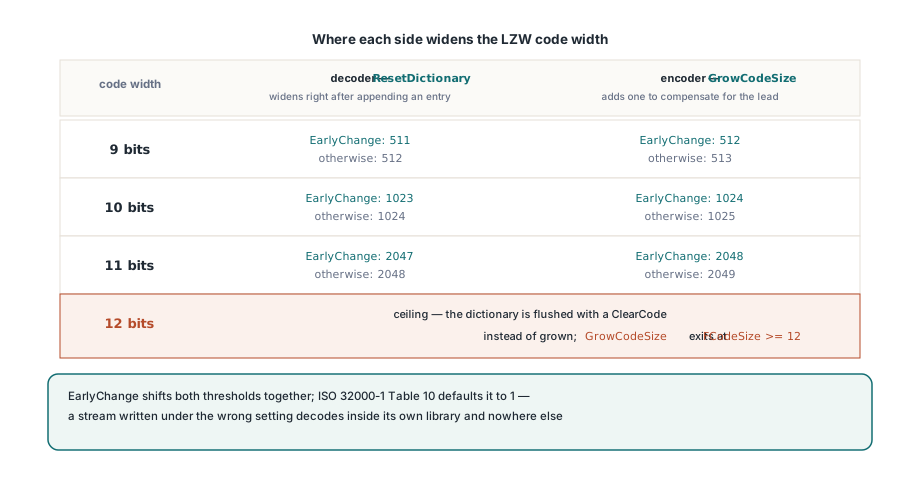
Beim letzten Datencode treffen sich die beiden Seiten endlich
Das Streamende ist die eine Stelle, an der der Encoder aufhören muss, vorzulaufen, und wie der Decoder denken muss – genau dafür ist der Parameter FinalDataCode an GrowCodeSize da. Emittieren Sie den EOI-Code mit der falschen Breite, ist alles davor weiterhin perfekt gültig, daher versteckt sich der Defekt hinter tausenden korrekten Bytes. Die Sequenz läuft so ab. Der Encoder emittiert seinen letzten Datencode und fügt – anders als bei jeder früheren Iteration – danach nichts mehr seinem Dictionary hinzu, denn es bleibt kein Folgebyte übrig, um den Match zu verlängern. Der Decoder macht das Gegenteil: Er empfängt diesen letzten Code und kann erst jetzt den Eintrag vervollständigen, den er seit dem vorherigen gehalten hat. Im letzten Schritt holt der Decoder auf, der Vorsprung kollabiert auf null, und die Breite, mit der er EOI lesen wird, entscheidet ein Eintrag, den der Encoder nie angelegt hat. Dec(ChangeCode) ist der Encoder, der für genau einen Aufruf so tut, als wäre er der Decoder:
// TPLLZWEncoder.Compress, das Streamende
EmitCode(CurCode);      // letzter Datencode, mit der aktuellen Breite
GrowCodeSize(True);     // kann mit der dekrementierten Schwelle weiten
EmitCode(FEOICode);     // EOI mit der Breite, mit der der Decoder tatsächlich liest
FlushBits;
FlushOutput;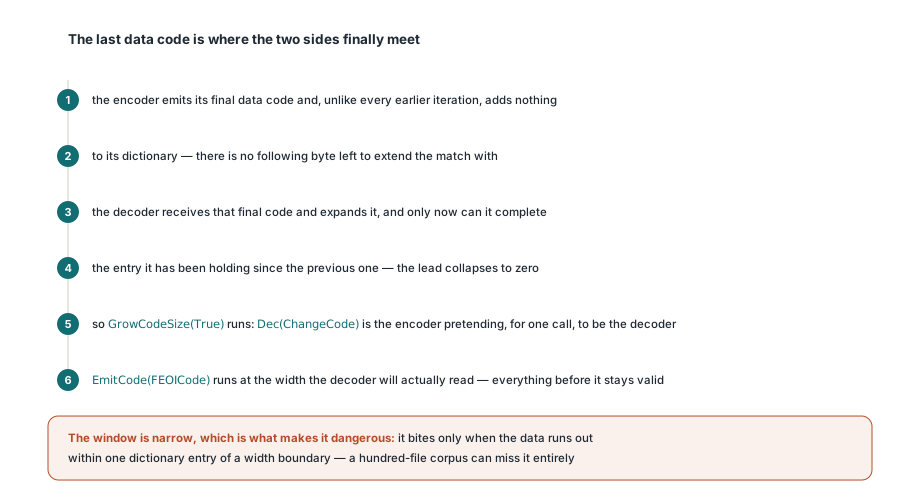
Das Fenster, in dem das zählt, ist schmal – genau das macht es gefährlich. Es beißt nur, wenn die Daten zufällig innerhalb eines Dictionaryeintrags von einer Breitengrenze ausgehen, daher kann ein Korpus aus hundert Testdateien es komplett verfehlen, während eine einzige Kundendatei es jedes Mal trifft. Grenzfälle in Compress müssen gezielt getrieben werden: Bauen Sie Eingaben, deren Dictionary bei 510, 511 und 512 Einträgen landet, und lesen Sie dann die emittierte EOI-Bitbreite von Hand aus dem Stream, statt sie aus einem erfolgreichen Decode abzuleiten
Warum kann ein bestandener Round-Trip-Test einen kaputten Stream verstecken?
Weil zwei Implementierungen, die denselben Fehler machen, sich untereinander einig sind. Wenn Ihr Encoder und Ihr Decoder beide einen Code zu früh oder beide einen Code zu spät weiten, bleiben sie im Gleichschritt, der Round Trip reproduziert die Eingabe byte für byte, und die Suite ist grün, während der von Ihnen produzierte Stream für nichts anderes lesbar ist. Das ist die wichtigste Erkenntnis der ganzen Übung: Bei LZW taugt Selbstkonsistenz als Beleg nichts. Selbst-Round-Tripping kann also nicht der primäre Test sein, und PDFlibPas validiert den LZW-Pfad stattdessen auf drei andere Arten. Handgebaute Codestreams, bei denen das erwartete Bitmuster von Hand ausgeschrieben ist, sodass die Assertion über die Bytes geht statt über das Ergebnis ihres Dekodierens. Bidirektionale Interoperabilität gegen unabhängige Implementierungen, bei der Streams dieses Encoders woanders dekodiert werden und anderswo produzierte Streams von TPDFLZWDecompressor dekodiert werden. Und differenzielles Dekodieren: dieselben Bytes zweimal lesen, mit EarlyChange in beide Richtungen gesetzt, sodass ein Stream, der unter der falschen Einstellung sauber dekodiert, Ihnen verrät, dass die Breitengrenzen nie durchlaufen wurden:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // bewusst die falsche Regel für PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A muss der Quelle entsprechen; B darf es NICHT. Wenn auch B übereinstimmt,
// war die Eingabe zu kurz, um eine Codebreitengrenze zu überqueren.
Externe Eingaben sind es, die diese Abdeckung tatsächlich liefern. Das aktuelle Testmaterial überquert die Breiten 9, 10, 11 und 12 Bit und erzwingt 34 Dictionary-Resets in einem einzigen Stream – der einzige realistische Weg zu beweisen, dass der ClearCode-Pfad an der 4095-Decke überhaupt funktioniert. Wenn Ihre Fixtures nie ein paar Kilobyte überschreiten, ist keiner dieser Codepfade je gelaufen. Und wenn ein Fix ändert, was Ihr Encoder produziert, behandeln Sie die alte Ausgabe als kaputt statt als erhaltenswerte Kompatibilitätsbasis; ein Stream, der Codebreiten falsch mischt, ist kein Legacy-Format, sondern ein Bug, der zufällig auf die Platte geschrieben wurde
PDF sagt 1, TIFF sagt: kommt darauf an
PDFlibPas setzt EarlyChange sowohl bei TPLLZWEncoder als auch bei TPDFLZWDecompressor standardmäßig auf True, denn ISO 32000-1 Tabelle 10 definiert EarlyChange als LZWDecode-Dekodierparameter mit dem Standardwert 1 – die Codelänge steigt also einen Code zu früh. Das steht in ISO 32000-1 Abschnitt 7.4.4.2 neben den Predictor-Parametern, und ein PDF, das das andere Verhalten will, muss /EarlyChange 0 explizit in sein /DecodeParms-Dictionary schreiben. TIFF ist der Grund, warum das Flag eine Eigenschaft und keine Konstante ist: TIFF 6.0 Abschnitt 13 beschreibt LZW-Kompression ohne dieselbe eindeutige Aussage, und Encoder in freier Wildbahn sind historisch darüber auseinandergefallen – sehr wahrscheinlich der Grund, warum die PDF-Spezifikation den Parameter überhaupt benennen musste. In einer TIFF-nach-PDF-Pipeline ist die Einstellung daher nichts, was Sie an einem Ende fest verdrahten können. Was auch immer die TIFF-Seite gebraucht hat, muss explizit in die PDF-/DecodeParms übernommen werden, sonst konvertieren Sie eine Datei, die sich fein öffnete, in eine, die das nicht tut. Dieselbe Sorgfalt gilt für FillOrder, wo foTop und foBottom wählen, an welchem Ende des Bytes der Bitreader auffüllt, und für die horizontale Differenzbildung von TIFF Predictor 2, die TPDFLZWParms über Predictor, Colors, BitsPerComponent und Columns durchreicht. Unsere Notizen zum Härten des eingebauten TIFF-Decoders für BigTIFF und gekachelte Layouts decken den Rest dieses Pfads ab
Zwei kleinere Fallen, die eine Erwähnung verdienen
Beide sind leicht falsch verdrahtet, wenn Sie Encoder- und Decoderobjekt nebeneinander offen haben und annehmen, die Symmetrie gelte auch dort:
InitialCodeSizebedeutet auf beiden Klassen nicht dasselbe.TPLLZWEncoder.InitialCodeSizeist die Symbolbreite der Wurzel, validiert auf 2 bis 8, wobeiInitDictionaryFClearCodeals1 shl FInitialCodeSizeableitet undFCodeSizeaufFInitialCodeSize + 1setzt.TPDFLZWDecompressor.InitialCodeSizeist die erste Codebreite, validiert auf 2 bis 9, wobeiResetDictionaryFClearCodeals1 shl (FCodeSize - 1)ableitet. Für gewöhnliche 8-Bit-PDF-Daten sind die Standardwerte 8 beziehungsweise 9, und Sie merken es nie; setzen Sie beide von Hand auf dieselbe Zahl, haben Sie ein Paar gebaut, das nicht zusammenpasst- Das Dekodieren von nicht vertrauenswürdigem LZW ist ein Speichersicherheitsproblem, bevor es ein Korrektheitsproblem ist, denn die Dictionaryindizes kommen direkt aus der Datei.
TPDFLZWDecompressorlehnt jeden Code über 4095 oder auf oder überFNextCodeab, weigert sich, Einträge über 4095 hinaus anzulegen, prüft vor jedemGetNextCodeden verbleibenden Eingabebestand in Bits und stelltSawExplicitEOIbereit, damit ein Aufrufer einen sauber beendeten Stream von einem unterscheiden kann, dem nur die Bytes ausgegangen sind. Ein abgeschnittener Stream ist kein Teilerfolg. Die breitere Übersicht im Artikel zum Härten eines Pascal-PDF-Parsers gegen bösartige Dateien deckt die Klasse von Defekten ab, die diese Guards schließen
Was Ihnen das hinterlässt
LZW sieht symmetrisch aus und ist es nicht. Das Encoderwörterbuch führt durch den Streamkörper um einen Eintrag voraus, und der Vorsprung verschwindet beim letzten Code, daher trägt eine korrekte Implementierung zwei Schwellen plus einen Sonderfall, und das EarlyChange-Flag verschiebt beide Schwellen gemeinsam. Weichen Sie nur um einen einzigen Code ab, produzieren Sie Ausgabe, die gültig ist, bis sie es nicht mehr ist – ohne Fehler, ohne Exception irgendwo, nur ein Viewer, der irgendwo Rauschen rendert. Die ehrliche Grenze ist: Keins davon ist von innen testbar. Nichts in Ihrer eigenen Suite kann einen korrekten Stream von einem konsistent falschen unterscheiden, daher ist der Interoperabilitätscheck kein optionaler Zusatzlauf, sondern der einzige echte Beleg, den Sie je bekommen. Beide Klassen sind Teil der PDF Library for Delphi, die auch die umgebende Strukturarbeit übernimmt, die in unseren Notizen zu Objekt-Streams und Cross-Reference-Streams beschrieben ist – für Delphi und C++Builder über die unterstützten Compilerversionen der Bibliothek