Einen deutschen Produktdatenblatt-Text in drei 148-Punkt-Spalten laufen lassen, und zwei Dinge gehen gleichzeitig schief. Die Zeile vor einem Wort wie Rechnungsprüfungsausschuss kann ein Drittel leer enden, denn das Leerzeichen vor diesem 26-Buchstaben-Kompositum war die einzige Stelle zum Umbrechen. Und auf der letzten Seite füllt der Resttext eine Spalte, einen Teil der zweiten und lässt die dritte leer. Ein Zeilenumbruch, der nur Leerzeichen kennt und nie zählt, was übrig bleibt, produziert genau diese Seite
Die Lösung hat zwei Hälften: innerhalb von Wörtern nach den Regeln der Sprache des Texts brechen und die letzten Spalten nach der Anzahl der noch unterzubringenden Zeilen bemessen. Beide Hälften funktionieren nur, wenn die Zeilenzahl, mit der entschieden wird, aus denselben Umbrüchen stammt, die auch gezeichnet werden, Trennstriche eingeschlossen, bei einer Spaltenbreite von 148 Punkten statt der 480-Punkt-Region
Ein dreispaltiger, mit Trennstrichen versehener Fluss in PDF Library for Delphi
PDF Library for Delphi hält eine Passage als Textfluss: NewTextFlow liefert ein Handle, SetTextFlowLanguage und SetTextFlowHyphenation steuern, wo Wörter brechen dürfen, und DrawTextFlowColumns gießt so viel des restlichen Texts in ein bis 64 gleichbreite Spalten, wie hineinpasst, und schreitet im Fluss fort. Die Spaltenbreite ist die Regionsbreite minus der Stege, dividiert durch die Spaltenzahl, also gibt eine 480-Punkt-Region mit drei Spalten und 18-Punkt-Stegen (480 − 2 × 18) / 3 = 148 Punkte je Spalte
Der Aufruf gibt die Gesamtzahl der gezeichneten Zeilen zurück. Null bedeutet, dass nichts gepasst hat, und in dem Fall bleibt der Fluss, wo er war, es geht also kein Text verloren; die Falle ist eine Seitenschleife, die weiter NewPage aufruft, während der Aufruf weiterhin null zurückgibt. Das passiert, wenn die Region kürzer als eine Zeile ist oder wenn eine Mindestzeilen-Einstellung in dem angebotenen Raum nicht erfüllbar ist. Die Schleife unten behandelt null als Fehler, statt sich zu drehen
var
  Lib: TPDFlib;
  FontID, Flow, Drawn: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetDocumentLanguage('de-DE');      // vor NewTextFlow, siehe unten
    FontID := Lib.AddTrueTypeFont('Georgia', 1);
    Lib.SetTextSize(10.5);

    Flow := Lib.NewTextFlow(ArticleBody);
    try
      Lib.SetTextFlowHyphenation(Flow, 1, 3, 3);
      Lib.SetTextFlowMinLines(Flow, 2);   // keine einzelne Zeile am Spaltenfuß stranden lassen

      repeat
        // Left 66, Top 72, 480 x 620 pt Region, 3 Spalten, 18 pt Stege, ausgeglichen
        Drawn := Lib.DrawTextFlowColumns(Flow, 66, 72, 480, 620, 3, 18, 1);
        if Lib.TextFlowFinished(Flow) = 1 then
          Break;
        if Drawn = 0 then
          raise Exception.Create('Column region cannot take the next lines');
        Lib.NewPage;
        Lib.SelectFont(FontID);
        Lib.SetTextSize(10.5);            // NewPage bringt die Schrift mit 12 pt zurück
      until False;
    finally
      Lib.ReleaseTextFlow(Flow);
    end;

    Lib.SaveToFile('newsletter.pdf');
  finally
    Lib.Free;
  end;
end;
Die Koordinaten messen von der oberen linken Ecke der Seite, ganz gleich, welchen Ursprung man gesetzt hat, denn der Spaltenaufruf legt seine Zeilen von Top aus abwärts. Bei der voreingestellten Linksbündigkeit beginnt jede Zeile an der linken Kante ihrer Spalte, also zeigt sich der Spielraum eines schlechten Umbruchs als ausgefraste rechte Kante; im Blocksatz wird derselbe Spielraum zu Flüssen aus Weißraum
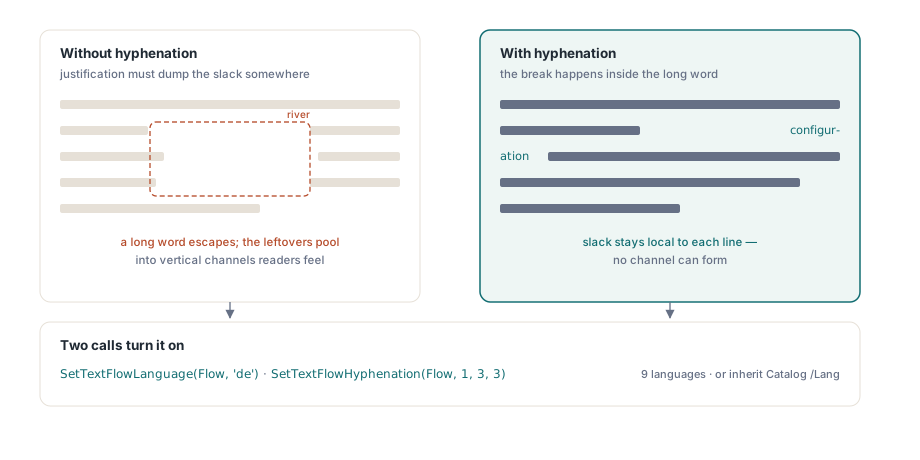
Woher kommt die Sprache für die Silbentrennung?
Ein neuer Fluss nimmt seine Sprache aus dem /Lang-Eintrag des Dokument-Katalogs, und zwar im Moment, in dem NewTextFlow läuft. Das ist derselbe Wert, den Screenreader und Suchindexierer lesen, also bekommt ein Dokument, das seine Sprache bereits deklariert, wie getaggte Ausgabe aus automatischem Tagging für barrierefreie PDFs, die Silbentrennung gratis. Der Zeitpunkt zählt allerdings. SetDocumentLanguage aufrufen, nachdem der Fluss existiert, und dieser Fluss sieht es nie; das erste Beispiel setzt die Sprache aus genau diesem Grund zuerst
Nennt das Tag eine unterstützte Sprache, schaltet sich die automatische Silbentrennung von selbst ein. Die Regeln decken Englisch, Deutsch, Niederländisch, Französisch, Spanisch, Italienisch, Portugiesisch, Russisch, Türkisch, Dänisch, Schwedisch, Finnisch, Polnisch, Tschechisch und Ungarisch ab. Regions-Subtags fallen vor der Suche weg, also trennen de-CH, de-AT und de alle als Deutsch. Ein Tag, den die Regeln nicht abdecken, etwa ja, wird akzeptiert, und das automatische Brechen schaltet sich für diesen Fluss einfach ab
Drei Rückgabewerte verraten, was passiert ist, und sie lohnen eine Prüfung in Code, der die Sprache aus Benutzerdaten erhält:
SetTextFlowLanguagegibt nur für einen fehlerhaften Tag 0 zurück; ein wohlgeformter Tag für eine nicht abgedeckte Sprache gibt 1 zurück und lässt die automatische Silbentrennung ausSetTextFlowHyphenationmitEnable = 1gibt 0 zurück, wenn die Sprache des Flusses keine Regeln hat, also kann ein Umbruch keine Bruchstellen ohne Sprache dahinter erfindenGetTextFlowHyphenationmeldet, ob das automatische Brechen gerade eingeschaltet ist, der Wert, den man mitloggen sollte, wenn ein Layout falsch aussieht
Auch hier zählt die Reihenfolge. SetTextFlowLanguage berechnet den An/Aus-Zustand aus der neuen Sprache neu, also schaltet ein Aufruf nach SetTextFlowHyphenation(Flow, 0, …) die Silbentrennung für eine unterstützte Sprache wieder ein. Erst die Sprache setzen, dann die Silbentrennungs-Optionen
MinPrefix und MinSuffix sind eine Hausstil-Einstellung
Die beiden Ganzzahlen nach dem Aktivierungs-Flag sind die Mindestzahl von Buchstaben, die vor einem Umbruch auf der Zeile bleiben bzw. nach ihm auf die nächste Zeile wandern müssen. Beide akzeptieren 1 bis 16. Schaltet sich die Silbentrennung allein wegen der Sprache ein, stehen beide auf 2, und ein Wort wird nur für das Brechen in Betracht gezogen, wenn es mindestens MinPrefix + MinSuffix + 1 Buchstaben hat
Zwei und zwei ist die Einstellung, die wir in fast jedem Dokument ändern würden. Sie produziert mehr Umbruchgelegenheiten, aber ein zweibuchstabiges Fragment am Zeilenende liest sich wie ein Tippfehler, und im Deutschen oder Niederländischen spaltet es Dinge wie einen zweiteiligen Präfix ab, den der Leser wieder zusammensetzen muss. Drei und drei kostet ein paar mehr ausgefraste Zeilen und sieht wie Satzbau aus. Bei großer Schrift die Mindestwerte weiter erhöhen, wo jedes Fragment prominent ist; auf zwei nur bei einer wirklich schmalen Spalte fallen lassen, bei der man entschieden hat, dass eine enge Satzbreite eine saubere schlägt
Welche Wörter brechen dürfen, und was mit einer URL passiert
Zeilen brechen an Leerzeichen und Tabs, und ein Line Feed erzwingt eine neue Zeile. Innerhalb eines Worts schaut die automatische Silbentrennung nur auf Wörter, die ganz aus Buchstaben bestehen (Latein einschließlich der akzentuierten Latin-Extended-Bereiche und Kyrillisch), mit führender oder nachgestellter Interpunktion beiseitegelegt. Die Regeln sind konservative Kombinationen aus Vokalen, legalen Konsonantenclustern und gängigen Affixen, also setzen sie weniger Bruchstellen als ein Wörterbuch-Trenner. Wörter mit Ziffern oder innerer Interpunktion, etwa ISO-32000 oder v2Beta, und Wörter über 128 Buchstaben bekommen keine automatischen Stellen
Weiche Trennstriche (U+00AD) sind die Überschreibung. Enthält ein Wort irgendwelche, werden diese Positionen seine einzigen Bruchstellen: Die automatischen Regeln werden für dieses Wort übersprungen, und die weichen Trennstriche funktionieren sogar, wenn die automatische Silbentrennung aus ist oder die Sprache keine Regeln hat. Für Markennamen, Produktcodes und Begriffe verwenden, die die Regeln schlecht splitten; im nächsten Beispiel sind Rechnungs und prüfungs die beiden einzigen Stellen, an denen das Kompositum brechen darf
var
  Flow: Integer;
  Body, Rest: WideString;
begin
  // U+00AD markiert die einzigen Stellen, an denen dieses Kompositum brechen darf
  Body := 'Die Pr' + #$00FC + 'fung erfolgt durch den Rechnungs' + #$00AD +
    'pr' + #$00FC + 'fungs' + #$00AD + 'ausschuss der Gesellschaft';
  Flow := Lib.NewTextFlow(Body);
  try
    if Lib.SetTextFlowLanguage(Flow, CustomerLanguageTag) = 0 then
      raise Exception.Create('Malformed language tag: ' + CustomerLanguageTag);
    if Lib.SetTextFlowHyphenation(Flow, 1, 3, 3) = 0 then
      LogWarning('No hyphenation rules; only soft hyphens will break words');
      // LogWarning ist die eigene Logging-Routine

    Lib.DrawTextFlow(Flow, 72, 72, 148, 240);

    // Was nicht gepasst hat, kommt exakt so zurück, wie es übergeben wurde,
    // weiche Trennstriche eingeschlossen
    Rest := Lib.GetTextFlowRemaining(Flow);
  finally
    Lib.ReleaseTextFlow(Flow);
  end;
end;
Ein Bindestrich-Minus wird nur am Umbruch gezeichnet, der tatsächlich gewählt wird. Nicht gewählte weiche Trennstriche bleiben in Messung und Zeichnung unsichtbar, und der Umbruch wird gegen den originalen Text aufgezeichnet, weshalb GetTextFlowRemaining die weichen Trennstriche unangetastet zurückgibt. Der naive Entwurf macht das auf erkennbare Weise falsch: Er schreibt den Trennstrich in die Zeichenkette, während er einen Kandidaten ausprobiert, der Umbruch wandert später, und ein verwaister Trennstrich landet mitten in einer Zeile
Ein Token, das in keine Zeile passt, eine lange URL oder ein Aktenzeichen mit keiner legalen Bruchstelle, wird am längsten passenden Präfix abgeschnitten, ohne Trennstrich. Der Schnitt landet nie zwischen den beiden Hälften eines Surrogat-Paars oder vor einem kombinierenden Zeichen, also wird ein Emoji oder ein akzentuierter Buchstabe nie über Zeilen hinweg zerteilt
Was Balance=1 auf der letzten Seite ändert
Das Balance-Argument zählt nur, wenn alles, was übrig ist, in die Region passt. In dem Fall teilt DrawTextFlowColumns die verbleibende Zeilenzahl durch die Spaltenzahl, rundet auf und verwendet das als Höhe jeder Spalte. Zweiundzwanzig verbleibende Zeilen in drei Spalten ergeben 8, 8 und 6. Passt der Rest nicht, behält jede Spalte ihre volle Höhe, also trägt die Seite so viel sie kann und der Rest läuft auf der nächsten Seite weiter
Eine Mindestzeilen-Einstellung kann die ausgeglichene Höhe anheben. Mit SetTextFlowMinLines(Flow, 3) und vier verbleibenden Zeilen liegt die ausgeglichene Höhe von zwei unter dem Minimum, also füllen sich die Spalten der Reihe nach: drei Zeilen in der ersten, eine in der zweiten, die dritte leer. Ein kurzer Schwanz ganz am Ende der Passage wird immer untergebracht, denn es gibt keinen anderen Ort für ihn. Um auch am Kopf der nächsten Spalte mindestens zwei Zeilen zusammenzuhalten, nimmt SetTextFlowPaginationLines Waisen- und Witwen-Mindestwerte in einem Aufruf
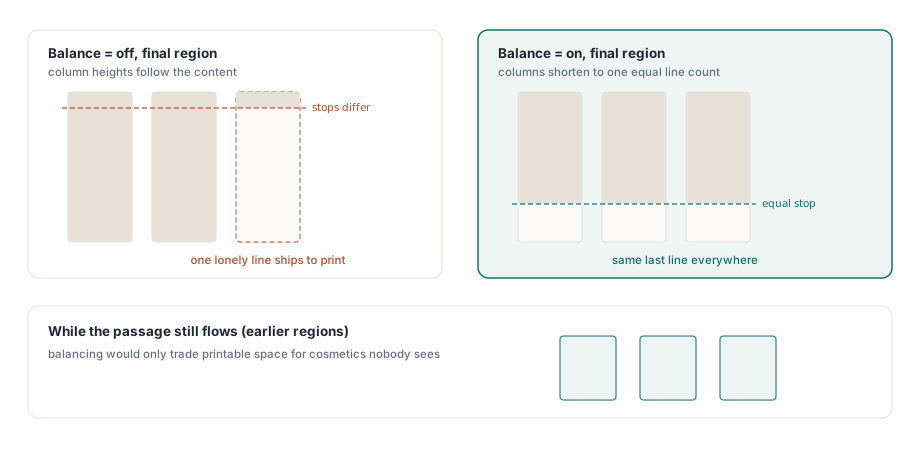
Für fortlaufende Artikel jedes Mal 1 übergeben. Mitten in der Passage ändert es nichts, die Spalten sind ohnehin voll. 0 übergeben würden wir nur, wenn die Spaltenregion eine feste Box in einem formularartigen Layout ist, wo ein Rest von 52 Zeilen in 43-Zeilen-Spalten als 43, 9 und 0 landen sollte statt als 18, 18 und 16
Hängt das Layout selbst davon ab, wie lang die Passage ist, vor dem Zeichnen messen. MeasureTextFlow liefert, wie viele Zeilen der Rest des Flusses bei einer gegebenen Breite braucht, mit demselben Brechen, Trennstriche eingeschlossen, ohne den Fluss zu bewegen
var
  Flow, Needed, LinesPerColumn: Integer;
  LinePitch: Double;
begin
  Flow := Lib.NewTextFlow(ArticleBody);
  try
    Lib.SetTextFlowLanguage(Flow, 'fr');
    Lib.SetTextFlowHyphenation(Flow, 1, 3, 3);

    Lib.SelectFont(FontID);
    Lib.SetTextSize(10.5);
    // Zeilenabstand, den der Spaltenaufruf verwendet: 1,2 x die gewählte Texthöhe
    LinePitch := Lib.GetTextHeight * 1.2;
    LinesPerColumn := Trunc(620 / LinePitch);

    Needed := Lib.MeasureTextFlow(Flow, (480 - 2 * 18) / 3);
    if Needed > 3 * LinesPerColumn then
      UseTwoPageSpread      // die eigene Layout-Entscheidung
    else
      UseSinglePage;        // Balance=1 gleicht die Spalten aus

    Lib.DrawTextFlowColumns(Flow, 66, 72, 480, 620, 3, 18, 1);
    if Lib.TextFlowFinished(Flow) <> 1 then
      CarryOver(Lib.GetTextFlowRemaining(Flow));   // ebenfalls eigen
  finally
    Lib.ReleaseTextFlow(Flow);
  end;
end;
Schrift und Größe von Box zu Box identisch halten
DrawTextFlow, DrawTextFlowColumns und MeasureTextFlow brechen Zeilen alle mit der Schrift und Größe, die im Moment ihres Aufrufs gewählt sind. Ändert man eine davon zwischen zwei Boxen desselben Flusses, bricht die zweite Box anders, als die erste gemessen hat. Der Zeilenabstand wandert mit, denn er ist das 1,2-Fache der gewählten Texthöhe. Angenommen, GetTextHeight meldet 12 Punkt für die eigene Schrift: Der Abstand ist 14,4 Punkt, und eine 620-Punkt-Spalte fasst 43 Zeilen
Der leichte Weg, darüber zu stolpern, ist eine neue Seite. NewPage wählt die aktuelle Schrift neu, aber mit 12 Punkt, und SelectFont macht dasselbe. Ein mit 10,5 Punkt gesetzter Fluss auf Seite eins läuft ab Seite zwei also mit 12 Punkt, sofern die Schleife nicht erneut SetTextSize aufruft: breitere Wörter, größerer Abstand, weniger Zeilen je Spalte und ein MeasureTextFlow-Ergebnis von Seite eins, das nicht mehr stimmt. Das Symptom wirkt zeitweilig, weil Seite eins immer richtig ist. Nach jedem NewPage die Schrift und dann die Größe neu wählen, in dieser Reihenfolge, wie das erste Beispiel
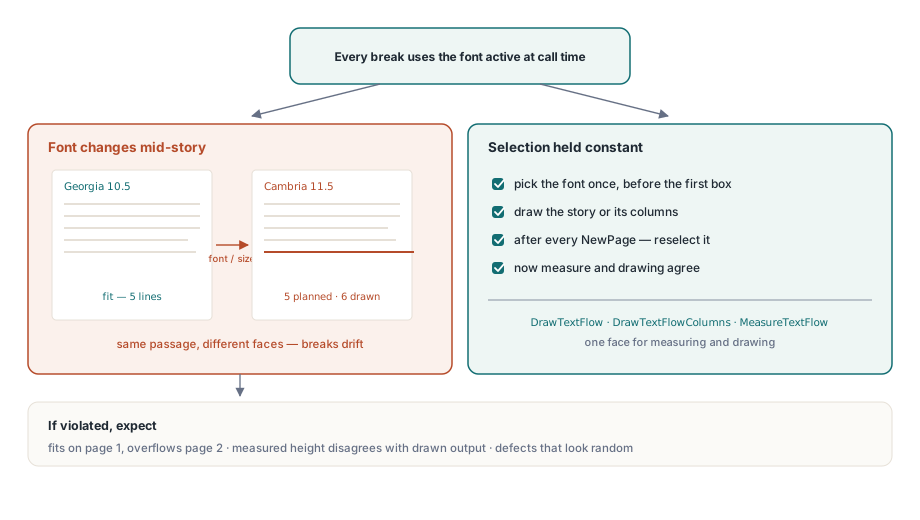
Passagen, die Schriften mischen, laufen in Messung und Zeichnung durch denselben Pfad der gewählten Schrift, also öffnen die Ersatzschnitte, die automatischer Font-Fallback für CJK- und Emoji-Text wählt, keine Lücke zwischen beiden. In Berichtslayouts, in denen der Fluss die Seite mit Kopf- und Fußzeilen und datengetriebenen Blöcken teilt, trägt die Reihenfolge aus der Dataset-Report-Engine über: erst messen, die festen Elemente platzieren, dann dem Fluss die übrige Region übergeben
Die hier behandelten TextFlow-Aufrufe, von Erzeugung und Messung bis Rücksetzen und Freigabe, sind Teil der PDF Library for Delphi für Delphi, C++Builder und Lazarus. Die Funktionsreferenz und der Download finden sich auf der Produktseite der PDF Library for Delphi