Nehmen wir eine Datei, deren Information-Dictionary /Title (Annual Maintenance Report) sagt, während ihr XMP-Paket überhaupt kein dc:title hat. Viewer zeigen den Titel anstandslos, doch ein PDF/A-Validator weist die Datei zurück, weil die beiden Metadaten-Kopien auseinanderlaufen. Eine zweite Datei sieht ebenso gesund aus, hat aber keinen pdfaid:part-Eintrag in ihrem XMP, und der Validator antwortet mit Dutzenden Fehlern: Er bewertet die Datei als gewöhnliches PDF und meldet jede Regel des beanspruchten Parts als verfehlt, alles wegen einer fehlenden Zeile
Die beiden Probleme verlangen sehr unterschiedliche Mengen Arbeit. Metadaten in Einklang zu bringen ist eine schmale Reparatur, die sich auf jeder Datei ausführen lässt. Ein beliebige PDF in ein Archiv-Format zu überführen bedeutet, zu entfernen, was der Zielpart verbietet, zu ergänzen, was er verlangt, den Anspruch zu erklären und dann die Bytes zu prüfen, die tatsächlich herauskommen. Die Konvertierung haben wir bewusst um diesen letzten Schritt gebaut. ConvertToPDFA, das mit der Enterprise Edition (TPDFlibEnterprise) zusammen mit GetPDFAConversionReport kommt, speichert das konvertierte Dokument im Speicher, läuft die PDF/A-Prüfung über diese Bytes und gibt nur dann 1 zurück, wenn die Prüfung besteht
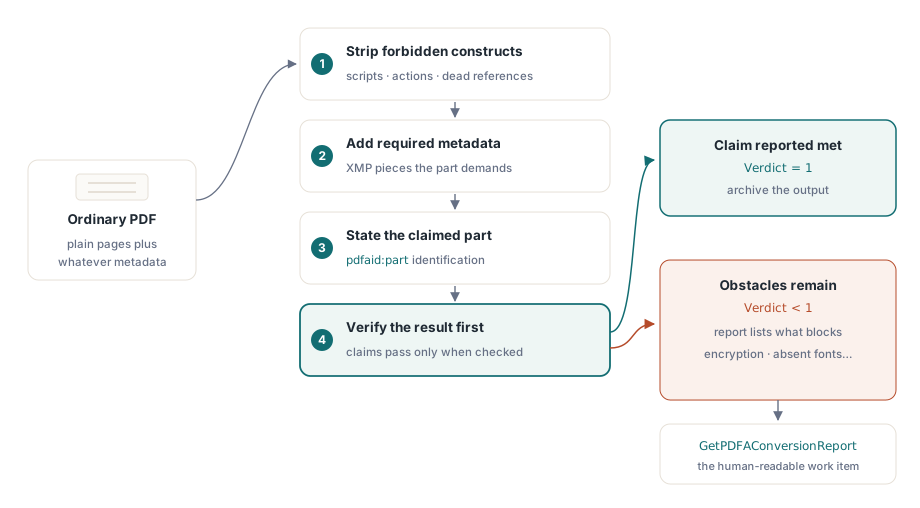
Warum scheitert ein PDF, das sich problemlos öffnen lässt, an einer PDF/A-Prüfung?
Beide Fehler kommen aus Metadaten-Regeln. Ein PDF zeichnet Titel, Autor, Producer und Daten im Document-Information-Dictionary auf, und PDF/A verlangt dieselben Fakten zusätzlich in einem XMP-Metadaten-Paket; ISO 19005-1 §6.7.3 verlangt, dass beide äquivalent sind, und PDF/A-2 und PDF/A-3 behalten die Regel. Bei Dateien, die an dieser Regel scheitern, ist das übliche Muster ein Producer, der das Information-Dictionary füllte und nie die XMP-Hälfte schrieb, also findet der Validator einen Titel an der einen Stelle und nichts an der anderen
Die fehlende Identifikation ist leiser. Die Einträge pdfaid:part und pdfaid:conformance sind es, die eine Datei als PDF/A markieren, und eine Datei kann vollkommen wohlgeformt sein, ohne sie. Der Fall, den wir am häufigsten sehen, ist eine Anwendung, die ihr eigenes XMP-Paket mitbringt und das vom PDF-Writer erzeugte ersetzt; das eigene Paket trägt die Felder der Anwendung und keine pdfaid-Einträge, also zeigt die Fehlerliste quer überallhin, nur nicht zur echten Ursache
RepairDocumentMetadata erledigt beide Fälle und gibt zurück, wie viele Einträge es geändert hat. Es ist in jeder Edition verfügbar, ebenso SetPDFAMode und SanitizeDocument. Die Reparatur läuft über Title, Author, Subject, Keywords, Creator, Producer, CreationDate und ModDate. Wo nur das XMP einen Wert trägt, wird das Information-Dictionary daraus gefüllt, also wird nichts bereits Aufgezeichnetes weggeworfen. Wo beide Werte tragen und sie abweichen, gewinnt das Information-Dictionary. Wir haben so entschieden, weil das Information-Dictionary die Hälfte ist, die Producer am häufigsten setzen, was es zur wahrscheinlicheren Aufzeichnung dessen macht, was der Autor beabsichtigt hat
Ist Ihr XMP die maßgebliche Kopie (etwa kuratiert in einem Dokumentmanagementsystem), schieben Sie die gewünschten Werte zuerst mit SetInformation ins Information-Dictionary und führen Sie erst danach die Reparatur aus. Umgekehrt überschreibt die Reparatur Ihren kuratierten XMP-Titel mit dem, was der originale Producer geschrieben hat
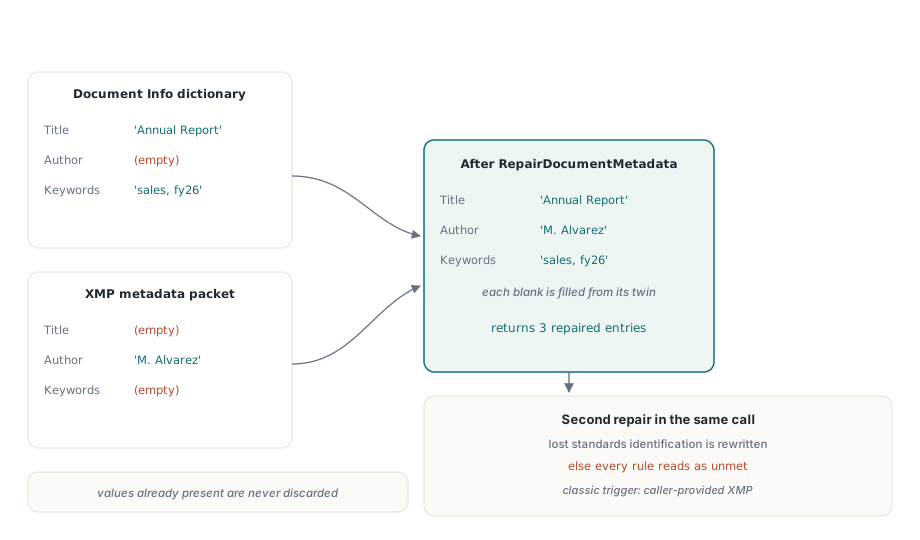
Die Identifikations-Reparatur braucht eines von Ihnen: Das Dokument muss wissen, auf welchen Part es zielt. Eine frisch geladene Datei hat keinen PDF/A-Modus gesetzt, also vor der Reparatur SetPDFAMode aufrufen. Mit gesetztem Modus schreibt RepairDocumentMetadata die passenden pdfaid-Einträge, ergänzt pdfaid:rev mit dem Jahr 2020 für die Part-4-Modi und setzt dc:format auf application/pdf, was Validatoren ebenfalls prüfen
uses
  SysUtils, PDFlibrary;

procedure RepairIncoming(const InName, OutName: string);
var
  Lib: TPDFlib;
  Fixed: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InName]);

    // Der kuratierte Titel wandert zuerst ins Information-Dictionary,
    // denn diese Kopie gewinnt, wenn die beiden Hälften abweichen
    Lib.SetInformation(2, 'Annual Maintenance Report 2025');

    Lib.SetPDFAMode(3);                  // 3 = PDF/A-2b, siehe Tabelle unten
    Fixed := Lib.RepairDocumentMetadata;
    Writeln(Format('%d metadata entries brought into agreement', [Fixed]));

    Lib.SaveToFile(OutName);
  finally
    Lib.Free;
  end;
end;
Zielpart und seine Modus-Nummer wählen
Den Part danach wählen, was das Dokument tragen muss, und erst danach die Nummer nachschlagen. SetPDFAMode und ConvertToPDFA teilen sich ein Nummerierungsschema, und es läuft nicht in der Reihenfolge, die die Part-Namen nahelegen
| Modus | Part und Level | Anmerkungen |
|---|---|---|
| 1 | PDF/A-1a | PDF 1.4, getaggt |
| 2 | PDF/A-1b | PDF 1.4 |
| 3 | PDF/A-2b | PDF 1.7 |
| 4 | PDF/A-2a | PDF 1.7, getaggt |
| 5, 6, 7 | PDF/A-3b, 3a, 3u | Eingebettete Dateien beliebiger Typen erlaubt |
| 8 | PDF/A-2u | PDF 1.7, Unicode-Text erforderlich |
| 9, 10, 11 | PDF/A-4, 4e, 4f | PDF 2.0; 4e ergänzt 3D und Rich Media, 4f erlaubt eingebettete Dateien |
Modus 3 ist PDF/A-2b und Modus 4 ist PDF/A-2a. Diese Umkehrung erwischt alle, die von 1a aufwärts zählen und annehmen, dass das a-Level immer vorausgeht. PDF/A-2u taucht bei 8 auf, nach den Part-3-Modi
Die Wahl mit echten Konsequenzen betrifft Anhänge. Die Parts 1 und 2 verbieten eingebettete Dateien, also entfernt ConvertToPDFA sie für die Modi 1 bis 4 und Modus 8. Eine Factur-X- oder ZUGFeRD-Rechnung nach Modus 3 zu konvertieren verliert die strukturierte XML-Rechnung in der Ausgabe, samt dem Grund, warum die Datei existiert. Für alles, was einen Anhang trägt, Modus 5 (PDF/A-3b) als Ziel nehmen, auf jenem Part sind diese Rechnungsformate auch definiert, oder Modus 11, falls PDF 2.0 gebraucht wird. Jeder Anhang in einer Part-3- oder Part-4-Datei muss über /AFRelationship angeben, wie er zum Dokument gehört, und die PDF Library for Delphi schreibt diesen Eintrag für jede eingebettete Datei, die sie in diesen Modi speichert
Part 4 identifiziert sich anders. Er hat keinen Konformitätsbuchstaben für schlichtes PDF/A-4, nutzt E oder F für die beiden Erweiterungen und verlangt pdfaid:rev mit dem Jahr, in dem sein Part veröffentlicht wurde. ConvertToPDFA hebt die Datei für die Modi 9 bis 11 auf PDF 2.0, denn ISO 19005-4 §6.1.2 baut den Part auf PDF 2.0 auf, und die Prüfung bewertet solche Dateien gegen PDF 2.0 statt 1.7
Die Marke lesen, die eine Datei bereits trägt
ConvertToPDFA absolviert eine feste Abfolge von Reparaturen, vermerkt jede in einem Klartext-Report, speichert das Ergebnis im Speicher und prüft diese Bytes. Eine gescheiterte Prüfung gibt 0 zurück, und ebenso ein Modus außerhalb 1 bis 11, der zurückkehrt, bevor überhaupt ein Report geschrieben wird. Die Abfolge lohnt sich zu kennen, denn jeder Schritt ist etwas, das die Ausgabe verliert oder dazubekommt:
- Ein verschlüsseltes Dokument mit unbekanntem Passwort stoppt die Konvertierung sofort mit einer
blocked:-Zeile; nichts darin lässt sich lesen, geschweige denn reparieren - Dokumentlevel-JavaScript und die Open Action, die es ausführt, werden entfernt, zusammen mit jedem Additional-Actions-Eintrag und den Aktionstypen, die kein Part erlaubt, darunter Launch, Sound, Movie, ResetForm, ImportData, Hide, SetOCGState, Rendition und Trans. GoTo- und URI-Links bleiben, die Navigation funktioniert also weiter
- Eingebettete Dateien werden für die Parts entfernt, die sie verbieten, wie oben beschrieben
- Annotationen, die versteckt sind oder nie angezeigt werden sollen, werden gelöscht. PDF/A verlangt sichtbare und druckbare Annotationen, und sie einzublenden würde das Aussehen der Seite ändern, also haben wir die Entfernung gewählt
- Die Erscheinungsbilder von Formularfeldern werden neu erzeugt, bevor das Flag
/NeedAppearancesgelöscht wird, sodass ausgefüllte Werte sichtbar bleiben - Schriften, die verwendet, aber nicht eingebettet sind, werden aus den auf der Maschine installierten Schriften eingebettet
- Objekte, auf die nichts mehr verweist, fallen weg, und ein sRGB-Output-Intent wird ergänzt, falls die Datei keinen hat
- Zuletzt werden Part und Level im XMP erklärt und die Bytes werden geprüft
Auf einem Server ist der Schrift-Schritt der, der eine Konvertierung am ehesten aufhält. Ein Dokument, das eine Schrift verwendet, die es auf dem Konvertierungs-Host nirgends gibt, lässt sich nicht aus der Datei heraus reparieren, und der Report sagt es. Die Schriften, die die Dokumente tatsächlich verwenden, auf der Konvertierungsmaschine installieren; der Walkthrough zum Einbetten fehlender Schriften in ein bestehendes PDF behandelt diesen Schritt für sich
Wie soll ein Stapellauf mit einer scheiternden Konvertierung umgehen?
Den Rückgabewert als Schleuse behandeln und den Report als Arbeitsschein. Die Dateien mit Rückgabe 1 archivieren, den Rest an einen Menschen mit dem Report als Anlage weiterreichen. Die Ausgabe einer gescheiterten Konvertierung nicht deshalb ins Archiv legen, weil sie sauberer aussieht als die Eingabe. Diese Datei trägt nun einen PDF/A-Anspruch, den die Prüfung zu bestätigen sich geweigert hat, genau die Situation, die der Prüfschritt verhindern soll
Der Report aus GetPDFAConversionReport ist eine Zeile je Aktion, jede beginnend mit einem Verb: removed:, regenerated:, repaired:, embedded:, added:, stated:, dazu blocked:, falls etwas den Lauf stoppte, und eine abschließende result:-Zeile. Die Prüfung hinter dem Urteil stoppt beim ersten Fehler, also läuft bei einer gescheiterten Datei die Konvertierung die Prüfung noch einmal komplett durch, und der Report zeigt alle Probleme auf einmal. Auf die Präfixe zu routen kostet ein paar Zeilen
uses
  Classes, SysUtils, PDFlibrary, PDFlibEnterprise;

function ArchiveOne(const InName, ArchiveDir, ReviewDir: string): Boolean;
var
  Lib: TPDFlibEnterprise;
  Report: TStringList;
  I: Integer;
  Blocked: Boolean;
begin
  Result := False;
  Lib := TPDFlibEnterprise.Create;
  Report := TStringList.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      Exit;
    Result := Lib.ConvertToPDFA(5) = 1;      // 5 = PDF/A-3b, behält Anhänge
    Report.Text := Lib.GetPDFAConversionReport;
    if Result then
      Lib.SaveToFile(IncludeTrailingPathDelimiter(ArchiveDir) + ExtractFileName(InName))
    else
    begin
      Blocked := False;
      for I := 0 to Report.Count - 1 do
        if Pos('blocked:', Report[I]) = 1 then
          Blocked := True;
      // Original unangetastet lassen; nur der Report reist mit
      Report.SaveToFile(IncludeTrailingPathDelimiter(ReviewDir) +
        ChangeFileExt(ExtractFileName(InName), '.pdfa-report.txt'));
      if Blocked then
        Writeln(InName, ': needs a password or a rebuilt source file');
    end;
  finally
    Report.Free;
    Lib.Free;
  end;
end;
Eine blocked:-Zeile bedeutet meist, dass die Lösung außerhalb des PDF liegt: ein Passwort, eine andere Quelldatei oder ein erneuter Lauf dessen, was das Dokument erzeugt hat. Schlichte Prüfprobleme nach einer vollständigen Konvertierung sind öfter Inhalte, die Bedeutung tragen und sich nicht einfach löschen lassen, und das sind die Fälle, in denen ein Mensch entscheiden muss
Die Marke lesen, die eine Datei bereits trägt
Vor der Konvertierung prüfen, was das Dokument bereits über sich selbst behauptet. Dateien von Scannern, Office-Suiten und anderen PDF-Werkzeugen tragen oft bereits eine PDF/A-Marke, und eine gültige PDF/A-3-Datei zu Part 2 zu rekonvertieren würde sie ihre Anhänge umsonst kosten
Die Falle: XMP erlaubt, dieselbe Eigenschaft auf zwei Arten zu schreiben. Manche Producer schreiben den Part als Kindelement, <pdfaid:part>2</pdfaid:part>; andere als Attribut an rdf:Description, pdfaid:part="2". Beides ist gewöhnliches, gültiges XMP. Ein Detektor, der nur nach einer Form sucht, entscheidet, dass Dateien aus der anderen Producer-Familie keine Marke tragen, und ein so gebauter Prüfer endet damit, eine gültige PDF/A-2-Datei gegen Part 1 zu bewerten und sie als unmarkiert und mit zu hoher PDF-Version zu melden, das exakte Gegenteil der Wahrheit. Der Validator in PDF Library for Delphi liest beide Formen. Wer die Marke selbst erschnüffelt, mache dasselbe:
function DeclaredPDFAPart(Lib: TPDFlib): string;
const
  ElemTag = '<pdfaid:part>';
  AttrDQ  = 'pdfaid:part="';
  AttrSQ  = 'pdfaid:part=''';
var
  Packet: string;
  P: Integer;
begin
  Result := '';
  Packet := Lib.GetDocumentMetadata;
  P := Pos(ElemTag, Packet);                   // Element-Form
  if P > 0 then
    Exit(Copy(Packet, P + Length(ElemTag), 1));
  P := Pos(AttrDQ, Packet);                    // Attribut-Form, doppelte Anführungszeichen
  if P = 0 then
    P := Pos(AttrSQ, Packet);                  // Attribut-Form, einfache Anführungszeichen
  if P > 0 then
    Result := Copy(Packet, P + Length(AttrDQ), 1);
end;
Ein leeres Ergebnis bedeutet keine Marke in keiner Form. Eine Ziffer verrät, welchen Part der Producer meinte, und diese Zahl ist die, die man mit dem eigenen Ziel vergleicht, bevor man überhaupt über eine Konvertierung entscheidet
Skripte bereinigen, bevor die Datei ins Archiv wandert
Archivkonvertierung und sicherheitsorientierte Bereinigung laufen meist gemeinsam, denn der Inhalt, den eine Sicherheitspolitik loswerden will, überschneidet sich stark mit dem, was PDF/A verbietet. SanitizeDocument nimmt eine Bitmaske aus SANITIZE_*-Flags und gibt zurück, wie viele Entfernungen es angewendet hat. ConvertToPDFA selbst ruft es als ersten Schritt mit SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION auf
Ein Detail zählt für Validatoren. Dokumentlevel-Skripte leben in einem /JavaScript-Name-Tree unter dem /Names-Dictionary des Katalogs, und wenn das letzte Skript entfernt wird, wandert der nun leere Tree mit heraus. Ein leerer Tree verkündet weiterhin, dass das Dokument Skripte hat, und manche Prüfer reagieren auf den Schlüssel selbst, ohne zu zählen, was unter ihm sitzt
Welches Werkzeug auch bereinigt hat: Die gespeicherte Datei mit einem frischen Laden verifizieren, statt dem Zustand im Speicher zu vertrauen. Erneutes Öffnen ist billig:
var
  Lib, Check: TPDFlib;
begin
  Lib := TPDFlib.Create;
  Check := TPDFlib.Create;
  try
    Lib.LoadFromFile('upload.pdf', '');
    Lib.SanitizeDocument(SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION);
    Lib.SaveToFile('upload-clean.pdf');

    Check.LoadFromFile('upload-clean.pdf', '');
    if Check.GlobalJavaScriptCount > 0 then
      raise Exception.Create('Document-level scripts survived the save');
  finally
    Check.Free;
    Lib.Free;
  end;
end;
Für die Nachbarschritte in einer Archiv-Pipeline siehe die Anleitungen zu PDF/A- und PDF/UA-Preflight, echter Redaktion und Inhaltsentfernung und PDF/A-3-XMP-Erweiterungs-Schemata für Factur-X, das die Metadaten-Seite aufgreift, sobald ein archiviertes Dokument zusätzlich strukturierte Rechnungsdaten trägt
Die gesamte hier gezeigte Konvertierung, Metadaten-Reparatur und Validierung läuft im eigenen Delphi-, C++Builder- oder Lazarus-Prozess, ohne externen Konverter oder Kommandozeilen-Validator in der Kette. Die Produktseite der PDF Library for Delphi listet die PDF/A-Parts, Editionen und Zielplattformen auf