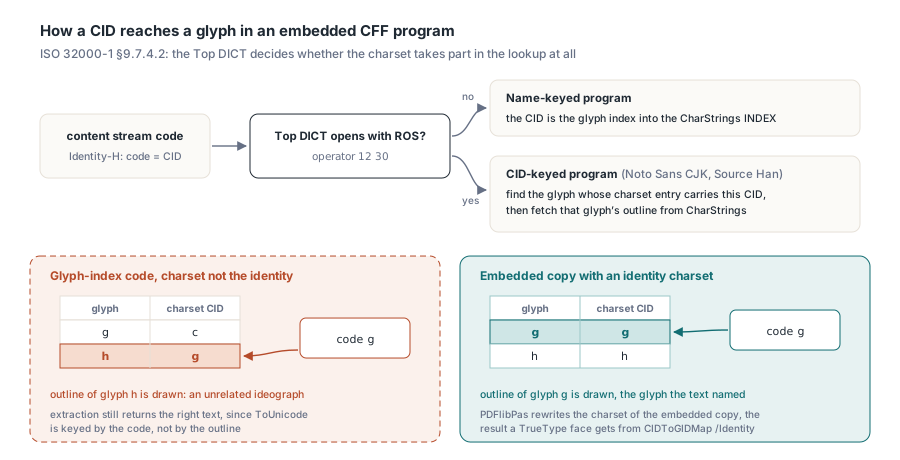
Eine chinesische Rechnung in Noto Sans SC aus der .otf-Datei zeigt in mutool mitunter fremde Ideogramme, wo der Kundenname stehen sollte, während eine TrueType-Schrift dieselbe Seite korrekt rendert. Ursache ist der CFF-Charset der Schrift; PDFlibPas schreibt ihn in der eingebetteten Kopie auf die Identity um, sodass Glyph-Index-Codes die vorgesehenen Glyphen erreichen
Ob eine Schrift das Problem zeigt, hängt davon ab, wie sie gebaut wurde. Ein als CIDFontType2 eingebettetes TrueType-Programm bekommt eine CIDToGIDMap von Identity, und der Code im Content-Stream landet auf der vorgesehenen Glyphe. Die meisten lateinischen OpenType-Schriften mit CFF-Outlines sind name-keyed, und ein name-keyed CFF-Programm verwendet den ankommenden CID direkt als Glyph-Index. ISO 32000-1 merkt in §9.7.4.2 sogar an, dass CID und GID in vielen Schriften übereinstimmen. Nicht in allen. Die großen CJK-Familien, die als CID-keyed-Schriften gebaut sind — Noto Sans CJK und seine Source-Han-Geschwister gehören dazu — führen ihre eigene CID-Nummerierung, und ein Writer, der Glyph-Indizes direkt in diese Nummerierung schickt, bekommt die Glyphe, die zufällig den passenden CID besitzt
Was ein CID-keyed CFF-Programm mit einem CID macht
ISO 32000-1 §9.7.4.2 teilt eingebettete CFF-Programme anhand des Top DICT in zwei Fälle. Verwendet der Top DICT die CIDFont-Operatoren — in der Praxis beginnt er mit ROS (Operator 12 30: Registry, Ordering, Supplement) — nimmt der Reader den CID aus dem Content-Stream, sucht die Glyphe, deren Charset-Eintrag diesen CID trägt, und holt erst dann die Outline aus dem CharStrings INDEX. Ohne CIDFont-Operatoren ist der CID der Glyph-Index, und der Charset spielt keine Rolle. Jeder Reader, der §9.7.4.2 wörtlich folgt, zeichnet daher für einen Glyph-Index-Code die falsche Glyphe, solange der Charset nicht die Identity ist — ganz gleich, welchen Viewer Sie einsetzen. Der Charset selbst, definiert in Adobe Technical Note #5176, kommt in drei Layouts mit zwei Sonderfällen:
- Format 0 speichert pro Glyphe eine 2-Byte-SID oder einen 2-Byte-CID, in Glyph-Reihenfolge
- Format 1 speichert Bereiche: einen ersten CID, gefolgt von einem 1-Byte-Zähler für die Glyphen, die mit fortlaufenden CIDs darauf folgen
- Format 2 ist dasselbe Bereichs-Layout mit einem 2-Byte-Zähler, passend für Schriften mit langen ununterbrochenen Folgen
- Glyph 0 ist
.notdefund hat in keinem Format einen Eintrag; ein Charset-Offset von 0, 1 oder 2 benennt einen der vordefinierten Charsets, statt auf Daten zu zeigen
Finden Sie also zuerst heraus, welche Art von Schrift Sie vor sich haben. Identity-H sagt auf der PDF-Seite nur, dass ein 2-Byte-Code dem CID entspricht. Wie dieser CID zu einer Glyphe gelangt, liegt vollständig im Font-Programm. Die Funktion unten liest die CFF -Tabelle aus einer .otf-Datei, geht den Top DICT nach ROS durch und prüft, ob der Charset jede Glyphe auf einen CID mit derselben Nummer abbildet. Sie braucht nur die RTL
uses
  System.SysUtils, System.IOUtils;

type
  TCFFCharsetReport = record
    IsCFF, CIDKeyed, IdentityCharset: Boolean;
    CharsetFormat, GlyphCount: Integer;
  end;

{$RANGECHECKS ON}  // eine abgeschnittene Datei wirft ERangeError, statt falsch zu lesen
function InspectOtfCharset(const FileName: string): TCFFCharsetReport;
var
  B: TBytes;
  NumTables, I, Cff, P, Dict, DictEnd, Unused1, Unused2: Integer;
  Op, Operand, CharsetOfs, CharStringsOfs, G, Left: Integer;

  function BE(Pos, Count: Integer): Integer;
  var
    K: Integer;
  begin
    Result := 0;
    for K := 0 to Count - 1 do
      Result := (Result shl 8) or B[Pos + K];
  end;

  // Liefert das Ende des INDEX an Pos und grenzt sein erstes Objekt ein
  function SkipIndex(Pos: Integer; out ObjStart, ObjEnd: Integer): Integer;
  var
    Count, OffSize, Base: Integer;
  begin
    Count := BE(Pos, 2);
    if Count = 0 then
    begin
      ObjStart := Pos + 2;
      ObjEnd := ObjStart;
      Exit(Pos + 2);
    end;
    OffSize := B[Pos + 2];
    Base := Pos + 2 + (Count + 1) * OffSize;  // Offsets sind ab hier 1-basiert
    ObjStart := Base + BE(Pos + 3, OffSize);
    ObjEnd := Base + BE(Pos + 3 + OffSize, OffSize);
    Result := Base + BE(Pos + 3 + Count * OffSize, OffSize);
  end;

begin
  Result := Default(TCFFCharsetReport);
  Result.CharsetFormat := -1;
  B := TFile.ReadAllBytes(FileName);
  if (Length(B) < 12) or (BE(0, 4) <> $4F54544F) then  // 'OTTO'
    Exit;
  Cff := -1;
  NumTables := BE(4, 2);
  for I := 0 to NumTables - 1 do
    if BE(12 + I * 16, 4) = $43464620 then               // 'CFF '
      Cff := BE(12 + I * 16 + 8, 4);
  if Cff < 0 then
    Exit;
  Result.IsCFF := True;
  P := SkipIndex(Cff + B[Cff + 2], Unused1, Unused2);    // Name INDEX
  SkipIndex(P, Dict, DictEnd);                           // Top DICT INDEX
  Operand := 0;
  CharsetOfs := 0;
  CharStringsOfs := 0;
  P := Dict;
  while P < DictEnd do
  begin
    Op := B[P];
    case Op of
      12:
        begin
          if B[P + 1] = 30 then
            Result.CIDKeyed := True;                     // ROS
          Inc(P, 2);
        end;
      0..11, 13..21:
        begin
          if Op = 15 then
            CharsetOfs := Operand
          else if Op = 17 then
            CharStringsOfs := Operand;
          Inc(P);
        end;
      28: begin Operand := SmallInt(BE(P + 1, 2)); Inc(P, 3); end;
      29: begin Operand := BE(P + 1, 4); Inc(P, 5); end;
      30:
        begin                                            // reelle Zahl
          repeat
            Inc(P);
          until ((B[P] and $F) = $F) or ((B[P] shr 4) = $F);
          Inc(P);
        end;
      32..246: begin Operand := Op - 139; Inc(P); end;
      247..250: begin Operand := (Op - 247) * 256 + B[P + 1] + 108; Inc(P, 2); end;
      251..254: begin Operand := -(Op - 251) * 256 - B[P + 1] - 108; Inc(P, 2); end;
    else
      Exit;                                              // reserviertes Byte
    end;
  end;
  if (not Result.CIDKeyed) or (CharsetOfs <= 2) or (CharStringsOfs <= 0) then
    Exit;
  Result.GlyphCount := BE(Cff + CharStringsOfs, 2);
  P := Cff + CharsetOfs;
  Result.CharsetFormat := B[P];
  if Result.CharsetFormat > 2 then
    Exit;
  Inc(P);
  Result.IdentityCharset := True;
  G := 1;                                                // .notdef hat keinen Eintrag
  while G < Result.GlyphCount do
  begin
    if BE(P, 2) <> G then
      Result.IdentityCharset := False;
    case Result.CharsetFormat of
      0: Left := 0;
      1: Left := B[P + 2];
    else
      Left := BE(P + 2, 2);
    end;
    Inc(P, Result.CharsetFormat + 2);
    Inc(G, Left + 1);
  end;
end;
Ein Report mit CIDKeyed = True und IdentityCharset = False beschreibt genau die Schrift, um die es in diesem Artikel geht: Jeder Writer, der Glyph-Indizes in den Content-Stream schreibt, ohne diesen Charset zu berücksichtigen, zeichnet mit ihr die falschen Glyphen. Ein name-keyed Ergebnis oder eine CID-keyed-Schrift, deren Charset bereits zufällig die Identity ist, rendert unter demselben Writer korrekt. Deshalb arbeitet in einem Produkt eine CJK-Schrift und die nächste nicht. Die Schleife vergleicht nur den ersten CID jedes Bereichs. Das genügt: Ein Bereich deckt fortlaufende Glyphen mit fortlaufenden CIDs ab, also bleibt ein Bereich, der beim eigenen Glyph-Index beginnt, bis zum Ende dabei
Glyph-Indizes wandern durch das gesamte Font-Dictionary
Ein PDF-Writer hat selten CIDs in der Hand. Die cmap-Tabelle und die Shaping-Engine liefern beide Glyph-Indizes, also schreibt der naheliegende Entwurf diese Indizes als 2-Byte-Identity-H-Codes und hängt alles andere an denselben Schlüssel: das /W-Width-Array, die /CIDSet-Bitmap, die PDF/A verlangt, und die ToUnicode-CMap, mit der die Extraktion den Quelltext wiederfindet. TrueType hat ein Ventil. Tabelle 117 bietet CIDToGIDMap an, aber nur für Type-2-CIDFonts; ein CFF-Programm steckt in einer CIDFontType0-Schrift, die einen CID von der PDF-Seite aus nicht umleiten kann. Das verbannt auch einen Trick, den manche Writer mit TrueType verwenden — einer wiederverwendeten Glyphe einen zweiten "Alias"-CID hinter dem Ende der Schrift zu geben, damit ToUnicode jedem Einsatz einen anderen Text zuordnen kann. In einer CFF-Schrift wählt dieser Alias keine Glyphe, und mutool meldet, dass es sie nicht rendern kann. Schriften, die U+4E00 und U+2F00 (KANGXI RADICAL ONE) auf eine Outline abbilden, sind der Normalfall. Braucht Ihr Dokument die beiden unterschiedlich extrahiert, wickeln Sie das Vorkommen in ein Marked-Content-Span mit /ActualText ein (ISO 32000-1 §14.9.4), das ein Reader statt der Zuordnung der Schrift verwendet
Den Charset an Ort und Stelle umschreiben
Es gibt zwei Wege, Glyph-Index-Codes mit einem CID-keyed-Programm zu versöhnen. Der eine übersetzt jeden Glyph-Index in den CID der Schrift, bevor er ihn schreibt; das berührt die Content-Stream-Codes, die Schlüssel von /W, die Bitpositionen in /CIDSet, die Quellcodes in ToUnicode und jedes Subset beim Speichern. Der andere ändert die eine Struktur, die nicht passt, den Charset, sodass die Schrift auf Glyph-Indizes antwortet wie ein name-keyed-Programm. Der zweite Weg ist der sicherere. Shaper, Width-Tabelle, Subsetter und der ToUnicode-Builder arbeiten weiter im Glyph-Raum, und der einzige Code, der CIDs verstehen muss, ist eine kurze Routine, die einmal über die eingebettete Kopie der Schrift läuft. PDFlibPas nimmt diesen Weg
Das Umschreiben behält das Format des Charsets und seine Bytelänge bei. In Format 0 wird jeder Eintrag mit seinem eigenen Glyph-Index überschrieben. In den Formaten 1 und 2 ändert sich nur der erste CID jedes Bereichs, die Zähler bleiben, wie sie sind. Nichts wächst oder schrumpft. Die Top-DICT-Offsets zu CharStrings, die Private DICTs, FDArray und FDSelect bleiben gültig, ohne dass irgendetwas neu kodiert wird, und FDSelect — das Hinting-Dictionarys per Glyph-Index zuweist — lässt jede Glyphe in ihrem ursprünglichen FD. Name-keyed-Programme, vordefinierte Charsets, CFF2-Tabellen (sie haben keinen Charset) und Programme, die sich nicht parsen lassen, bleiben unangetastet. Drei Code-Pfade führen das Umschreiben aus:
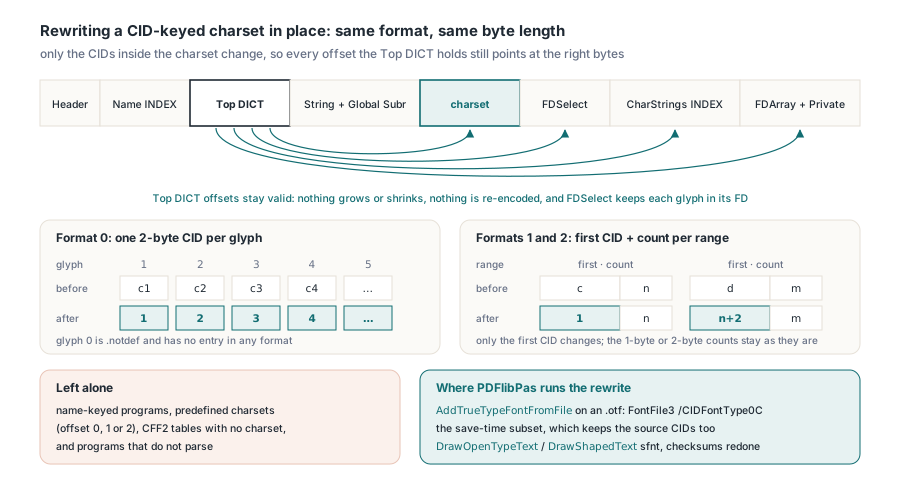
AddTrueTypeFontFromFilebettet eine.otf-Datei als blankeCFF-Tabelle alsFontFile3mit SubtypCIDFontType0Cein, der Charset bereits umgeschrieben- Das Subset beim Speichern behält die ursprünglichen Glyph-Indizes, aber auch die Quell-CIDs, daher wird sein Charset ein zweites Mal umgeschrieben
- Der Shaping-Begleiter hinter
DrawOpenTypeTextundDrawShapedTextbehält das gesamte sfnt; nach dem Umschreiben wird dieCFF-Tabellen-Prüfsumme neu berechnet, undcheckSumAdjustmentderhead-Tabelle wird0xB1B0AFBAminus die Summe der Datei - Diese Anpassung ist nur für eine einzelne Schrift definiert, daher bekommt eine aus einer Sammlung entnommene Schrift nur die Tabellen-Prüfsumme
uses
  SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    // Eine CFF-Variante einer .otf wird als FontFile3 /CIDFontType0C eingebettet;
    // die eingebettete Kopie bekommt einen Identity-Charset, wenn sie CID-keyed ist
    FontID := Lib.AddTrueTypeFontFromFile('C:\Fonts\NotoSansSC-Regular.otf');
    if FontID = 0 then
      raise Exception.Create('the font file could not be read or parsed');
    Lib.SetTextSize(18);
    Lib.DrawText(56, 760, '季度报表:华东区销售汇总');
    Lib.DrawText(56, 730, '发票号码 2026-11-0187,金额 ¥12,480.00');
    if Lib.SaveToFile('noto-sc.pdf') <> 1 then
      raise Exception.CreateFmt('save failed, error %d', [Lib.LastErrorCode]);
  finally
    Lib.Free;
  end;
end;
Prüfen Sie das Ergebnis, indem Sie es rendern. Die Extraktion zeigt das Problem nicht. pdftotext und jeder andere Extraktor lesen ToUnicode, das an dem Code im Content-Stream hängt und nichts darüber weiß, welche Outline die Schrift dafür wählt, also extrahiert eine Seite mit falschen Ideogrammen trotzdem den richtigen String. mutool draw -r 150 -o page%d.png noto-sc.pdf zeigt, wie die Seite wirklich aussieht, und für diesen DrawText-Pfad sollte popplers pdffonts noto-sc.pdf die Schrift als CID Type 0C auflisten. Erwartet: Beide Zeilen rendern in Noto Sans SC mit den Glyphen, die der Quelltext nennt, und dasselbe Ergebnis zeigt auch Ghostscript
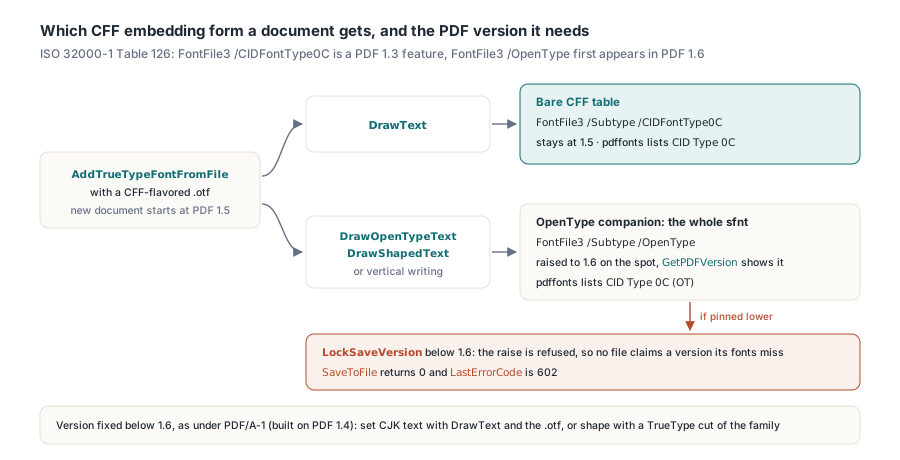
Welche Einbettungsform braucht PDF 1.6?
Die OpenType-Variante. Tabelle 126 von ISO 32000-1 listet einen FontFile3-Stream mit Subtyp CIDFontType0C als PDF-1.3-Feature, während der Subtyp OpenType — das gesamte sfnt mit seiner CFF -Tabelle — erstmals in PDF 1.6 auftaucht. Neue PDFlibPas-Dokumente starten bei Version 1.5, in die der Bare-CFF-DrawText-Pfad passt. Der erste DrawOpenTypeText-, DrawShapedText- oder Vertikal-Schreib-Aufruf mit einer CFF-Schrift erzeugt einen OpenType-Begleiter und hebt das Dokument sofort auf 1.6, was GetPDFVersion unverzüglich meldet. Eine Versions-Sperre ändert das. Hat LockSaveVersion das Dokument niedriger festgenagelt, wird die Anhebung verweigert und SaveToFile gibt 0 mit LastErrorCode 602 zurück, sodass keine Datei eine Version behauptet, die ihre Schriften nicht einhalten. Fixiert ein Auslieferungsprofil die Version unter 1.6 — PDF/A-1 ist der häufige Fall, weil es auf PDF 1.4 basiert —, setzen Sie CJK-Text über DrawText mit der .otf, oder nehmen Sie für alles, was Shaping braucht, einen TrueType-Schnitt der Familie
var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Writeln('before: ', Lib.GetPDFVersion);      // Erwartet: 1.5
    if Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0) = 1 then
      Writeln('after: ', Lib.GetPDFVersion);     // Erwartet: 1.6
    Lib.SaveToFile('shaped.pdf');  // Erwartet in pdffonts: CID Type 0C (OT)
  finally
    Lib.Free;
  end;

  Lib := TPDFlib.Create;
  try
    Lib.LockSaveVersion('1.5');
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0);
    if Lib.SaveToFile('locked.pdf') = 0 then
      Writeln('save refused, error ', Lib.LastErrorCode);  // Erwartet: 602
  finally
    Lib.Free;
  end;
end;
Widths und ToUnicode an dieselben Zahlen gekoppelt
Sobald der Charset die Identity ist, sind CID, Glyph-Index und Content-Stream-Code eine einzige Zahl. Die Widths folgen ihr. ISO 32000-1 §9.7.4.3 indexiert /W direkt über den CID, in Gruppen aus entweder einem Start-CID gefolgt von einem Width-Array oder einem ersten CID, einem letzten CID und einer gemeinsamen Width, ohne den /FirstChar-Offset, den simple Fonts verwenden. Jeden CID, den das Array auslässt, nimmt /DW an, und Tabelle 117 setzt den Default für /DW auf 1000. Null ist falsch. Ein Reader, der für nicht gelistete CIDs auf 0 zurückfällt, kollabiert eine Zeile voller Ideogramme in sich selbst. Für eine über AddTrueTypeFontFromFile geladene .otf schreibt PDFlibPas ein /W-Array, das bei CID 0 beginnt und jeden Glyphvorschub listet, neben einem expliziten /DW 1000. Auf der Leserseite geht CJK-Text, der als Müll extrahiert wird meist im Codespace-Teil derselben Pipeline schief, und ein PDF/UA-Schrift-Audit von Widths, CharSet und CIDSet hält diese Arrays gegen das eingebettete Programm
ToUnicode hat eine eigene Nummerierungsregel. Ein bfrange-Eintrag speichert nur den ersten Ziel-String, und §9.10.3 verlangt, dass sein letztes Byte durch die Länge des Bereichs nicht über 255 hinausgeschoben wird, weil ein Reader die folgenden Ziele erzeugt, indem er nur dieses letzte Byte erhöht. Fortlaufende Glyphen, die auf U+4EFE, U+4EFF, U+4F00 und U+4F01 abilden, sehen wie ein Bereich aus. Sind sie nicht: Ein Reader würde das dritte als U+4E00 dekodieren. Der PDFlibPas-Writer verschmilzt benachbarte Glyph-zu-Unicode-Paare nur dann in einen bfrange, wenn sowohl die Quellcodes als auch die Ziele innerhalb eines 256er-Blocks bleiben, und teilt die Folge sonst auf. Vertikaler CJK-Satz läuft über dieselben Begleiterschriften, also erbt vertikaler japanischer und chinesischer Text den Identity-Charset und diese ToUnicode-Bereiche ohne zusätzliche Aufrufe
Jede Schrift, die InspectOtfCharset als CID-keyed mit nicht-Identity-Charset meldet, ist eine, bei der Glyph-Index-Codes und die Schrift auseinanderlaufen. Über PDFlibPas für Delphi eingebettet, behält eine solche Schrift ihre Outlines, Offsets und Charset-Länge, und was sich ändert, sind die CIDs in dieser einen Tabelle — plus die Prüfsummen, wenn das gesamte sfnt erhalten bleibt