Importer et FDF ind i en formular, og feltværdierne kommer tilbage diskret forkert: en bullet ankommer som en dagger, en ellipsis som en em dash. PDFium Component spores hele den symptom-familie til én enkelt række i sin PDFDocEncoding-tabel — specialtegn-blokken i ISO 32000-1 Annex D.2 starter ved $80, ikke $7F
Hvorfor returnerer en FDF-import nabo-tegnet?
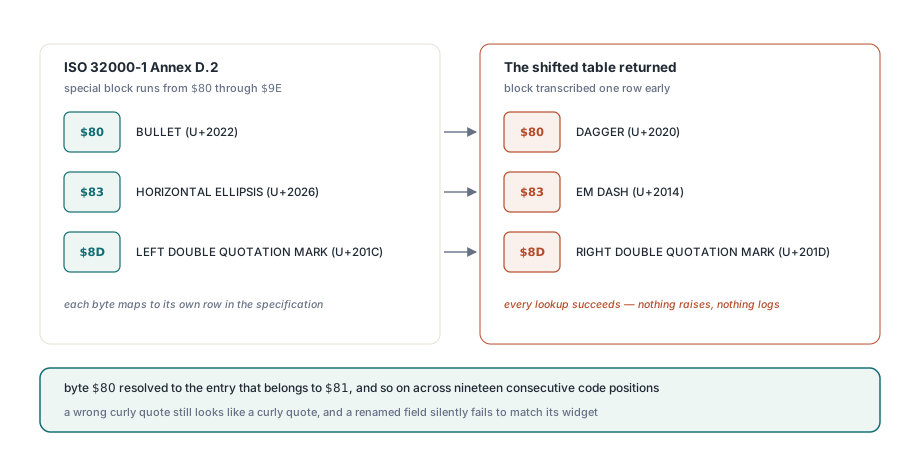
Fordi en kodetabel forskudt med én position stadig er en perfekt valid-udseende tabel, og hvert opslag i den lykkes. Blokken som Annex D.2 tildeler $80 til og med $9E, var blevet transskriberet én række for tidligt, så byte $80 opløstes til indgangen der hører til $81, byte $81 til indgangen for $82 og så videre over nitten på hinanden følgende kodepositioner. Intet rejste sig, intet blev logget, og intet felt blev nogensinde afvist — TPdf.ImportFDF rapporterede det samme felt-antal som altid
Skaden var ensartet og lydløs. En byte der bærer $80, som Annex D.2 definerer som BULLET (U+2022), kom tilbage som DAGGER (U+2020). Byte $83, HORIZONTAL ELLIPSIS (U+2026), kom tilbage som EM DASH (U+2014). Byte $8D, LEFT DOUBLE QUOTATION MARK (U+201C), kom tilbage som RIGHT DOUBLE QUOTATION MARK (U+201D) — det tilfælde ingen lægger mærke til, fordi et forkert krøllet citattegn stadig ligner et krøllet citattegn i et formularfelt. Feltnavne led samme skæbne som feltværdier, hvilket er værre: et navn der ikke længere matcher widget'en i dokumentet, fejler lydløst med at blive anvendt
PDF-tekststrenge bærer to forskellige encodings
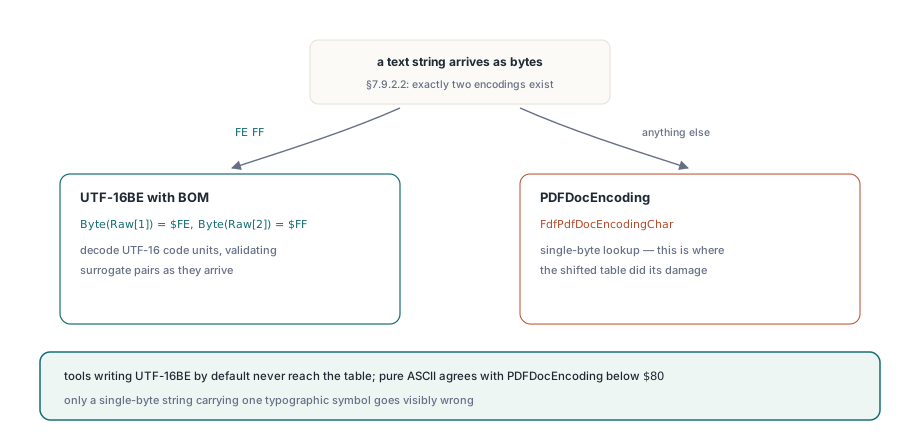
ISO 32000-1 §7.9.2.2 definerer tekst-streng-typen som én af præcis to encodings, valgt ved at inspicere de første to bytes snarere end via nogen dictionary-indgang. En streng der åbner med byte order mark'en FE FF er UTF-16BE; alt andet er PDFDocEncoding. Den ene gren afgør hvilken af to fuldstændigt forskellige decodere der kører, og PDFium Component anvender den inde i FDF-parseren før den rører et enkelt tegn
// FDF-tekststreng: UTF-16 når BOM'en er til stede, ellers PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... afkod UTF-16-kodeenheder, valider surrogate-par
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
Det er derfor fejlen gemte sig så længe i almindelig testning. Ethvert FDF produceret af et værktøj der som default skriver UTF-16BE når aldrig FdfPdfDocEncodingChar overhovedet, så den forskudte tabel forbliver sovende. Kun enkelt-byte-strenge — hvilket er hvad en hel del FDF-generatorer udsender til almindelige latinske feltnavne, fordi de er kortere — går ned ad grenen hvor tabellen betyder noget. Rene ASCII-feltnavne afkodes så korrekt alligevel, da PDFDocEncoding og ASCII er enige under $80. Du skal bruge en enkelt-byte-streng der indeholder ét typografisk symbol, før noget går synligt galt
Den rettede tabel, og de to ankre der fæstner den
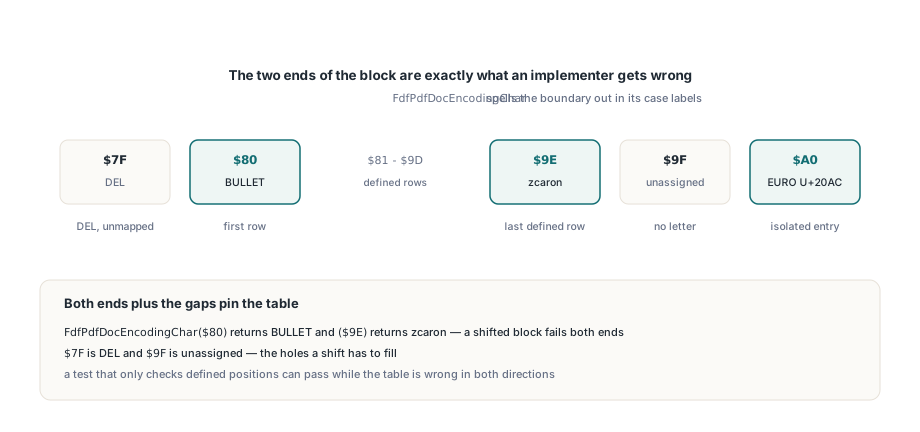
PDFium Component staver nu grænsen ud i selve FdfPdfDocEncodingChar, fordi de to ender af blokken er præcis hvad en implementør får galt. $7F er DEL og har overhovedet ingen PDFDocEncoding-betydning; blokken åbner ved $80 med BULLET og løber til $9E med zcaron; $9F er uallokeret; og eurotegnet sidder alene ved $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Annex D.2. Blokken løber fra $80, ikke $7F: $7F er DEL og
    // har ingen PDFDocEncoding-betydning, og eurotegnet sidder ved $A0, som
    // default-grenen ellers ville give tilbage som no-break space
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, blokkens første række
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 til og med $9D
    $9E: Result := WideChar($017E);   // zcaron, sidste definerede række
    $9F: Result := WideChar($FFFD);   // uallokeret i Annex D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Se hvad forskydningen gjorde ved de to ender, for det er der en off-by-one holder op med at være kosmetisk. zcaron sad ved $9E i specifikationen men ved $9D i den forskudte tabel, så en dokument-byte på $9E faldt forbi den sidste række nogen havde transskriberet og faldt lige igennem til identity-fallback'en, hvilket returnerede et C1-kontroltegn i stedet for et bogstav. Og $A0, eurotegnet, blev aldrig skrevet ind i tabellen i første omgang — identity-grenen gav det tilbage som U+00A0 NO-BREAK SPACE, et tegn der overlever al efterfølgende validering, printer som intet og aldrig matcher det feltnavn du leder efter
Hvordan tester du en transskriberet kodetabel?
Test første række, sidste række og hullerne — ikke en stikprøve fra midten. Det er den del af rettelsen der er værd at bære videre til enhver anden tabel du kopierer ud af en specifikation, fordi en midt-i-blokken-stikprøve er præcis den test en hel-blok-forskydning overlever. At verificere at $8D giver et venstre dobbelt citattegn beviser intet når $8C også giver noget plausibelt; at verificere at $80 giver BULLET og $9E giver zcaron fæstner begge ender, og en forskudt blok kan ikke tilfredsstille begge på én gang
procedure CheckPdfDocEncodingAnchors;
begin
  // Begge ender af Annex D.2-specialblokken: en hel-blok-forskydning bryder disse
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Kodepositioner specifikationen lader være udefinerede må ikke afkode til et bogstav
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // Den isolerede indgang over blokken, let at udelade helt
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
De udefinerede positioner fortjener deres egne assertions frem for at blive sprunget over som uintetessante. En off-by-one skal lægge noget et eller andet sted, og hvor den lægger det er næsten altid en kodeposition specifikationen lod stå tom — $7F foran, $9F bagest. En test der kun tjekker definerede positioner kan bestå mens tabellen er forkert i begge retninger; en test der fæstner hullerne fanger forskydningen ved første kørsel
Hvad dette koster i en round-trip-formular-workflow
En FDF-import der lydløst omskriver ét tegn per symbol er værre end én der fejler, fordi fejlen dukker op downstream og ligner noget andet. Feltnavne er den skarpe kant her. TPdf.ImportFDF matcher indkommende navne mod widget'ene i det åbne dokument, og et navn der afkodede ét tegn forkert matcher simpelthen ikke — feltet forbliver tomt, returværdien tæller stadig feltet som parset, og rapporten der kommer ud af pipelinen mangler én værdi uden noget i loggen der forklarer hvorfor. Enhver der bygger en eksport-og-genimport-løkke af den slags beskrevet i eksport og import af XFDF-formulardata og annotationer med PDFium Component, bør round-trip'e et feltnavn der indeholder et typografisk symbol, ikke bare ren ASCII, før de stoler på løkken
Det er også værd at være ærlig om rettelsens begrænsninger. Tabellen matcher nu Annex D.2 for alle 256 byte-værdier, hvilket får enkelt-byte-FDF-strenge til at afkode korrekt, men PDFDocEncoding selv dækker et latinsk repertoire og intet mere — alt uden for det skal ankomme som UTF-16BE med en BOM, hvilket er præcis hvad §7.9.2.2 har til hensigt. Og en UTF-16-streng har stadig sine egne separate faldgruber på Delphi-siden, da et code point ud over U+FFFF har brug for et surrogate-par snarere end ét WideChar, problemet dækket i hvorfor emoji og CJK-tegn bryder WideChar i Delphi. Det bredere punkt generaliserer forbi kodetabeller: en PDF-parser kan afvise noget den burde acceptere, hvilket du finder med det samme, eller acceptere noget og lydløst få det galt, hvilket du finder i produktionen. Name-token-fælderne beskrevet i parsning af PDF-dictionaries sikkert ligger i den anden kategori, og det gør en tabel forskudt én række også — kodestien lykkes, returværdien ser fornuftig ud, og kun en test skrevet mod specifikationen snarere end mod implementeringen siger noget andet
ImportFDF, ExportFDF og ImportXFDF på TPdf, sammen med de FDF- og XFDF-parsere der ligger bag dem, er en del af standard-PDFium Component til Delphi og C++Builder