PDFium Component version 3.117.0 forbinder en tabel, der bryder over en sidegrænse, når enten begge fragmenter rører sidekanterne, eller ingen brødtekst ligger under det første fragment og over det andet, idet løbende sidehoveder og sidefødder ignoreres. ExtractDocumentTables anvender det indholdsbevidste tjek som et alternativ til det ældre sidekant-tjek, nægter et næste-side-fragment, hvis første række er én fuldbredde caption-celle, og beholder en enkelt række, der spilder over på den følgende side, som en del af sin fortsættelseskæde
Artiklen om tabeldetektering og -ekstraktion præsenterede fortsættelse som fire strenge porte og behandlede "rører sidekanten" som én af dem. Den beskrivelse var korrekt for den udgivelse, den dækkede, og den var også forkert for de fleste tabeller, folk faktisk giver komponenten. Denne artikel er korrektionen: Hvilke dokumenter sidekant-tjekket ikke kan håndtere, hvad der erstattede det, og de to sidecases, fixet trak med sig
Hvorfor fejler sidekant-tjekket på Word-eksporter?
Sidekant-tjekket fejler, fordi et tekstbehandlingsprogram stopper med at opsætte rækker ved den nederste margin, ikke ved papirkanten. Med default-ContinuationMargin på 36 point krævede den oprindelige regel, at det tidligere fragments nederste kant lå inden for 36 point fra sidebunden, og det senere fragments øverste kant inden for 36 point fra sidetoppen. Et dokument eksporteret fra Word med dets default én-tommes-marginer placerer den sidste række mindst 72 point over sidebunden, længere oppe hvis en sidefod er til stede, så betingelsen holdt aldrig. Hver lang tabel i et sådant dokument kom tilbage som uafhængige fragmenter med ContinuationGroup på nul, og calleren var tilbage til at sy i hånden. Tjekket giver stadig mening for det, det var designet omkring: Rapporter genereret af layout-engines, der fylder en side til en fast indholdsboks og starter næste side flush i toppen. Det er ikke en dårlig regel, det er en ufuldstændig en, hvilket er grunden til, at version 3.117.0 beholdt den og tilføjede en anden vej i stedet for at erstatte den
Hvad tjekker det indholdsbevidste tjek i stedet?
Det indholdsbevidste tjek undersøger, om noget andet end tabellen optager rummet mellem de to fragmenter, med brug af hver sides ord-bokse frem for sidegeometrien. Mens ExtractDocumentTables gennemløber dokumentet, registrerer den pr. side den laveste nederste kant af ethvert ord, hvis top ligger over sidefodsbåndet, og den højeste topkant af ethvert ord, hvis bund ligger under sidehovedbåndet. Begge bånd er ContinuationMargin point dybe, så samme option gør nu dobbelttjeneste som sidekant-slæk og som højden af zonerne for løbende sidehoved og sidefod. Et par fragmenter består, når det tidligere fragments nederste kant er på eller under den laveste brødtekst på sin side, og det senere fragments øverste kant er på eller over den højeste brødtekst på næste side, hver inden for AlignmentTolerance. I klart sprog: Tabellen var det sidste på side N og det første på side N+1, og et sidetal eller en dokumenttitel i marginbåndet tæller ikke. Den udelukkelse er ikke vilkårlig. ISO 32000-1 §14.8.2.2 klassificerer løbende sidehoveder og sidefødder som pagineringsartefakter, indhold der findes på grund af sideskiftet frem for på trods af det, og samme idé, der lader en tagged reader springe dem over, er det, der lader en tabel fortsætte forbi dem. Marked content-artiklen dækker, hvordan taggede filer deklarerer de artefakter eksplicit; her udledes klassificeringen af position, fordi de fleste eksporterede tabeller slet ikke bærer tags
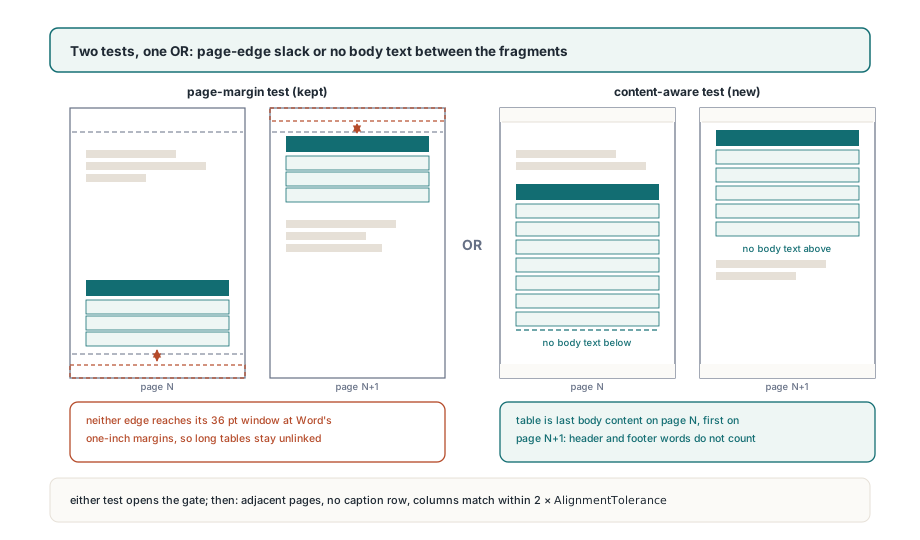
De to tests kombineres med OR. En layout-engine-rapport, hvis tabeller løber til papirkanten, består den første; en Word-eksport, hvis tabeller stopper ved marginen, består den anden; et dokument, der gør begge dele, består to gange. Først efter at én af dem lykkes, kører de resterende porte, og de kører i fast rækkefølge: Sidetallene skal være nabosider, det senere fragment må ikke åbne med en caption-række, og kolonnegrænserne skal matche inden for det dobbelte af AlignmentTolerance, hvilket er 6 point ved default-værdierne. Enumerationen er TPdfTableContinuation med værdierne ptcNone, ptcStart, ptcMiddle og ptcEnd. Et fragment, der var markeret ptcEnd og derefter kæder videre til endnu en side, forfremmes til ptcMiddle, så en tre-siders tabel læses start, middle, end i sideorden. Gruppenumre starter ved 1, og 0 betyder ukædet, og ToJson emitterer samme information som continuation- og continuationGroup-medlemmerne, hvilket er formen at foretrække, hvis en downstream-service laver syningen
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectContinuations := True;     // default; vist for tydelighedens skyld
    Options.ContinuationMargin := 54;        // to-linjers sidefod, ca. 50 pt dyb

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d (%d rows)',
          [Tables[I].PageNumber, Tables[I].RowCount]));
      end;
  finally
    Pdf.Free;
  end;
end;
Hvordan forhindrer en caption-række to tabeller i at smelte sammen?
Et næste-side-fragment, hvis første række er én celle, der spænder over alle kolonner, behandles som en ny tabel, aldrig som resten af den forrige. Denne regel findes, fordi det indholdsbevidste tjek alene kæder for ivrigt. Casen, der eksponerede det, var en transskript-agtig formular: En tabel slutter nær bunden af side 1, en anden tabel med identiske kolonnebredder starter nær toppen af side 2, intet andet end sidefoden ligger mellem dem, og kolonnerne matcher til punkt og prikke. Under sidekant-testen mødtes de to aldrig, for ingen af dem rørte en kant; under indholdstesten kædede de straks, og en formular med sektioner blev ét usammenhængende gitter. Det, der adskiller dem, er synligt i cellestrukturen. Den anden tabel åbner med en sektions-caption som "RECIPIENT INFORMATION" lagt ud som én flettet celle over den fulde bredde, og en ægte fortsættelse gør aldrig det, for captionen tilhører tabellen, der allerede startede på forrige side. TableStartsWithCaptionRow indkoder præcis det: Fragmentet har mindst to kolonner og indeholder en celle med RowIndex = 0, ColumnIndex = 0 og ColumnSpan = ColumnCount. Tjekket kører kun på det senere fragment, så en tabel, hvis egen caption-række sidder på dens første side, er upåvirket; captionen er på side N, og kun side N+1-fragmentet inspiceres
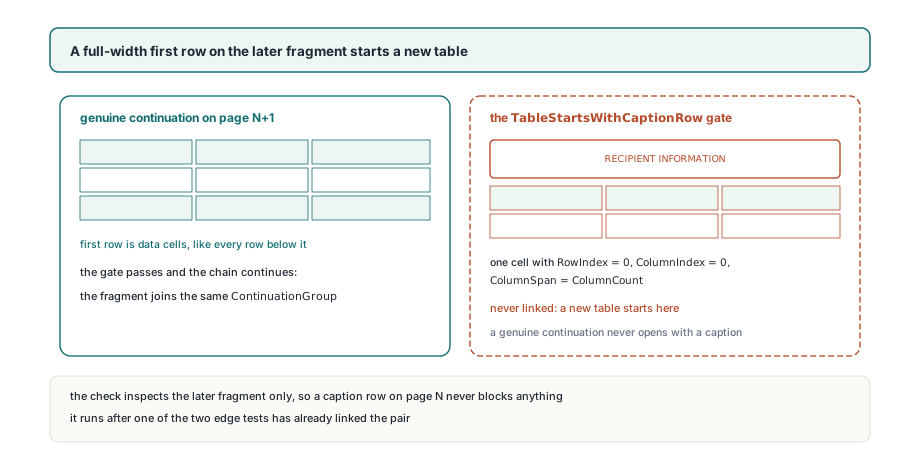
Kolonne-sammenligningen, der følger, TablesHaveMatchingColumns, er strengere end "samme kolonneantal". Den genopbygger hver fragments grænsepositioner ud fra celle-rektanglerne, interpolerer grænser, som flettede celler skjuler, og afviser parret, når en hvilken som helst grænse driver mere end tolerancen. To fire-kolonne-tabeller med forskellige proportioner holder sig derfor adskilt, selv når alt andet stemmer
Hvad sker der med en enkelt række, der spilder over på næste side?
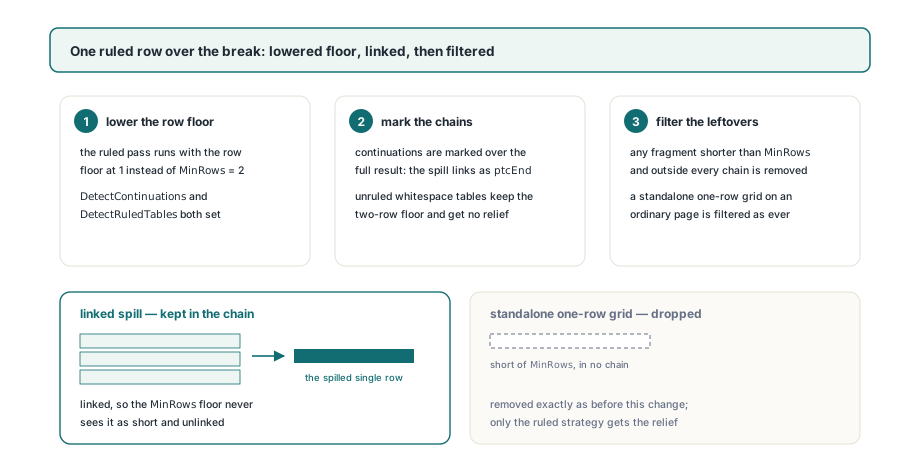
Et linjeret gitter, der bærer én række over på den følgende side, detekteres og kædes nu, forudsat at det ender i en fortsættelseskæde; på egen hånd kasseres det. Default-MinRows på 2 findes for at forhindre et løst par linjer i at blive rapporteret som en tabel, men en sidste række, der skubbes over skiftet, er en rigtig række, som et hårdt gulv på 2 lydløst droppede, og resten af tabellen så komplet ud, når den ikke var. Dokument-niveau-scanningen håndterer det i tre trin. Når DetectContinuations og DetectRuledTables begge er sat, kører per-side-passet den linjerede detektor med rækkegulvet midlertidigt sænket til 1, hvilket er grunden til, at ExtractTables nu accepterer MinRows på 1 for linjerede gitre, mens whitespace-detektering beholder et internt gulv på 2. Fortsættelser markeres over hele resultatet. Derefter fjernes hver tabel, der er kortere end callerens MinRows og ikke er en del af nogen kæde. Én-række-fragmentet overlever kun, fordi det blev kædet, og et ét-række-gitter midt på en ellers almindelig side filtreres fra præcis som før
// Genopbyg hver kæde som én CSV og drop gentagne header-rækker
// på fortsættelsesfragmenterne
procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R: Integer;
  Lines: TStringList;
  Csv: TStringList;
begin
  Csv := TStringList.Create;
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      if Tables[I].Continuation in [ptcNone, ptcStart] then
        Csv.Clear;
      Lines.Text := string(Tables[I].ToCsv);
      if (Tables[I].Continuation in [ptcMiddle, ptcEnd]) and
         (Lines.Count > 1) and (Tables[I].RowCount > 1) then
        Lines.Delete(0);            // header gentaget af tekstbehandleren
      for R := 0 to Lines.Count - 1 do
        Csv.Add(Lines[R]);
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Csv.SaveToFile(Format('%s\page%d-group%d.csv',
          [Folder, Tables[I].PageNumber, Tables[I].ContinuationGroup]));
    end;
  finally
    Lines.Free;
    Csv.Free;
  end;
end;
To detaljer i den rutine er bevidste. Én-række-spillet strippes aldrig, fordi vagten på RowCount beholder den, og et tekstbehandlingsprogram, der gentager header-rækken på hver side, producerer et fragment, hvis første linje er headeren igen, så at droppe linje nul på middle- og end-fragmenter er rigtigt for det tilfælde og forkert for en generator, der ikke gentager headers. Tjek ét dokument, før rutinen slippes løs på en mappe
Hvor reglerne stadig stopper
Det indholdsbevidste tjek er kun så godt som det tekstlag, det læser. På en scannet side uden tekst overhovedet falder de registrerede brødtekst-ekstremer tilbage til sidegrænserne, betingelsen "intet imellem" er vakant opfyldt, og kun caption-række- og kolonne-portene resterer. Et linjeret gitter på en sådan side findes stadig som et tomt skelet, så kæden kan kæde korrekt, men intet omkring den omgivende tekst var faktisk verificeret. Tilføj et tekstlag først, hvis det betyder noget. Sidefødder renderet som billeder frem for tekst er usynlige for båndlogikken og harmløse af samme grund
Båndene er ét tal. En sidefod dybere end ContinuationMargin efterlader sine nederste linjer inde i brødtekstzonen, hvilket får det tidligere fragment til at se fulgt af tekst ud og blokerer kædningen; hæv optionen til den rigtige bånddybde, som det første eksempel gør. Hæver du den for meget, glider et kort afsluttende afsnit nær sidens bund ind i båndet og ignoreres, hvilket kæder en tabel til hvad end der følger den. Caption-reglen har et spejlvendt fejlbillede: En generator, der skriver et flettet "continued"-banner som første række af hvert fortsættelsesfragment, får de fragmenter afvist som nye tabeller, og den eneste udvej i dag er at sy efter ContinuationGroup selv uden at løsne noget, for reglen har ingen kontakt
Whitespace-detekterede tabeller får ingen af den enkelt-række-lettelse. Whitespace-strategien behøver to alignede rækker for overhovedet at se en tabel, så en ulinjeret tabel, der spilder én række, rapporteres stadig kort med den række. Når du rammer det, giver ord-boksene bag strukturerede tekstblokke og læseretning dig de rå positioner til at redde den. På det eksempelsæt, der drev dette arbejde, tretten tekstbehandlings- og browser-eksporter, kædede alle fem dokumenter med ægte fler-sidede tabeller sig ind i enkeltkæder, og transskript-formularen, der tidligere smeltede sammen, holdt sig adskilt, hvilket er den målestok, udgivelsen blev målt mod, ikke et løfte om hvert layout
Fortsættelsesmarkering, caption-reglen og enkelt-række-passet bor alle i dokument-niveau-stien, der deles af Delphi-, C++Builder- og Lazarus-builds; den fulde tabel-ekstraktions-API er beskrevet på siden PDFium Component til Delphi