Symptomet dukkede op i et sidekopieringsværktøj bygget oven på HotPDF Delphi Component: at bede om side 1 i et dokument på tre sider producerede konsekvent side 2. Ved at kontrollere indekseringslogikken fandt vi intet galt. Opkaldet brugte et 0-baseret logisk indeks, aritmetikken var korrekt, grænsebetingelserne var fine. Alligevel kom den forkerte side ud hver gang
Fejlen lå slet ikke i kopieringskoden. Det var i, hvordan HotPDF opbyggede sit interne sidearray ved indlæsning af filen
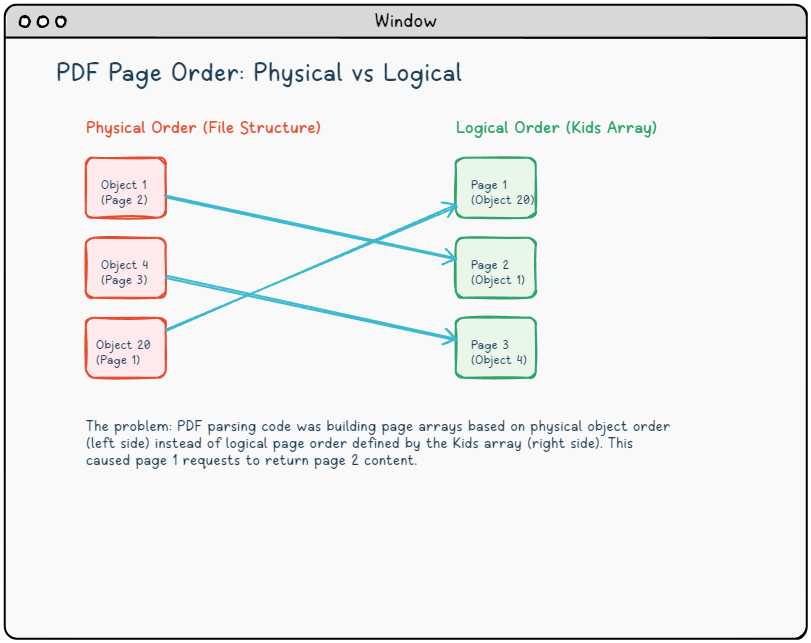
To rækkefølger, én kilde til forvirring
En PDF-fil er en samling af indirekte objekter, der hver er identificeret ved et objektnummer. Filstrukturen pålægger ingen forpligtelse til, at disse numre afspejler læserækkefølgen. Objekt 1 kan indeholde side 2; objekt 20 kan indeholde side 1. Det, der faktisk definerer læserækkefølgen, er sidetræet: et hierarki af /Pages-ordbøger, hvis /Kids-arrays lister sidereferencer i den sekvens, en fremviser skal vise dem (ISO 32000-1 §7.7.3)
Dokumentet, der udløste fejlen, havde denne sidetræstruktur:
{ Roden af Pages-træet, objekt 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { logical page 1 }
         1 0 R    { logical page 2 }
         4 0 R]   { logical page 3 }
>>
endobj
Filen listede tilfældigvis objekt 1 og objekt 4 før objekt 20 i bytestrømmen. Enhver parser, der itererede gennem indirekte objekter i filrækkefølge og stemplede dem ind i et PageArr, da den fandt sidetypeordbøger, ville ende med objekt 1 ved indeks 0, objekt 4 ved indeks 1 og objekt 20 ved indeks 2. Logisk side 1 sidder på PageArr[2]. At bede om sideindeks 0 henter i stedet logisk side 2
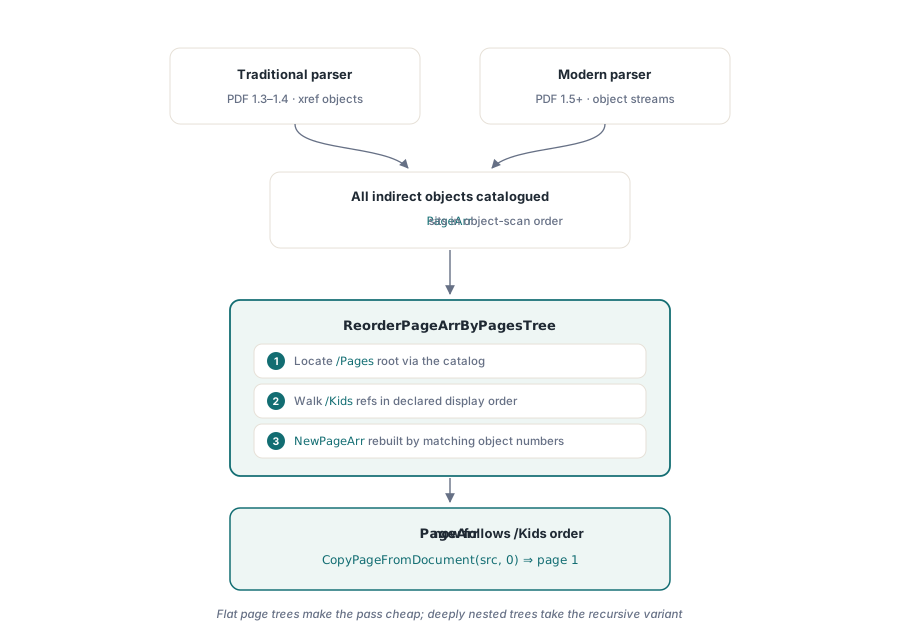
Det er præcis, hvad begge HotPDF's interne analysestier gjorde. Den traditionelle sti, der bruges til PDF 1.3/1.4-filer, og den moderne sti, der bruges til objektstrømsdokumenter (PDF 1.5+), byggede hver PageArr ved at gå gennem indirekte objekter i fysisk filrækkefølge frem for at følge /Kids-kæden
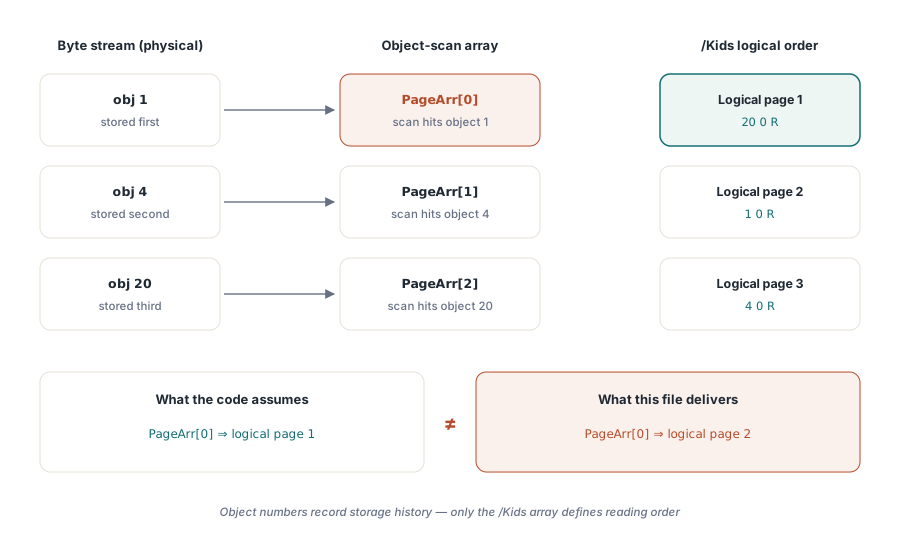
Bekræftelse af hypotesen
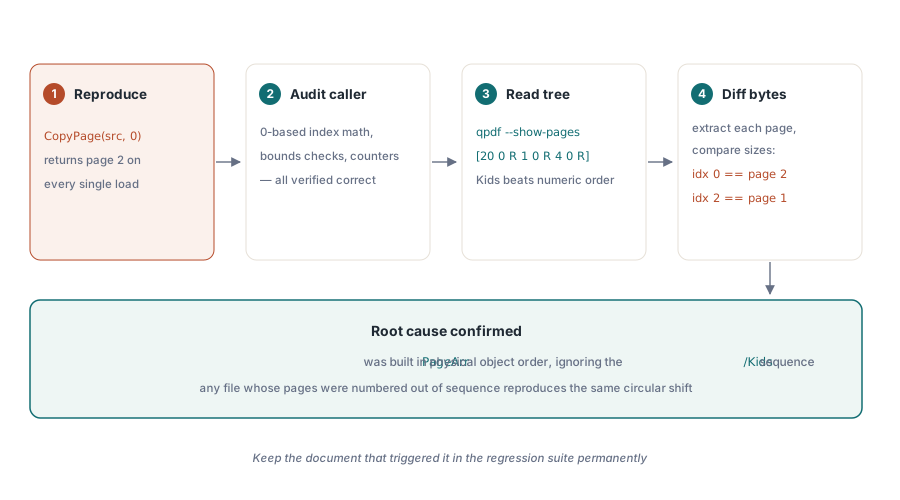
Før der blev rørt ved en rettelse, skulle uoverensstemmelsen bevises snarere end antages. Kommandolinjeværktøjet qpdf gør dette ligetil:
{ shell }
qpdf --show-pages input.pdf
{ Outputtet afslører Kids-rækkefølgen: 20 0 R, så 1 0 R, så 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Viser Pages-dictionary med /Kids i læserækkefølge }
At udtrække hver side individuelt og kontrollere filstørrelser bekræftede kortlægningen: hvad PageArr[0] producerede var indholdet tilhørende logisk side 2, og PageArr[2] indeholdt logisk side 1. Den cirkulære forskydning var det rygende bevis. Dette forklarede også, hvorfor problemet dukkede op på tværs af flere forskellige kildedokumenter: enhver PDF, hvor sideobjekter tilfældigvis havde lavere objektnumre end en tidligere logisk side, ville udløse det
Der er en ligetil grund til, at PDF'er ender i denne tilstand. Inkrementelle gem-funktioner tilføjer opdaterede objekter med nye objektnumre, og efterlader de gamle pladser i krydsreferencetabellen, der ikke peger nogen steder hen. Editorer, der tilføjer en forside, indsætter den med et højt objektnummer, uanset dens position i Kids-arrayet. Nogle generatorer skriver simpelthen sider i en rækkefølge, der er praktisk til indholdsstreaming snarere end logisk sidesekvens. PDF-formatet kræver ikke, at de gør andet
Rettelsen: Følg Kids-arrayet
Den korrekte tilgang er at bygge PageArr ved at gå /Kids-kæden fra katalogroden, ikke ved at scanne indirekte objekter. Efter at begge analysestier fuldender deres indledende gennemgang, løser et efterbehandlingstrin den logiske rækkefølge:
procedure THotPDF.ReorderPageArrByPagesTree;
var
  PagesObj  : THPDFDictionaryObject;
  KidsArray : THPDFArrayObject;
  NewPageArr: array of THPDFDictArrItem;
  I, J, PageIndex, KidsIndex: Integer;
  RefObj    : THPDFLink;
  PageObjNum: Integer;
  Found     : Boolean;
begin
  { Find rod-/Pages-dictionary via FRootIndex }
  PagesObj := FindPagesRootFromCatalog;
  if PagesObj = nil then Exit;

  KidsIndex := PagesObj.FindValue('Kids');
  if KidsIndex < 0 then Exit;
  KidsArray := THPDFArrayObject(PagesObj.GetIndexedItem(KidsIndex));

  SetLength(NewPageArr, KidsArray.Items.Count);
  PageIndex := 0;

  for I := 0 to KidsArray.Items.Count - 1 do
  begin
    RefObj     := THPDFLink(KidsArray.GetIndexedItem(I));
    PageObjNum := RefObj.Value.ObjectNumber;

    Found := False;
    for J := 0 to Length(PageArr) - 1 do
    begin
      if PageArr[J].PageLink.ObjectNumber = PageObjNum then
      begin
        NewPageArr[PageIndex] := PageArr[J];
        Inc(PageIndex);
        Found := True;
        Break;
      end;
    end;
    { Kids der ikke er sider (mellemliggende /Pages-noder) giver intet match; spring over }
  end;

  if PageIndex > 0 then
  begin
    SetLength(PageArr, PageIndex);
    for I := 0 to PageIndex - 1 do
      PageArr[I] := NewPageArr[I];
  end;
end;
Opkaldet indgår i slutningen af hver analysesti, efter at alle objekter er blevet katalogiseret, men før der foretages nogen sideoperation:
{ Traditional path }
ListExtDictionary(THPDFDictionaryObject(IndirectObjects.Items[I]), FPageslink);
ReorderPageArrByPagesTree;
Break;

{ Modern path (object streams) }
if TryParseModernPDF then
begin
  Result := ModernPageCount;
  ReorderPageArrByPagesTree;
  Exit;
end;
Genordningstrinnet er O(n * m), hvor n er Kids-antallet og m er den aktuelle PageArr-længde, men for ethvert dokument med et fladt sidetræ (alle blade på dybde 1, som dækker langt størstedelen af den virkelige verdens PDF'er) er begge den samme værdi, og omkostningerne er ubetydelige. Dybt indlejrede sidetræer kræver en rekursiv gåtur frem for enkelttilgange vist her; produktionsimplementeringen håndterer det tilfælde separat
Brug af CopyPageFromDocument efter rettelsen
Med ReorderPageArrByPagesTree på plads, fungerer logiske sideindekser som forventet. Det højere niveau CopyPageFromDocument tager et 0-baseret logisk indeks og kopierer den korrekte side ind i destinationsdokumentet:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Kopiér logisk side 0 (den første side brugeren ser) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
CopyPageFromDocument forespørger internt sidetræets rækkefølge frem for at basere sig på det rå PageArr-indeks, så den opfører sig korrekt, selv mod dokumenter, hvor fysisk og logisk rækkefølge divergerer. Til batchoperationer accepterer InsertPagesFromDocument et array af logiske indekser og kopierer dem i én arbejdsgang
Hvad dette afslører om PDF-parsing
PDF-specifikationen er eksplicit: Logisk siderækkefølge er defineret af sidetræets /Kids-array, ikke af objektnumre eller byteforskydninger (ISO 32000-1 §7.7.3.2). Enhver parser, der bruger en anden rækkefølge som en genvej, vil producere korrekte resultater på de fleste dokumenter, den ser, fordi de fleste generatorer skriver sider i den naturlige rækkefølge og tildeler fortløbende objektnumre. Fejlen skjules, indtil en person indlæser en PDF, der blev redigeret trinvist, reorganiseret af et andet værktøj eller genereret af software, der valgte et andet layout
Test kun mod selvgenererede PDF'er overser denne klasse af problemer fuldstændigt. Rettelsen til en sideordensregression har derfor brug for en samling af dokumenter fra forskellige kilder: trinvise gem-funktioner, scannede dokumenter med indsatte forsider, PDF'er produceret af værktøjer, der lineariserer eller optimerer objektgrafikken forskelligt. Et dokument, der udløste den oprindelige fejl, bør forblive permanent i regressionspakken
HotPDF Delphi Component-siden dækker hele API'et til sideoperationer, herunder CopyPageFromDocument, InsertPagesFromDocument og MovePage