Skriv =NORM.DIST(115,100,15,TRUE) i en celle, og Excel returnerer 0.8413447 uden videre. Kaldet læses som et opslag. Det er det ikke. Bag det ene tal ligger den kumulative normalfordeling, et integral uden lukket form, og bag CHISQ.INV.RT og BETA.DIST sidder specialfunktioner, som et omhyggeligt bibliotek skal evaluere, ikke approksimere i hånden. En regnearkskomponent, der hævder Excel-kompatibilitet, skal reproducere disse værdier til det sidste ciffer, Excel viser, hvilket betyder at reproducere de numeriske metoder, ikke blot funktionsnavnene
HotXLS implementerer mere end halvtreds af disse statistiske funktioner, og det arbejde, der gør dem korrekte, er næsten helt usynligt fra formellinjen. Dette er en rundtur i, hvordan motoren beregner dem: den delte specialfunktionskerne, de grenbeslutninger, der holder aritmetikken stabil, og én invers-normal-fejl, der gemte sig i halen i lang tid, fordi det almindelige tilfælde aldrig rørte den ødelagte linje
Ét regnearkskald, halvtreds fordelinger bag det
Funktionerne spænder over de familier, en statistikarbejdsbog rækker ud efter. Der er normalfamilien, NORM.DIST og NORM.S.DIST med deres inverser; gamma- og chi-i-anden-familien, GAMMA.DIST, CHISQ.DIST, CHISQ.DIST.RT, CHISQ.INV.RT; betafamilien, BETA.DIST og BETA.INV; stikprøvefordelingerne T.DIST, T.DIST.2T, F.DIST og F.INV; det diskrete par BINOM.DIST og POISSON.DIST; og inferenshjælperne såsom CONFIDENCE.T og CONFIDENCE.NORM. Set fra kalderens plads er hver af dem en enkelt formel. Du sætter input i celler, beder arbejdsbogen om at evaluere og læser resultatet
var
  wb: IXLSWorkbook;
  sh: IXLSWorksheet;
begin
  wb := TXLSWorkbook.Create;
  sh := wb.Sheets.Add;
  sh.Range['A1', 'A1'].Value := 115;   // observation
  sh.Range['A2', 'A2'].Value := 100;   // middelværdi
  sh.Range['A3', 'A3'].Value := 15;    // standardafvigelse

  // XLS-formelparseren bruger ';' som argumentseparator.
  Writeln(wb.Calculate('=NORM.DIST(A1;A2;A3;TRUE())'));   // 0.8413447
  Writeln(wb.Calculate('=CHISQ.INV.RT(0.05;10)'));        // 18.3070381
  Writeln(wb.Calculate('=BETA.DIST(0.5;2;3;TRUE())'));    // 0.6875
end;
Metoden Calculate på arbejdsbogen kompilerer og evaluerer en ad hoc-formel mod det aktive ark og giver en Variant tilbage. Én detalje snubler folk over i første forsøg: formelparseren bag Calculate tager semikolon som sin argumentseparator, så det er =SUM(A1;B1), ikke =SUM(A1,B1). Gemte celleformler beholder det Excel-standardiserede komma. Den samme evaluator sender hver statistisk funktion nedenfor videre, så når én af disse virker i Calculate, følger resten den samme sti
De to funktioner, alt andet er bygget på
De fleste kumulative fordelinger i dette sæt beregnes ikke ved at summere eller integrere deres egne definitioner. De beregnes ud fra to specialfunktioner: den regulariserede nedre ufuldstændige gammafunktion, skrevet P(a, x), og den regulariserede ufuldstændige betafunktion, skrevet Ix(a, b). Internt er det de hjælpere, dispatcherne læner sig op ad, og kæden er kort. Chi-i-anden-CDF'en er gamma-CDF'en med form df/2 og skala 2. Gamma-CDF'en er P(a, x) direkte. De kumulative t-, F- og binomialfunktioner er alle værdier af den regulariserede ufuldstændige betafunktion ved de rette argumenter. Poissons CDF er den øvre ufuldstændige gammafunktion Q. Implementér gamma- og betafunktionerne godt, og et dusin fordelinger arver deres nøjagtighed gratis
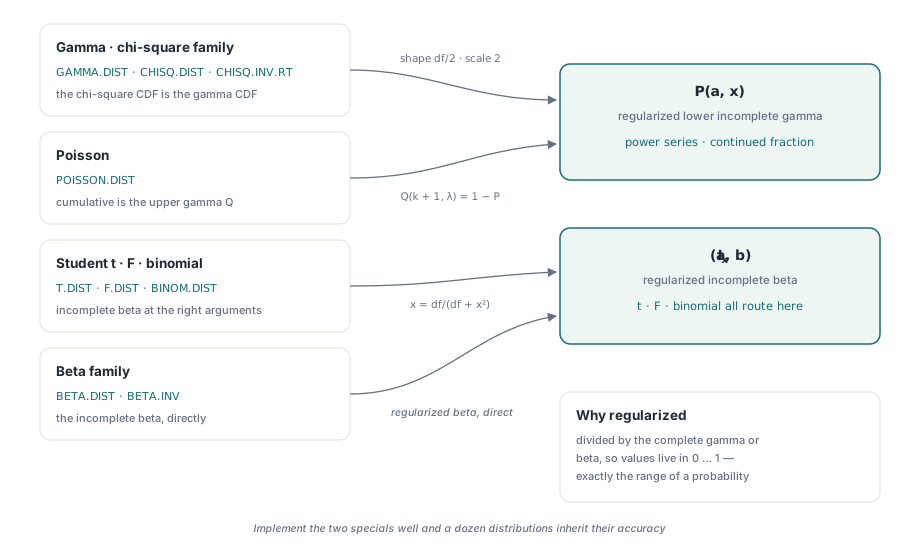
Ordet "regulariseret" er hele pointen. Den rå ufuldstændige gammafunktion vokser som en fakultet, og det rå betaintegral kan underflowe eller overflowe længe før svaret gør. De regulariserede former er divideret igennem med den komplette gamma- eller betafunktion, så de lever helt inden for intervallet fra nul til én, hvilket er præcis det interval, en sandsynlighed optager. Den normalisering er det, der lader den samme rutine betjene en chi-i-anden med to frihedsgrader og én med to hundrede, uden at de mellemliggende led løber ud over enden af en double. Den forklarer også, hvorfor du ikke beregner en CDF ved at lægge en lang hale af tæthedsled sammen: hvert led bærer sin egen afrundingsfejl, fejlene akkumuleres, mens rækken løber, og den regulariserede specialfunktion omgår summen helt ved i stedet at evaluere en hurtigt konvergerende række eller kædebrøk
Række under diagonalen, kædebrøk over den
Rutinen for den ufuldstændige gammafunktion træffer én beslutning, før den beregner noget som helst: den sammenligner x med a + 1. Den grænse er ikke vilkårlig. Potensrækkeudviklingen af P(a, x) konvergerer hurtigt, når x er lille i forhold til a, og langsomt, til sidst ubrugeligt, når x er stor. Kædebrøken har den modsatte karakter. Så motoren bruger potensrækken for x under a + 1 og en Lentz-kædebrøk for x på eller over a + 1, og hver gren bliver kun bedt om at gøre det arbejde, den er god til
Kædebrøken har brug for én sikring. Lentz' metode virker ved at føre en løbende tæller og nævner og invertere nævneren ved hvert trin, og hvis en af dem nærmer sig nul, eksploderer inverteringen. Rettelsen er et lille gulv: når et mellemled falder under omtrent 1e-30 i størrelse, klemmes det til 1e-30, hvilket holder rekursionen endelig uden at forstyrre den konvergerede værdi. Den samme klemning optræder i den ufuldstændige betafunktions kædebrøk af samme grund. Det er en lille konstant, der udfører bærende arbejde, forskellen mellem en stabil evaluering og en division med noget, der ikke kan skelnes fra nul
Den øvre hale, Q(a, x), er simpelthen 1 minus P(a, x), og det er sådan, Poissons kumulative gren beregnes: sandsynligheden for højst k hændelser med middelværdi λ er Q(k + 1, λ). At sende den gennem den øvre ufuldstændige gammafunktion frem for at summere k + 1 Poisson-led er, igen, et valg om at evaluere ét konvergent udtryk i stedet for at akkumulere mange små
Diskrete punktsandsynligheder uden fakultetsoverflow
De diskrete fordelinger rejser en anden fare. En binomial punktsandsynlighed involverer en binomialkoefficient, og koefficienten for tooghalvtreds over seksogtyve er et enormt heltal. Dan den direkte, og tælleren overflower en double før den division, der ville bringe den tilbage til en fornuftig sandsynlighed. Motoren danner den aldrig. Den beregner fakulteterne i log-rum gennem log-gammafunktionen, lægger loggene sammen og trækker dem fra, folder loggen af succes- og fiaskosandsynlighederne ind og eksponentierer én gang til allersidst
// Binomial punktsandsynlighed, evalueret udelukkende i log-rum.
// LnGammaF(n+1) er ln(n!); de tre log-fakulteter danner ln(C(n,k)),
// og hele eksponenten bygges før ét eneste Exp-kald.
//   ln P(X=k) = ln(n!) - ln(k!) - ln((n-k)!) + k*ln(p) + (n-k)*ln(1-p)
result := Exp(LnGammaF(nt + 1) - LnGammaF(kk + 1) - LnGammaF(nt - kk + 1)
  + kk * Ln(pp) + (nt - kk) * Ln(1 - pp));
Selve log-gammafunktionen er en Lanczos-approksimation, nøjagtig over hele den positive akse og billig at evaluere. Fordi hver stor størrelse holdes som sin logaritme indtil det afsluttende Exp, er det største tal, rutinen nogensinde materialiserer, selve sandsynligheden, som højst er én. Poissons punktsandsynlighedsfunktion følger samme opskrift, med det enkelte log-gamma-led i stedet for fakultetet i nævneren. De lukkede former særbehandles ved kanterne, hvor p er præcis nul eller én, så koden aldrig kalder Ln(0). HotXLS returnerer 0.2460938 for BINOM.DIST(5,10,0.5,FALSE) og 0.6766764 for den kumulative POISSON.DIST(2,2,TRUE), hvilket matcher Excel gennem de cifre, det udskriver
Inverser ved at indkredse den fremadrettede kurve
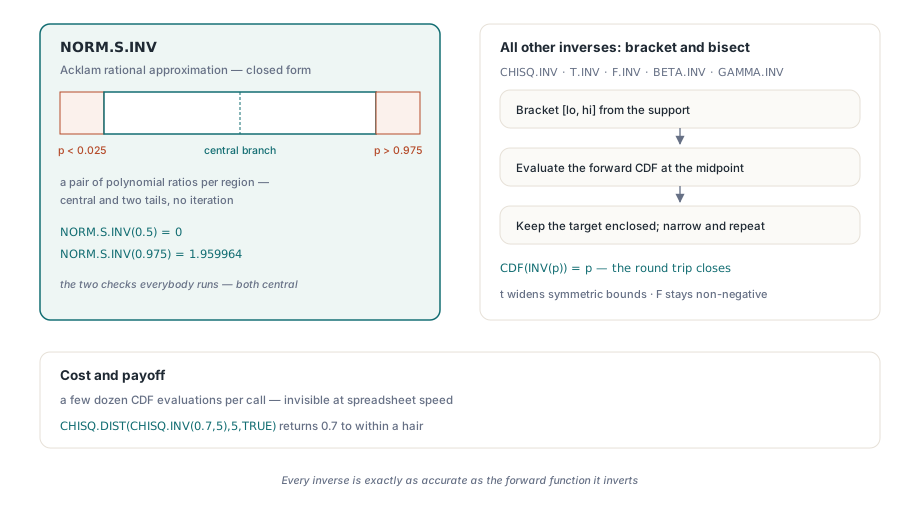
En invers fordelingsfunktion stiller det modsatte spørgsmål: givet en sandsynlighed, find den værdi, hvis CDF er lig med den. Kun én invers i dette sæt har en hurtig direkte formel. NORM.S.INV, den inverse standardnormalfordeling, bruger en Acklam-rationalapproksimation, et par polynomiumsforhold, der er nøjagtige til omtrent en doubles præcision over hele intervallet, opdelt i et centralt område og to haler. Det er en evaluering i lukket form uden iteration
De andre inverser har ingen sådan formel, så motoren inverterer dem numerisk. Den indkredser svaret med en nedre og en øvre grænse valgt fra fordelingens støtte og halverer derefter: evaluér den fremadrettede CDF i midtpunktet, flyt den grænse, der holder målsandsynligheden indesluttet, og gentag, indtil intervallet er smalt. For gamma- og chi-i-anden-inverserne starter indkredsningen ved nul og et rundhåndet øvre estimat bygget ud fra form og skala, hvor den øvre grænse fordobles, hvis sandsynligheden endnu ikke er indesluttet. t-inversen indkredser symmetriske grænser, der udvides udad; F-inversen halverer på et ikke-negativt interval. Omkostningen er nogle få dusin CDF-evalueringer pr. kald, hvilket er usynligt ved regnearkshastighed, og fordelen er, at hver invers er præcis lige så nøjagtig som den fremadrettede funktion, den inverterer. Det er derfor, en rundtur som CHISQ.DIST(CHISQ.INV(0.7,5),5,TRUE) returnerer 0.7 på et hår nær
Titalslogaritmen, der gemte sig i halen
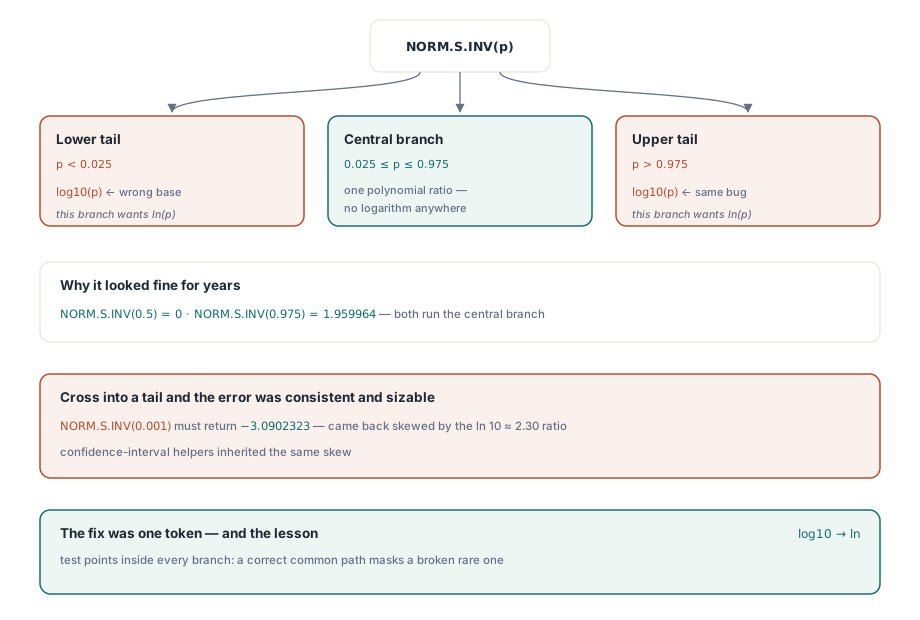
Her er den fejl, der er værd at fortælle om, fordi det er den slags, der overlever længe. Acklams invers-normal-rutine har tre grene. Den brede centrale gren, der bruges, når sandsynligheden ligger mellem cirka 0.025 og 0.975, sender inputtet gennem et polynomiumsforhold uden nogen logaritme nogen steder. De to halegrene, for meget små eller meget store sandsynligheder, tager hver en logaritme af inputtet først, fordi halen opfører sig som kvadratroden af minus den naturlige logaritme af p
En tidlig version af halegrenen tog en titalslogaritme, hvor den naturlige logaritme hørte hjemme. De to adskiller sig med en konstant faktor på cirka 2.30, så haleresultaterne var forkerte med en konsekvent, betydelig margin. Og alligevel så funktionen fin ud i enhver tilfældig kontrol, fordi tilfældige kontroller bor i midten. NORM.S.INV(0.5) er nul, NORM.S.INV(0.975) er lærebogens 1.959964, og begge kører gennem det centrale polynomium, der aldrig kalder en logaritme overhovedet. Fejlen viste sig først, når en sandsynlighed krydsede over i en hale, f.eks. NORM.S.INV(0.001), som skal returnere -3.0902323 og i stedet kom tilbage cirka forholdet mellem naturlig log og titalslog ved siden af. Enhver funktion, der afhænger af den inverse normalfordeling i sin hale, herunder konfidensintervalhjælperne, arvede den samme skævhed. Læren er banal og dyr: en funktion med en grenstruktur har brug for testpunkter inde i hver gren, fordi en korrekt almindelig sti med glæde maskerer en ødelagt sjælden. Rettelsen var en ændring på ét token fra titalslog til naturlig log, og haleværdierne faldt på plads med Excels
Fortegnet på x afgør t-fordelingens hale
Den kumulative Student t-funktion bærer en subtilitet, der er nem at få bagvendt. Dens værdi kommer fra den regulariserede ufuldstændige betafunktion evalueret i df / (df + x²), men den betaværdi er sandsynligheden i halen ud over størrelsen af x, ikke den kumulative sandsynlighed op til x. t-fordelingens symmetriske form betyder, at konverteringen afhænger af, hvilken side af nul x falder på
// Student t-CDF. ib er den regulariserede ufuldstændige beta i df/(df+x*x),
// som måler den symmetriske hale. Den kumulative værdi afhænger af
// fortegnet på x; at returnere ib ukonverteret giver den forkerte hale.
ib := BetaIF(df / 2, 0.5, df / (df + x * x));
if x > 0 then
  result := 1 - 0.5 * ib        // over middelværdien: én minus halvdelen af halen
else if x < 0 then
  result := 0.5 * ib            // under middelværdien: halvdelen af halen
else
  result := 0.5;                // præcis ved middelværdien
For x over nul er den kumulative sandsynlighed én minus halvdelen af den symmetriske hale; for x under nul er den halvdelen af den hale; ved nul er den præcis en halv. Returnér betaværdien direkte, og du rapporterer den forkerte side af fordelingen, ved siden af med hele kurvens krop for ethvert x forskelligt fra nul. Højrehale- og tohale-varianterne bygger på den samme gren, hvilket er grunden til, at T.DIST.2T(1,1) kommer tilbage som 0.5 og T.DIST(1,1,TRUE) som 0.75, og inversen T.INV halverer mod denne rettede CDF, så rundturen lukker
Intet af dette er synligt fra cellen, og det er det tilsigtede resultat. Du skriver en formel og læser et tal, der stemmer overens med Excel. Hvis du udvider motoren med din egen logik, er mekanikken i at registrere en funktion dækket i vores gennemgang af formelmotoren og brugerdefinerede funktioner, og måden, formler rækker på tværs af ark og navngivne områder, er dækket i artiklen om definerede navne og formler på tværs af ark. Det hele leveres inde i HotXLS Delphi-regnearkskomponenten til Delphi og C++Builder, sammen med de læse-, skrive-, diagram- og formaterings-API'er, der er dækket andetsteds på denne blog