At udtrække teksten fra en side er den lette halvdel af problemet. I det øjeblik en bruger skriver et ord i et søgefelt og forventer, at fremviseren hopper derhen og tegner en gul ramme omkring det, har du brug for noget, den flade tekststreng ikke kan give dig: den side, hvert match ligger på, og det rektangel, det optager i PDF-koordinater. En streng sammenkædet på tværs af en side har mistet den geometri. Du kan finde delstrengen, men du kan ikke pege på den
PDF Library for Delphi er et native Object Pascal PDF-bibliotek til Delphi og C++Builder, og fra v3.78.0 svarer det præcist på det spørgsmål. Tre query-API'er ligger oven på den eksisterende tekstblok-ekstraktor: SearchText gennemløber et sideområde og returnerer hvert hit med dets side og aksejusteret rektangel, EnumPageElements lister alt på én side (tekstblokke og indlejrede billeder på samme måde), og GetTextInAreaEx rapporterer rektanglet for hver blok inden i en region i stedet for at flade dem ud til en strengliste. Ingen af dem rører ved skrivestien; de er rene read-side-tilføjelser oven på maskineri, biblioteket allerede havde
Hvorfor geometrien ligger i tekstbloklisten og ikke i trakten
Det naturlige instinkt er at genbruge, hvad GetPageText kører internt. Den sti går gennem en midlertidig ekstraktions-"tragt", der producerer sidestrengen og derefter frigør sig selv, før kaldet returnerer. Når du sidder med resultatet, er koordinaterne pr. blok væk. De var aldrig dine at beholde
Koordinaterne overlever derimod i en anden struktur. ExtractPageTextBlocks(3) returnerer et tekstblok-liste-handle, hvis elementer hver bærer en otte-double afgrænsningsfirkant, et fontnavn, en fontstørrelse og blokkens tekst. Det handle er det eneste sted, geometrien bevares efter ekstraktion, hvilket er grunden til, at hver eneste af de nye query-API'er er bygget på det i stedet for på tragten. At genbruge blokliste betyder, at søgning, enumerering og regionsforespørgsler alle deler ét ekstraktionspas og én definition af, hvor en blok er
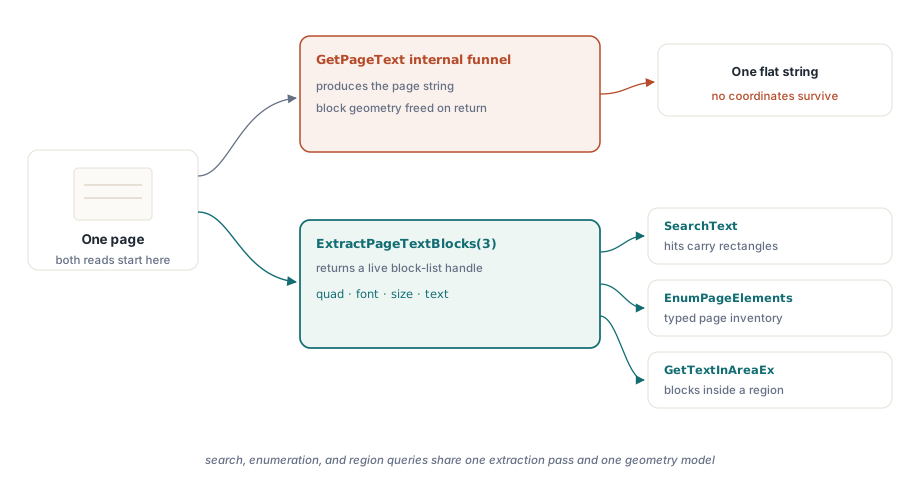
Så formen på SearchText følger af den begrænsning. For hver side i intervallet ekstraherer den bloklisten, læser hver bloks tekst med GetTextBlockText, tester den mod forespørgslen, og for de blokke, der matcher, reducerer den firkanten til et rektangel. Hittet, den returnerer, er en lille record:
type
  TPDFlibSearchHit = record
    Page: Integer;                       // 1-baseret side for matchet
    Left, Top, Right, Bottom: Double;    // aksejusteret hit-rektangel
    MatchText: WideString;               // blokteksten, der indeholdt forespørgslen
  end;
Bound-arrayet er X/Y-flettet, ikke fire hjørner
Det er den detalje, der bider først. GetTextBlockBound(ListID, Index, BoundIndex) tager et BoundIndex fra 1 til 8, og de otte værdier er ikke "hjørne 1, hjørne 2, hjørne 3, hjørne 4" med to felter grupperet sammen ad gangen, som du måske gætter. De er X, Y, X, Y, X, Y, X, Y: de ulige indekser er X-koordinater, de lige indekser er Y-koordinater, fire punkter i alt. Læs dem i den forkerte parring, og dit rektangel er noget vrøvl
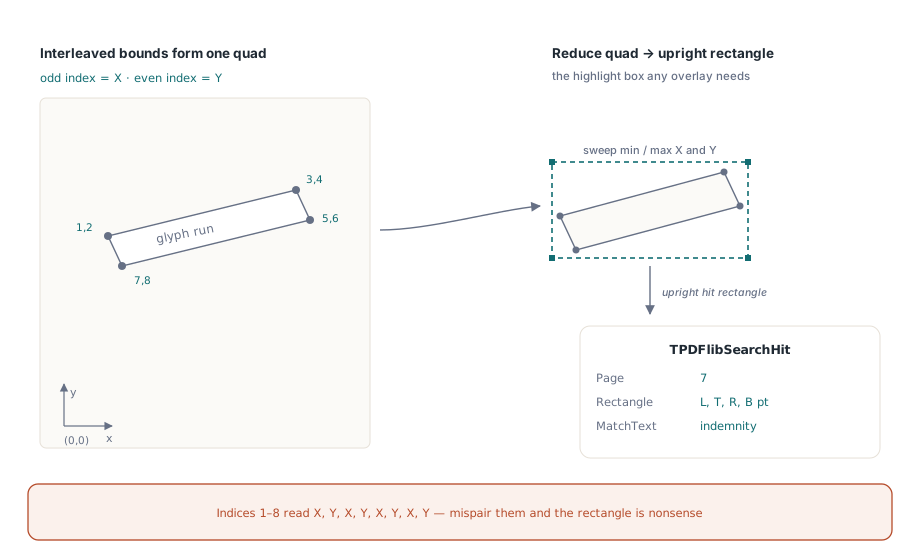
Grunden til, at der overhovedet er en firkant i stedet for et almindeligt rektangel, er rotation. En tekstblok sat i en vinkel har en ægte fire-punkts afgrænsningspolygon, og de otte doubles beskriver den trofast. Til highlight-og-hop-brugstilfældet vil du næsten altid have en opretstående boks i stedet, så biblioteket reducerer firkanten til et aksejusteret rektangel ved at gennemløbe de fire punkter for deres minimum og maksimum X og Y. Roteret tekst kollapser til den opretstående boks, der omslutter den, hvilket er, hvad et highlight-overlay skal bruge:
var
  Pdf: TPDFlib;
  Hits: array[0..255] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('contract.pdf', '');
    // Søg side 1 til 10, ikke versalfølsom, delstrengsmatch.
    Found := Pdf.SearchText('indemnity', [], '1-10', Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Format('p%d: [%.1f %.1f %.1f %.1f] %s',
          [Hits[I].Page, Hits[I].Left, Hits[I].Top,
           Hits[I].Right, Hits[I].Bottom, Hits[I].MatchText]));
  finally
    Pdf.Free;
  end;
end;
Bemærk, at rektanglet er i PDF user-space-punkter med origo i sidens nederste venstre hjørne, det samme koordinatsystem, du bruger til tegne- og annotationskald. Det er bevidst: rektanglet, du får tilbage fra et søgehit, er det rektangel, du kan give direkte videre til en highlight-annotation eller en "scroll her"-kommando uden at konvertere noget
Versalfølsomhed, hele ord og hvor CJK er anderledes
Den anden parameter er et TPDFlibSearchOptions-sæt, trukket fra soCaseSensitive og soWholeWord. Det tomme sæt [] er det almindelige tilfælde: en ikke-versalfølsom delstrengssøgning. Tilføj soCaseSensitive for at gøre Indemnity og indemnity forskellige, tilføj soWholeWord for at forhindre, at sign matcher inde i signature, eller kombinér begge
Heltordsmatching kræver en definition af, hvad en ordgrænse er, og her er reglen værd at sige ligeud, fordi den er ASCII-centreret med vilje. Et tegn tæller som en del af et ord, når det er et ASCII-bogstav, et ASCII-ciffer eller en underscore: den klasse [A-Za-z0-9_], du kender fra identifikatorregler. Et match kvalificerer kun som heltord, når tegnene lige før og efter det ikke er ordtegn (eller matchet sidder ved blokkens kant)
Konsekvensen for ikke-latinske skriftsystemer er noget, du bør vide, før du sender et flersproget søgefelt af sted. Fordi han-tegn, kana og andre ikke-ASCII-bogstaver falder uden for den klasse, læses hver grænse ved siden af dem som en ikke-ord-kant. I praksis betyder det, at heltordssøgning over CJK-tekst opfører sig, som om hver position er en gyldig ordgrænse, så flaget reelt degraderer til delstrengsmatching der. Det er en dokumenteret begrænsning, ikke en fejl, og den matcher den adfærd, funktionen blev modelleret efter. Hvis dit korpus primært er CJK, giver heltords-tilstand dig ikke den segmentering, en dedikeret tokenizer ville; planlæg efter det i stedet for at stole på det
Én implementeringsfodnote, der forklarer en klasse af subtile fejl andre steder: den ikke-versalfølsomme sammenligning bruger UpperCase på WideString, ikke AnsiUpperCase. Ansi-varianten returnerer en AnsiString, som ikke ville stemme overens med den WideString, resten af stien bruger, og at blande de to giver typemismatch og, værre endnu, tabsgivende folding for tegn uden for den aktive code page. Unicode ind, Unicode ud, hele vejen igennem
Én parser til sideområder for hele biblioteket
Den tredje parameter er en sideområde-streng som "1,3,5-9". Der er intet specialtilpasset ved, hvordan den parses: den samme PLParsePageRangeList, der understøtter PrintPages og sidekopieringsrutinerne, håndterer den også her, så et område, der printer korrekt, søger korrekt. En tom område-streng er sentinelværdien for "alle sider", i hvilket tilfælde SearchText selv bygger den fulde liste
Omfang har betydning for omkostningen. At søge i en ti-siders skive af et tusind-siders dokument ekstraherer blokke for ti sider, ikke tusind, fordi løkken kun vælger og ekstraherer de sider, området navngiver. Ved du allerede, at en klausul ligger i appendikset, så angiv det i området og spring resten af filen over
Internt ændrer både søgning og enumerering den valgte side, mens de itererer, så hver af dem gemmer den kaldende koders valgte side ved indgang og gendanner den i en finally-blok. Kald SearchText midt i opbygningen af en side, og din markering er præcis, hvor du efterlod den, når kaldet returnerer. Den gem-og-gendan-kontrakt er den slags, du kun bemærker, når den mangler, hvilket netop er grunden til, at den er der
Enumerering af en hel side: tekst og billeder i én liste
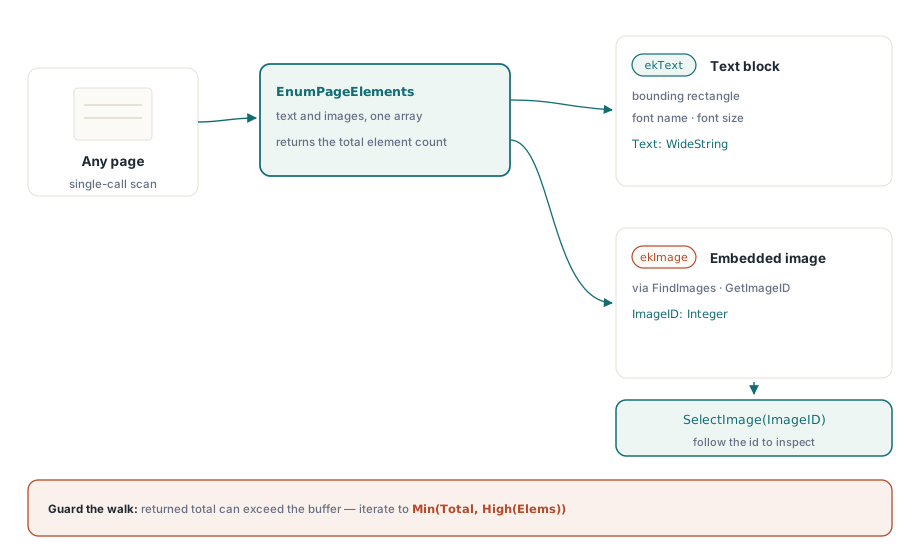
Søgning svarer på "hvor er dette ord". Den anden halvdel af introspektion er "hvad er der overhovedet på denne side", og det er EnumPageElements. Den returnerer én samlet liste, hvor hvert element enten er en tekstblok eller et indlejret billede, adskilt af et Kind-felt:
type
  TPDFlibPageElementKind = (ekText, ekImage);

  TPDFlibPageElement = record
    Kind: TPDFlibPageElementKind;
    Page: Integer;
    Left, Top, Right, Bottom: Double;
    Text: WideString;        // ekText
    FontName: WideString;    // ekText
    FontSize: Double;        // ekText
    ImageID: Integer;        // ekImage; kan bruges med SelectImage / GetImageID
  end;
Tekstelementer kommer fra det samme ExtractPageTextBlocks-pas, så hvert af dem ankommer med sit rektangel, sit fontnavn og sin størrelse allerede udfyldt. Billedelementer kommer fra sidens indlejrede billedliste via FindImages og GetImageID; det ImageID, de bærer, er det handle, du fodrer til SelectImage for at undersøge billedet yderligere. De to slags lander i ét array, så én gennemgang af en side ser alt på den
var
  Pdf: TPDFlib;
  Elems: array[0..511] of TPDFlibPageElement;
  Total, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('report.pdf', '');
    Total := Pdf.EnumPageElements(1, Elems);
    for I := 0 to Total - 1 do
      if I <= High(Elems) then
        if Elems[I].Kind = ekText then
          WriteLn(Format('text  %s/%.1f  "%s"',
            [Elems[I].FontName, Elems[I].FontSize, Elems[I].Text]))
        else
          WriteLn(Format('image id=%d', [Elems[I].ImageID]));
  finally
    Pdf.Free;
  end;
end;
Der er en tællekonvention her, der følger resten af biblioteket, og som du skal respektere, ellers læser du uinitialiseret hukommelse. Returværdien er det samlede elementantal, som kan være større end det array, du gav med. Funktionen fylder kun så mange pladser, som der er plads til, og fortsætter med at tælle resten, præcis som signatur-enumerering fungerer. Så vagten er altid den samme: begræns din løkke til den mindste af den returnerede count og High(array), iterér aldrig blindt til count. Eksemplerne ovenfor viser I <= High(...)-tjekket af den grund. Hvis returværdien overstiger din buffer, skal du oprette et større array og kalde igen
Har du brugt bibliotekets lavere-niveau tekstblok-kald, er dette det typede, geometribevidste lag oven på dem; den underliggende ekstraktion er den samme, der er beskrevet i Delphi PDF-tekst-, billede- og font-ekstraktion med PDF Library for Delphi. Og når målet ikke er "hvor er denne tekst", men "hvordan er dette dokument struktureret for hjælpeteknologi", er den parallelle read-side-historie strukturtræet for tagged PDF, som eksponerer den logiske læserækkefølge frem for det fysiske bloklayout
Regionsforespørgsler, når du allerede ved, hvor du skal kigge
Nogle gange har du slet ikke en søgeterm; du har et rektangel. En formularskabelon lægger altid fakturanummeret i det øverste højre hjørne, eller et scannet layout reserverer et fast bånd til en tabel. GetTextInAreaEx betjener det tilfælde. Det er den bounds-bærende modpart til GetTextInArea: hvor det ældre kald giver en flad strengliste tilbage for en region, returnerer det nye hver bevaret bloks rektangel sammen med dens tekst, så du lærer ikke kun, hvad der er i boksen, men hvor inden i den hver linje sidder
var
  Pdf: TPDFlib;
  Hits: array[0..63] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('invoice.pdf', '');
    Pdf.SelectPage(1);
    // Left, Top, Width, Height i PDF-punkter på den valgte side.
    Found := Pdf.GetTextInAreaEx(360, 720, 180, 60, Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Hits[I].MatchText);
  finally
    Pdf.Free;
  end;
end;
To ting at holde styr på. GetTextInAreaEx arbejder på den aktuelt valgte side, så kald SelectPage først; i modsætning til SearchText tager den ikke et område. Og en blok bevares, når den skærer forespørgselsrektanglet, ikke kun når den er fuldt indeholdt, så en linje, der spænder over grænsen, stadig kommer med. Det er som regel, hvad du vil have til en håndtegnet markeringsboks, men har du brug for streng indeslutning, kan du selv filtrere de returnerede rektangler, nu hvor du har dem
Sådan bruger du det
Den røde tråd på tværs af alle tre kald er, at geometri ikke længere er noget, du genopbygger bagefter. Et søgehit kender sin side og sin boks. Et sideelement kender sit rektangel og, for tekst, sin font. En regionsforespørgsel rapporterer, hvor hver linje falder. Det er nok til at bygge en reel find-og-highlight-funktion, et klik-for-at-lokalisere-indeks eller en layoutbevidst ekstraktor uden at gå under den offentlige API eller genopbygge tekstekstraktions-pipelinen i hånden
Disse query-API'er følger med som en del af PDF Library for Delphi Delphi PDF Library, sammen med hele tekstblok-ekstraktionslaget, de er bygget på, og resten af read-side-introspektionsoverfladen til Delphi og C++Builder