PDF Library for Delphi kan sammenlægge billeder inde i en PDF, der ser ens ud, men ikke er byte-identiske, via DeduplicateSimilarImages. Eksakt deduplikering sammenlægger kun billeder, hvis dictionaries og kodede payloads matcher; denne sammenligner i stedet, hvordan billederne faktisk ser ud, ved brug af et perceptuelt hash plus to pixelfejl-tærskler, og omdirigerer hver reference til ét enkelt kanonisk objekt
De filer, hvor dette betaler sig, er dem, der er vokset ved et uheld. En scannet batch, hvor hver side bærer det samme logo, genkodet af en anden scanner. En rapport samlet fra kilder, der hver indlejrede det samme diagram i en lidt anden JPEG-kvalitet. Et katalog, hvis miniaturebilleder blev regenereret af to værktøjer. I hvert tilfælde indeholder filen mange kopier af ét billede, og eksakt deduplikering kan ikke røre nogen af dem
Hvad "tilstrækkeligt ens" skal betyde
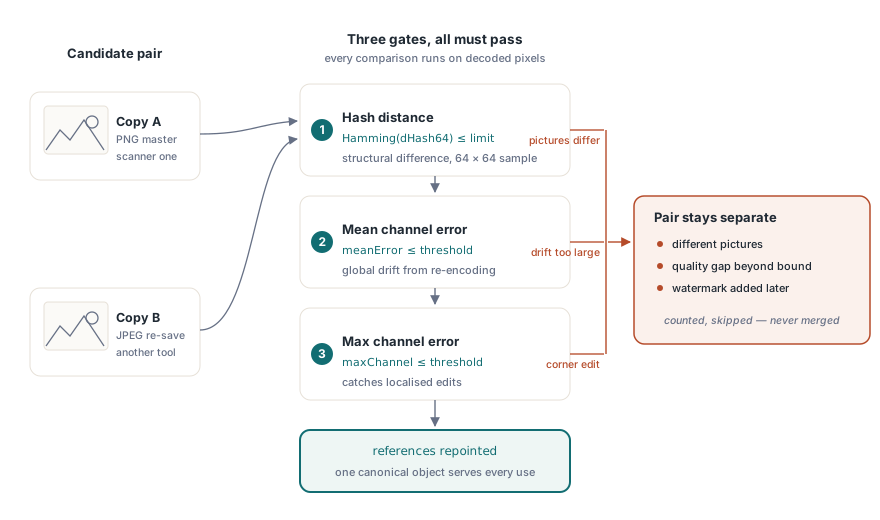
Tre tærskler skal alle være opfyldt, før to billeder sammenlægges, og hver fanger en forskellig slags forskel. Den perceptuelle hash-distance afgrænser strukturel forskel: et 64-bit forskels-hash beregnes ud fra en 64 x 64-prøve af det afkodede billede, og den tilladte Hamming-distance løber fra 0 til 7. Den gennemsnitlige kanalfejl afgrænser overordnet drift, hvilket er, hvad genkodning giver. Den maksimale enkeltkanalfejl afgrænser lokaliseret forskel, hvilket er, hvad en lille redigering giver
At kræve alle tre er, hvad der gør sammenlægningen forsvarlig. Et billede, der adskiller sig ved et vandmærke i ét hjørne, har en lav gennemsnitsfejl og en høj maksimumfejl, så maksimumfejl-porten afviser det. Et billede, der er blevet genkomprimeret, har en lille fejl overalt, så det består. Det er præcis den skelnen, en størrelsesoptimering skal drage
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // Hash-distance 2, gennemsnitsfejl 2, enkeltkanalfejl 4
    // Options kan bede om en tørkørsel, så intet ændres
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
Semantisk identitet kommer før visuel lighed
Før nogen pixels sammenlignes, skal kandidatbilleder stemme overens semantisk. Biblioteket bygger en stabil signatur ud fra hele billed-dictionary'en, undtaget /Length, /Filter og /DecodeParms, så dimensioner, farverum, bitdybde, masker, /Decode-arrayet, interpolation, medlemskab af optional content og metadata alle skal matche
Denne rækkefølge forhindrer en hel klasse af forkerte sammenlægninger. To billeder kan se identiske ud i en 64 x 64-prøve og opføre sig forskelligt på siden: ét med /Interpolate sat til true og ét uden vil blive udjævnet forskelligt, når det skaleres, og ét, der tilhører en optional content-gruppe, vil forsvinde, når det lag skjules. At sammenlægge på tværs af de grænser giver et dokument, der er mindre og forkert
Kun indirekte Image XObjects scannes. Inline-billeder er en anden konstruktion med en anden økonomi, og billeder, der ikke kan afkodes, springes konservativt over og tælles frem for at blive sammenlagt på tro og love — ingen pixel-bevis, ingen sammenlægning
Sådan holdes søgningen billig
At sammenligne hvert billede mod hvert andet billede er kvadratisk, hvilket er uacceptabelt på et dokument med tusindvis af billeder. Hashet opdeles derfor i otte 8-bit bånd med et ordnet indeks over hver
Dueslagsprincippet klarer resten: hvis to hashes adskiller sig med højst 7 bit, skal de stemme nøjagtigt overens på mindst ét af de otte bånd. At slå kandidater op bånd for bånd finder derfor hvert tilladt match uden en udtømmende parvis scanning, og den offentliggjorte grænse på 7 findes netop, fordi garantien kun holder op til den distance
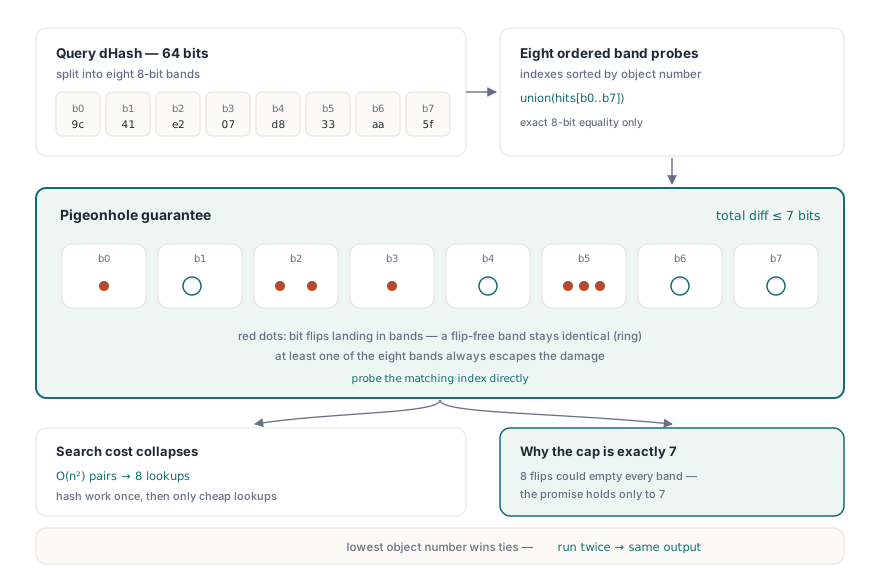
Kandidater og bånd-hits ordnes deterministisk efter objektnummer og generation, og det laveste objektnummer bliver kanonisk. Det gør outputtet reproducerbart: at køre optimeringen to gange på det samme input giver de samme kanoniske valg, hvilket betyder noget, når resultatet sammenlignes eller signeres
Tørkørsler og ærlig rapportering
Fordi dette er en lossy optimering i den forstand, at de sammenlagte billeder ikke var identiske, er det fornuftige arbejdsforløb at se sig for, før man springer. Tørkørsel-indstillingen rapporterer, hvad der ville blive sammenlagt, og hvor meget payload der ville blive frigjort, uden at ændre objektgrafen, så et batch-job kan logge effekten, og et menneske kan godkende tærsklerne én gang frem for pr. fil
To ærlige bemærkninger i rapporteringen fortjener nævnelse. Det genindvindelige tal estimerer kun den kodede payload af duplikerede streams; det tæller ikke dictionary-, indirekte objekt- og cross-reference-overhead med, så den faktiske filstørrelsesreduktion er lidt større end rapporteret frem for mindre. Og rapporten eksponerer den maksimalt accepterede fejl og sammenligningsarbejdsmængden, så du kan se, hvor tæt sammenlægningerne kom på dine tærskler
Det faste 64 x 64-prøvegitter er en bevidst approksimation, og det har en konsekvens, det er værd at sige ligeud: en forskel mindre end én prøvecelle kan gå ubemærket hen, selv ved en nul-tærskel. Ét ændret ord på en scannet side overlever muligvis ikke den prøvetagning. Når byte-niveau-bevis er påkrævet, brug den eksakte deduplikeringssti i stedet — den sammenlægger kun genuint identiske ressourcer og fælder slet ingen visuel bedømmelse
Hvor det hører hjemme i en størrelsesreduktionspipeline
Ordn passeringerne efter risiko. Kør eksakt ressourcededuplikering først, da den er tabsfri og gratis. Så skrifttype-delmængdedannelse, som også er tabsfri og som regel den største enkeltstående gevinst på teksttunge dokumenter, som dækket i optimering af PDF-filstørrelse og skrifttype-delmængdedannelse. Så billedgenkomprimering eller nedskalering, hvis målmediet tillader det. Perceptuel deduplikering hører hjemme efter dem, fordi det er det eneste trin, hvis resultat afhænger af en bedømmelse
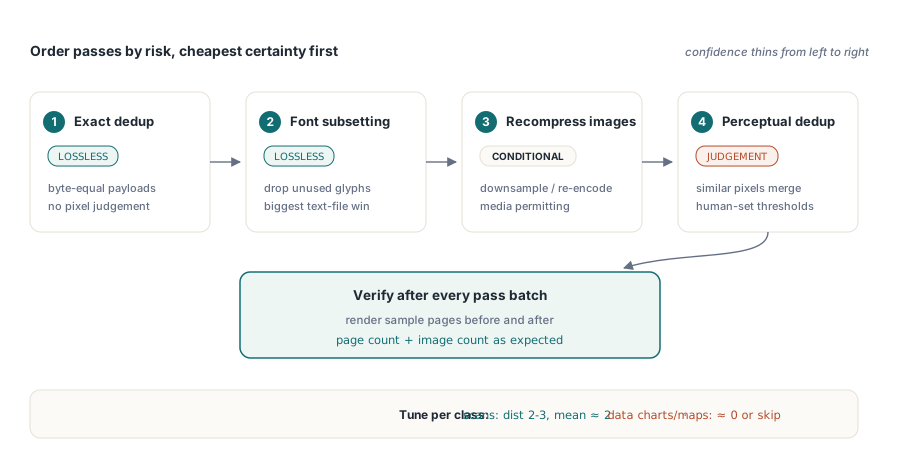
Vælg tærskler efter dokumentklasse frem for globalt. For scannede batches, hvor hver side bærer det samme brevhoved, sammenlægger en hash-distance på 2 til 3 med en gennemsnitsfejl omkring 2 brevhovedet pålideligt. For dokumenter, hvor billeder bærer data — diagrammer, kort, medicinske billeder — brug nul eller nær-nul-tærskler, eller spring passeringen helt over, fordi to diagrammer, der adskiller sig i ét plottet punkt, er to forskellige diagrammer, uanset hvor ens de ser ud ved 64 x 64
Efter optimering, verificér. Gengiv en stikprøve af sider før og efter, og sammenlign dem, og tjek, at side- og billedantallet ændrede sig, som du forventede. Inspektionsvejen for, hvad et dokument faktisk indeholder, er beskrevet i audit af PDF-filstørrelse efter kategori, hvilket også er den hurtigste måde at finde ud af, om billeder overhovedet er dit problem
Perceptuel deduplikering, eksakt ressourcededuplikering og størrelsesauditeringen kører på den samme objektgraf til Delphi, C++Builder og Free Pascal; den komplette funktionsliste findes på PDF Library for Delphi-siden