En LZW-encoderordbog er altid én post foran den decoder, der skal læse dens output, så de to sider ikke kan dele én enkelt code-width-tærskel. PDFlibPas giver TPLLZWEncoder og TPDFLZWDecompressor separate tærskler udledt fra det samme EarlyChange-flag, og det forspring på én post er hele grunden til, at flaget overhovedet findes
Næsten enhver håndrullet LZW-implementering fejler på det samme sted. Du skriver decoder'en først, fordi det er det, du skal bruge for at kunne åbne filer. Den virker. Så skriver du encoder'en, spejler decoder-logikken linje for linje, fordi LZW er symmetrisk, kører en round-trip-test, og den passerer. Du shipper. Seks måneder senere åbner en kunde dit output i en viewer, der ikke er din, og det er skrald fra et sted midt i streamen og frem. Spejlet var fejlen: De to halvdele af LZW er ikke symmetriske, og at lade som om de er, producerer streams, som kun din egen kode kan læse
Hvorfor har encoder'en brug for en anden tærskel end decoder'en?
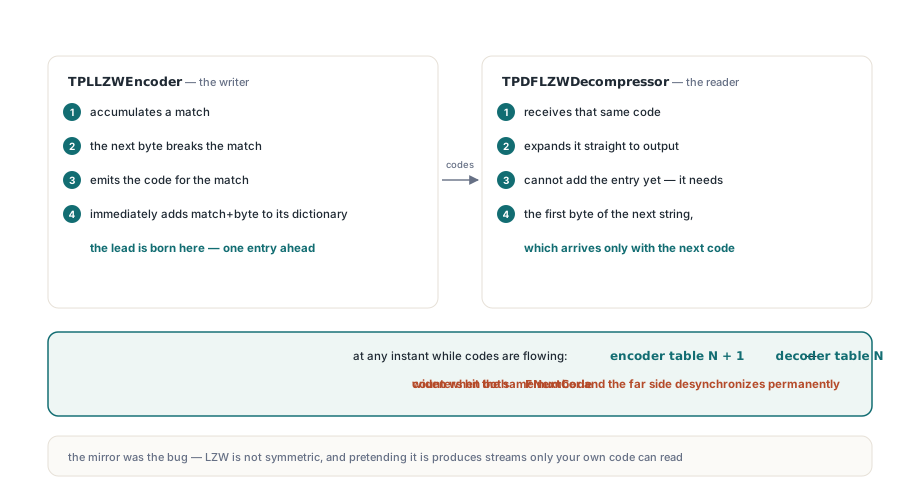
Fordi encoder'en lærer hver ordbogspost ét skridt før decoder'en kan. Det er ikke et designvalg i PDFlibPas; det ligger i selve måden, LZW fungerer på, og enhver korrekt implementering skal kompensere for det et eller andet sted. Gå løkken igennem, og du kan se, hvor forspringet kommer fra. Encoder'en akkumulerer et match, opdager at den næste byte bryder det, emitterer koden for matchet og tilføjer straks match-plus-byte til sin ordbog. Decoder'en modtager den samme kode og ekspanderer den, men den kan endnu ikke tilføje den tilsvarende post, fordi den nye post har brug for den første byte i den næste string, som kun ankommer med den næste kode. Så i ethvert øjeblik, mens koder flyder, holder encoder-tabellen én post mere end decoder-tabellen. Hvis begge sider udvider koden fra 9 til 10 bits, når deres egen FNextCode rammer samme tal, udvider de én kode fra hinanden, og bit-læseren på den anden side desynkroniseres permanent. I TPDFLZWDecompressor.ResetDictionary beregnes decoder-tærsklen én gang og gemmes i FChangeCode:
// TPDFLZWDecompressor.ResetDictionary: decoder-siden af tærsklen
FCodeSize := FInitialCodeSize;                 // 9 til PDF LZWDecode
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // udvid når FNextCode når 511
else
  FChangeCode := FBitMask + 1;                 // udvid når FNextCode når 512
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
Dekode-løkken udvider lige efter, den tilføjer en post, og tester (FNextCode = FChangeCode) and (FCodeSize < 12) og genberegner både FBitMask og FChangeCode for den nye bredde. Ni bits udløses ved 511 eller 512, ti bits ved 1023 eller 1024, elleve bits ved 2047 eller 2048, og tolv bits er loftet, hvor ordbogen skal flushes med en ClearCode i stedet for at vokse. Encoder'en kan ikke genbruge nogen af de tal. Dens GrowCodeSize lægger én til for at kompensere for forspringet, så med EarlyChange sat udvider den ved 512, mens decoder'en udvider ved 511:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 mens den er på 9 bits
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 mens den er på 9 bits
  // Decoder'en tilføjer sin sidste ventende post, før den læser EOI.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;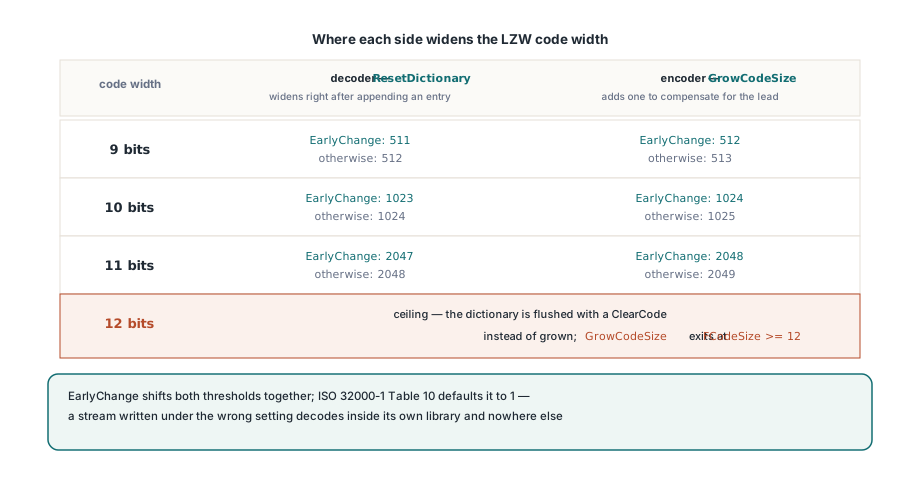
Den sidste datakode er der, hvor de to sider endelig mødes
Slutningen af streamen er det ene sted, hvor encoder'en skal stoppe med at føre an og tænke som decoder'en, hvilket er det, FinalDataCode-parameteren på GrowCodeSize er til. Emitterer du EOI-koden i den forkerte bredde, er alt før den stadig fuldstændig gyldigt, så defekten gemmer sig bag tusindvis af korrekte bytes. Sekvensen går sådan her. Encoder'en emitterer sin sidste datakode og, modsat enhver tidligere iteration, tilføjer intet til sin egen ordbog bagefter, fordi der ikke er nogen følgende byte tilbage at udvide matchet med. Decoder'en gør det modsatte: Den modtager den sidste kode, og først nu kan den fuldføre den post, den har holdt siden den forrige. På det sidste skridt indhenter decoder'en forspringet, det kollapser til nul, og den bredde, den vil bruge til at læse EOI, bestemmes af en post, encoder'en aldrig lavede. Dec(ChangeCode) er encoder'en, der i præcis ét kald lader som om, den er decoder'en:
// TPLLZWEncoder.Compress, halen af streamen
EmitCode(CurCode);      // sidste datakode, i den aktuelle bredde
GrowCodeSize(True);     // kan udvide med den dekrementerede tærskel
EmitCode(FEOICode);     // EOI i den bredde, decoder'en faktisk vil læse
FlushBits;
FlushOutput;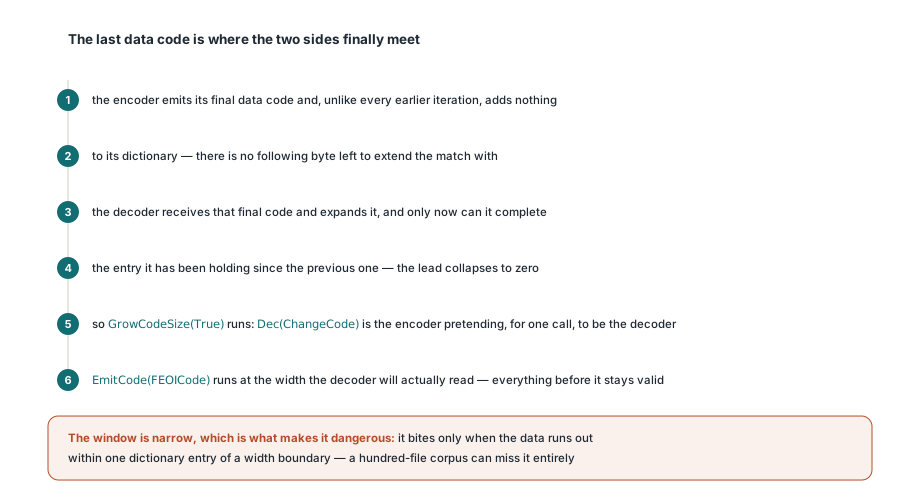
Vinduet, hvor dette betyder noget, er smalt, og det er det, der gør det farligt. Det bider kun, når dataene tilfældigvis slipper op inden for én ordbogspost fra en breddegrænse, så et korpus på hundrede testfiler kan misse det helt, mens én kundefil rammer det hver gang. Grænsetilfælde i Compress skal drives bevidst: Form inputs, hvis ordbog lander på 510, 511 og 512 poster, og læs derefter den emitterede EOI-bit-bredde ud af streamen i hånden i stedet for at udlede den fra en succesfuld afkodning
Hvorfor kan en bestået round-trip-test stadig skjule en ødelagt stream?
Fordi to implementeringer, der laver den samme fejl, er enige med hinanden. Hvis din encoder og din decoder begge udvider én kode for tidligt, eller begge én kode for sent, forbliver de i lockstep, round trippen reproducerer inputtet byte for byte, og suiten er grøn, mens den stream, du producerede, er ulæselig for alt andet. Det er det enkeltstående mest værdifulde at tage med fra hele øvelsen: For LZW er selvkonsistens intet værd som bevis. Så selv-round-tripping kan ikke være den primære test, og PDFlibPas validerer i stedet LZW-vejen på tre andre måder. Håndbyggede kodestreams med det forventede bitmønster skrevet ud i hånden, så assertionen handler om bytes frem for om resultatet af at afkode dem. Bidirektional interoperabilitet mod uafhængige implementeringer, hvor streams, denne encoder producerede, afkodes andre steder, og streams produceret andre steder afkodes af TPDFLZWDecompressor. Og differentiel afkodning, hvor de samme bytes læses to gange med EarlyChange sat begge veje, så en stream, der afkodes rent under den forkerte indstilling, fortæller dig, at breddegrænserne aldrig blev øvet overhovedet:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // bevidst den forkerte regel for PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A skal matche kilden; B må IKKE matche den. Hvis B også matcher,
// var inputtet for kort til at krydse en code-width-grænse.
Eksterne inputs er det, der faktisk giver denne dækning. Det nuværende testmateriale krydser 9, 10, 11 og 12 bit-bredder og tvinger 34 ordbogs-resets i én enkelt stream, hvilket er den eneste realistiske måde at bevise, at ClearCode-vejen ved 4095-loftet virker overhovedet. Hvis dine fixtures aldrig overstiger et par kilobyte, er ingen af den kode nogensinde kørt. Og når en fix ændrer det, din encoder producerer, så behandl det gamle output som ødelagt frem for som en kompatibilitetsbaseline værd at bevare; en stream, der blander code-widths forkert, er ikke et legacy-format, det er en bug, der tilfældigvis blev skrevet til disk
PDF siger 1, TIFF siger det kommer an på
PDFlibPas sætter EarlyChange som standard til True på både TPLLZWEncoder og TPDFLZWDecompressor, fordi ISO 32000-1 Tabel 10 definerer EarlyChange som en LZWDecode-dekodeparameter med en standardværdi på 1, hvilket betyder, at kodelængden øges én kode tidligt. Det er specificeret i ISO 32000-1 afsnit 7.4.4.2 sammen med predictor-parametrene, og en PDF, der vil have den anden adfærd, skal sige /EarlyChange 0 eksplicit i sin /DecodeParms-ordbog. TIFF er grunden til, at flaget er en property frem for en konstant: TIFF 6.0 afsnit 13 beskriver LZW-komprimering uden den samme entydige udtalelse, og encoders i felten har historisk været splittet om det, hvilket meget sandsynligt er grunden til, at PDF-specifikationen overhovedet følte behov for at navngive parameteren. På en TIFF-til-PDF-pipeline er indstillingen derfor ikke noget, du kan hardcode i nogen af enderne. Hvad end TIFF-siden viste sig at have brug for, skal bæres eksplicit ind i PDF'ens /DecodeParms, ellers konverterer du en fil, der åbnede fint, til en, der ikke gør. Den samme omhu gælder FillOrder, hvor foTop og foBottom vælger, hvilken ende af byten bit-læseren udfylder fra, og TIFF Predictor 2 horizontal differencing, som TPDFLZWParms bærer gennem Predictor, Colors, BitsPerComponent og Columns. Vores noter om at hærde den indbyggede TIFF-decoder til BigTIFF og tiled layouts dækker resten af den vej
To mindre fælder værd at navngive
Begge er nemme at koble forkert, når du har encoder- og decoder-objekterne åbne side om side og antager, at symmetrien også gælder der:
InitialCodeSizebetyder ikke det samme på de to klasser.TPLLZWEncoder.InitialCodeSizeer rod-symbolbredden, valideret til 2 til 8, hvorInitDictionaryudlederFClearCodesom1 shl FInitialCodeSizeog sætterFCodeSizetilFInitialCodeSize + 1.TPDFLZWDecompressor.InitialCodeSizeer den første code-width, valideret til 2 til 9, hvorResetDictionaryudlederFClearCodesom1 shl (FCodeSize - 1). For almindelige 8-bit PDF-data er standarderne henholdsvis 8 og 9, og du bemærker det aldrig; sæt dem begge til samme tal i hånden, og du har bygget et mismatch-par- At afkode utroværdig LZW er et memory-safety-problem, før det er et korrekthedsproblem, fordi ordbogsindekserne kommer lige ud af filen.
TPDFLZWDecompressorafviser enhver kode over 4095 eller på eller overFNextCode, nægter at tilføje poster ud over 4095, tjekker det resterende input i bits før hverGetNextCodeog eksponererSawExplicitEOI, så en caller kan skelne en korrekt afsluttet stream fra en, der bare løb tør for bytes. En trunkeret stream er ikke en delvis succes. Den bredere undersøgelse i at hærde en Pascal PDF-parser mod ondsindede filer dækker den klasse af defekter, som disse værn lukker
Hvad du står tilbage med
LZW ser symmetrisk ud og er det ikke. Encoder-ordbogen fører an med én post gennem streamens krop, og forspringet forsvinder ved den sidste kode, så en korrekt implementering bærer to tærskler plus ét specialtilfælde, og EarlyChange-flaget flytter begge tærskler samlet. Får du blot én af dem ét kode for sent eller tidligt, producerer du output, der er gyldigt lige indtil det ikke er, uden fejl og uden exception nogen steder, bare en eller anden viewer, der renderer støj. Den ærlige grænse er, at intet af dette kan testes indefra: Intet i din egen suite kan skelne en korrekt stream fra en konsekvent forkert, så interoperabilitetstjekket er ikke en valgfri ekstra pass, det er det eneste reelle bevis, du nogensinde får. Begge klasser følger med i PDF Library for Delphi, som også håndterer det omkringliggende strukturarbejde beskrevet i vores noter om object streams og cross-reference streams, for Delphi og C++Builder på tværs af de compiler-versioner, biblioteket understøtter