At sammenflette PDF'er lyder, som om det burde være billigt. Sideindholdet er allerede sat op, skrifttyperne er allerede indlejret, billederne er allerede komprimeret. I princippet er en sammenfletning bare bogholderi: nummerér objekterne om, så de to filers nummereringsrum holder op med at kollidere, sy sidetræerne sammen, ret krydsreferencetabellen til, og skriv. I praksis smider det meste sammenfletningskode den billighed væk. For hvert objekt i hver inputfil kører den en fuld parsning ind i et tokeniseret objekttræ, ændrer et par indirekte referencer og serialiserer så træet tilbage til bytes. Parsningen og genserialiseringen er de dyre halvdele, og for langt de fleste objekter producerer de en bytesekvens, der næsten er identisk med den, der kom ind
PDF Library for Delphi er en native Object Pascal PDF-motor til Delphi og C++Builder, og dens hurtige sammenfletningssti findes for at springe den rundtur over, hvor det er beviseligt sikkert. Ideen er snæver, men den betaler sig på tværs af hele dokumentmængder: for et uændret ikke-stream-objekt tages de originale kildebytes ordret, og der laves en enkelt byte-niveau-omskrivning af de indirekte referencer, de indeholder, så hver N G R bliver til (N+Offset) G R. Ingen tokenizer, intet objekttræ, ingen serializer. Denne artikel gennemgår, hvor den genvej er lovlig, den parser-tilstandsmaskine, der udfører byteomskrivningen uden at ødelægge noget, hvorfor sammenfletning af bogmærker krævede en helt anden mekanisme, og hvordan den almindelige sammenfletningssti samtidig blev genopbygget fra kvadratisk til lineær
Hvorfor objektomnummerering er den reelle pris for en sammenfletning
Hver PDF har sit eget objektnummereringsrum. Fil A har objekt 1, objekt 2, og så videre; fil B har sit eget objekt 1, objekt 2, og så videre. Du kan ikke smide B's objekter ind i A's fil uændret, fordi numrene ville kollidere, og hver indirekte reference inde i B ville nu pege på det forkerte objekt. Løsningen er en forskydning: hvis A slutter ved objektantal Offset, bliver B's objekt N til objekt N+Offset i outputtet, og hver reference N G R, der optræder et sted inde i B's objekter, skal forskydes til (N+Offset) G R for at matche
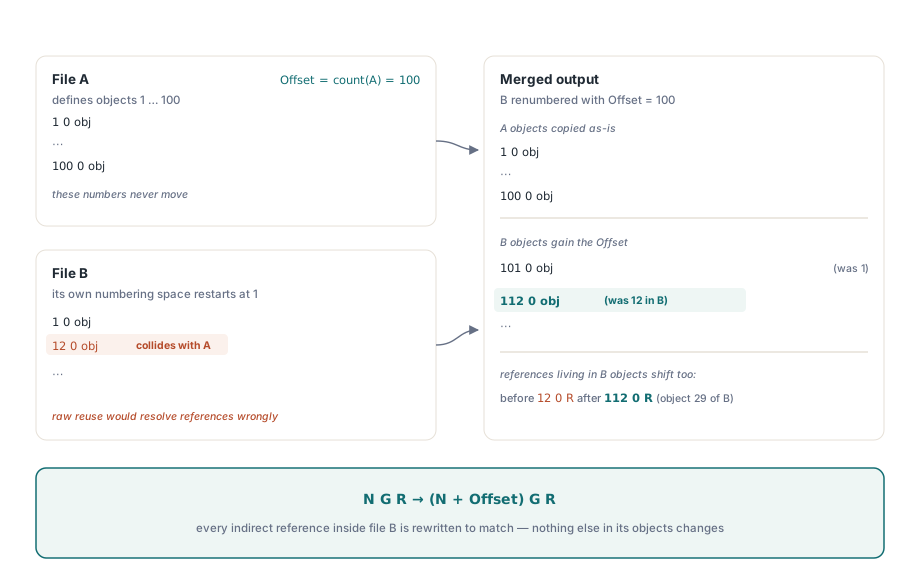
Den forskydning er hele den semantiske opgave ved at sammenflette selve indholdet. Rettelserne til sidetræet og AcroForm-sammenfletningen er små, afgrænsede redigeringer på en håndfuld objekter. Hovedarbejdet er at omskrive referencer på tværs af tusindvis af objekter, og den naive måde at gøre det på er at parse hvert objekt, så du kan finde referencerne strukturelt. PDF Library for Delphi's MergeFileListFast tager det modsatte synspunkt: referencerne kan også findes i de rå bytes, hvis du er omhyggelig med de kontekster, hvor en ciffer-mellemrum-ciffer-mellemrum-R-sekvens ikke er en reference. Spring parsningen over, forskyd på stedet, og prisen pr. objekt falder til en enkelt lineær gennemgang af bytes, du alligevel skulle kopiere
Når genbrug af kildebytes er bevist sikkert
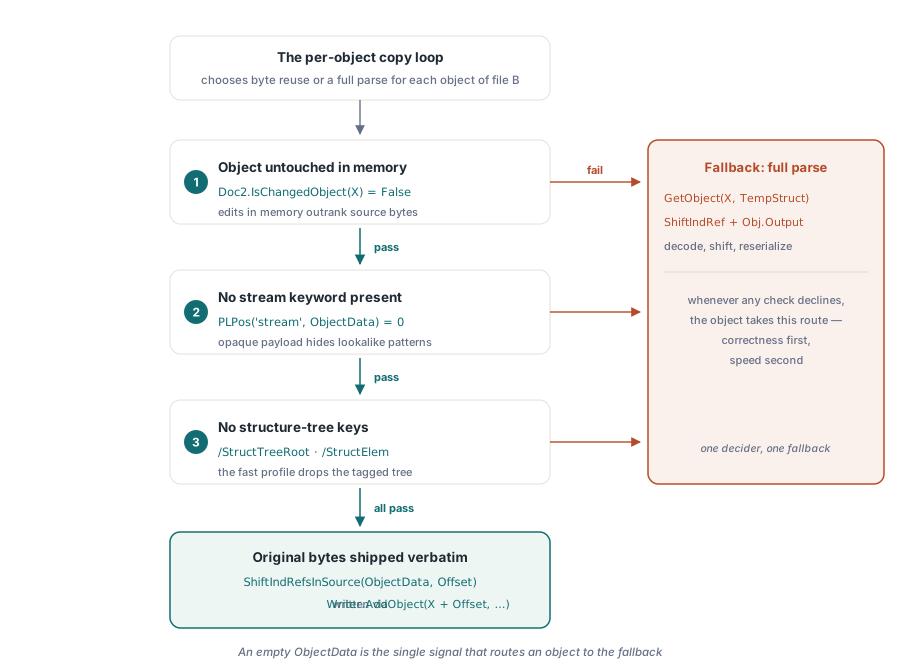
Bytestien vælges kun, når tre betingelser alle er opfyldt for det objekt, der kopieres ud af et efterfølgende dokument. Fejler bare én af dem, sendes objektet tilbage gennem den fulde afkodnings- og genserialiseringsrute, så korrekthed altid vinder over hastighed:
Doc2.IsChangedObject(X)er False. Hvis sammenfletningsmotoren allerede har ændret objektet i hukommelsen (for eksempel et sideobjekt, hvis/Parenter blevet omdirigeret), er træet i hukommelsen den autoritative kilde, og de originale bytes er forældede. Kun urørte objekter kvalificerer sig- Kildebytesne indeholder ingen
stream-nøgleord. Kroppen af et stream-objekt er uigennemsigtig binærdata indrammet afstream/endstream, og en naiv referencescanning hen over komprimerede eller krypterede streamdata ville med glæde "finde" og ødelægge bytemønstre, der ligner referencer. Stream-objekter beholder den oprindelige stream-bevidste sti - Kildebytesne indeholder hverken
/StructTreeRooteller/StructElem. I den hurtige profil droppes strukturtræet for tagged PDF i stedet for at blive sammenflettet, så de objekter skal igennem afkodningsstien, hvor motoren bevidst kan nulstille dem
Beslutningen ligger i kopieringsløkken pr. objekt. Når alle tre tjek består, går objektets bytes direkte til ShiftIndRefsInSource og derefter til writeren; ellers kasseres bytesene, og objektet genopbygges med GetObject, forskydes med ShiftIndRef og serialiseres. Strukturen af den forgrening er værd at se, fordi rækkefølgen af tjekkene er det, der holder den sikker:
ObjectData := '';
if not Doc2.IsChangedObject(X) then
begin
  ObjectData := FastMergeObjectSource(Reader2, X);
  if (PLPos('stream', ObjectData) > 0) or
     ((not PreserveStructTree) and (PLPos('/StructTreeRoot', ObjectData) > 0)) or
     ((not PreserveStructTree) and (PLPos('/StructElem', ObjectData) > 0)) then
    ObjectData := ''                                  // falder tilbage til afkodning
  else
    ObjectData := ShiftIndRefsInSource(ObjectData, Offset);
end;

if ObjectData <> '' then
  Writer.AddObject(X + Offset, Doc2.GetGenNum(X), ObjectData)
else
begin
  Obj := Doc2.GetObject(X, TempStruct);              // fuld parse-sti
  // ... nulstil struktur-træ-objekter, ShiftIndRef, Obj.Output ...
end;
En tom ObjectData er signalet om, at bytestien afviste objektet. Den ene sentinelværdi holder den hurtige og den langsomme rute fra at glide fra hinanden: der er præcis ét sted, der beslutter, og præcis ét fallback
Tilstandsmaskinen til referenceforskydning og dens kanttilfælde
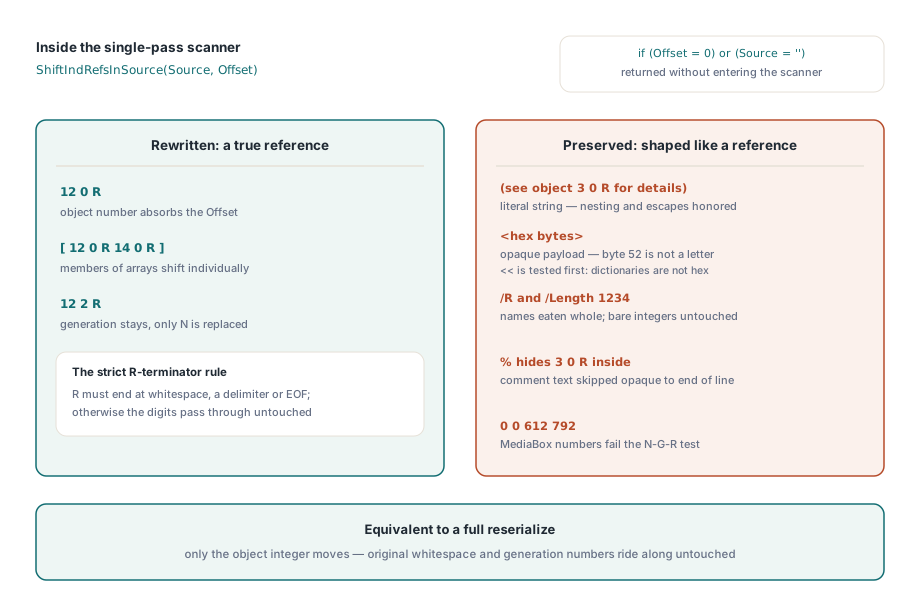
En byte-omskrivning af indirekte referencer er bedragerisk let at få galt, fordi R og rækker af cifre optræder overalt i et PDF-objekt i sammenhænge, der ikke er referencer. ShiftIndRefsInSource er en lille håndskrevet scanner, der gennemgår bytesene én gang og kun omskriver et tal, når det efterfølges, med PDF-whitespace mellem tokens, af endnu et tal og derefter en R-afgrænser. De billige exits kommer først: hvis forskydningen er nul, eller kilden er tom, returneres bytesene urørte uden overhovedet at gå ind i scanneren
Scannerens korrekthed hviler på at genkende de sammenhænge, hvor en referenceformet sekvens skal lades i fred. Det er de grænser, der er lettest at overse, og hver af dem håndteres eksplicit:
- Literal strenge afgrænset af
(og)kopieres ordret, mens dybden af indlejring spores, og backslash-escapen respekteres, så en escapet parentes ikke forstyrrer dybdetællingen. En streng som(see object 3 0 R for details)indeholder et lærebogseksempel på et referencemønster, der i virkeligheden bare er løbende tekst, og den skal overleve byte for byte - Hexadecimale strenge afgrænset af
<og>sendes igennem uden fortolkning. Bytesene52inde i en hex-streng er ASCII-koden forR, og en scanner, der behandlede hex-nyttelast som tekst, kunne fabrikere en fantomreference. Det åbnende<<for en dictionary genkendes først, så en dictionary ikke fejltolkes som en hex-streng - Navneobjekter, der starter med
/, opsluges helt, fra skråstregen og frem til næste whitespace eller afgrænser. Uden dette kunne et navn som/R(en almindelig ressourcenøgle) blive læst somR'et i en reference - Kommentarer, der indledes med
%, løber til linjens slutning og springes over som uigennemsigtig tekst - Tal-så-R-testen er streng. En reference genkendes kun som
NwhitespaceGwhitespaceR, hvorRafsluttes af whitespace, en afgrænser eller inputtets slutning. Hvis generationsnummeret mangler, eller etRefterfølges af et bogstav, udsendes cifrene uændret. Det er det, der beskytter heltallet i/Length 1234og de fire tal i enMediaBoxmod at blive stille og roligt inkrementeret
Kernen i den strenge test læser næsten præcis, som specifikationens sætning beskriver den:
if (P <= N) and (Source[P] = 'R') and
   ((P = N) or PLIsPdfWhite(Source[P + 1]) or PLIsPdfDelimiter(Source[P + 1])) then
  Obj1 := PLStrToIntDef(PLCopy(Source, I, E1 - I), -1);

if Obj1 >= 0 then
begin
  AppendStr(PLIntToStr(Obj1 + Offset));   // forskudt objektnummer
  AppendBytes(E1, P - E1);                 // oprindeligt whitespace + generation
  AppendBytes(P, 1);                       // selve 'R'
end;
Kun objektnummeret omskrives; generationsnummeret og det nøjagtige oprindelige whitespace mellem tokens kopieres igennem, så outputtet er byte-identisk med inputtet, bortset fra det ene heltal, der skulle ændres. Den præcision er hele pointen — det er det, der gør genbrug af kildebytes ækvivalent med en fuld genserialisering, ikke bare tæt på. Adfærden er dækket af et fokuseret sæt enhedstest, der afprøver bare referencer, referencer inde i arrays, ikke-referencetal, literal strenge, hex-strenge og generationsnumre forskellige fra nul med en forskydning anvendt
Hvorfor bogmærker ikke kunne genbruge AppendOutline
At sammenflette flere dokumenters bogmærker til ét dispositionstræ ligner en opgave for den eksisterende AppendOutline-hjælpefunktion, som allerede ved, hvordan man podér ét dokuments øverste-niveau-bogmærker ind på et andets. Det er det forkerte værktøj her, og årsagen er en subtil lagdelingsmismatch. AppendOutline finder det nuværende sidste øverste-niveau-bogmærke ved at lade readeren gennemgå de originale filbytes. Men den hurtige sammenfletning iscenesætter sine redigeringer i en ny-objekter-buffer gennem ChangeObject; readeren ser aldrig de redigeringer. Kæd tre eller flere dokumenter sammen, og hver tilføjelse omdirigerer det første dokuments originale sidste bogmærke til det nyeste dokument, så alle de mellemliggende dokumenters bogmærker falder ud af kæden — kun det kumulative /Count forbliver korrekt, hvilket gør fejlen let at overse, indtil nogen åbner bogmærkepanelet
Den hurtige sti løser det med en to-fase, metadatadrevet injektion, der aldrig gennemgår readeren igen. Et første gennemløb over alle inputs indsamler, pr. dokument, dispositionsrodobjektet og generationsnumre, det første og sidste øverste-niveau-bogmærkenummer, og rodens /Count. Ud fra den opsummering beregner koden de globale objektnumre for hvert link, den skal skabe — hvert dokuments øverste-niveau-/Parent til den fælles rod, det første bogmærkes /Prev til det foregående dokuments sidste, det sidste bogmærkes /Next til det næste dokuments første — ved brug af ren objektnummer-aritmetik. Der er en skriverækkefølgesbegrænsning bag dette: det første dokuments objekter skrives ud, før noget efterfølgende dokument overhovedet åbnes, så alle det første dokuments dispositionsredigeringer (rodens /Count og /Last, samt det gamle sidste bogmærkes /Next) skal kunne udtrykkes som aritmetik, der ikke kræver noget senere dokument i hånden. Hvert efterfølgende dokuments redigeringer anvendes på stedet, efter det er åbnet, men før det skrives, så de kører igennem den samme change-object-sti
Offset-justeringsinvarianten, der binder det hele sammen
Både referenceforskydningen og bogmærkeinjektionen afhænger af én aritmetisk invariant, og det er den mest skrøbelige antagelse i hele designet. En reference injiceret i et efterfølgende dokument skrives som det globale måltalsobjektnummer minus det pågældende dokuments Offset, så når objektet senere forskydes med ShiftIndRef(Offset), lander værdien på det tilsigtede globale nummer. Det første dokument får Offset = 0 og bruger globale numre direkte. For at den subtraktion skal være korrekt, skal den løbende forskydningssekvens, der bruges under injektionen, matche den forskydningssekvens, der bruges, når objekterne til sidst skrives ud
Det gør den, på grund af en egenskab ved, hvordan side- og formularsammenfletningerne fungerer: AddPages, AddFields og AddFieldFonts ændrer kun det første dokuments eksisterende objekter — de tilføjer aldrig nye. Så det første dokuments objektantal er uændret gennem sidesammenfletningsfasen, og hvert efterfølgende dokuments forskydning (summen af alle foregående dokumenters objektantal) forbliver stabil fra injektion til udskrivning. Bryd det — indfør en fase, der opretter et nyt objekt midt i sammenfletningen — og hver side- og bogmærkereference nedstrøms ville være forskudt med antallet af objekter, du tilføjede. Invarianten er stille, men den er bærende
Tre indgangspunkter over én motor
Den hurtige sti er ikke en gaffel af sammenfletningskoden. I samme arbejde blev byte-niveau-motoren udskilt til én enkelt intern rutine, MergeFileListInternal(ListName, OutputFileName, PreserveStructTree, StrictMode), og de offentlige API'er blev til tynde wrappere, der vælger to flag:
MergeFileListFastkalder motoren med bevarelse af strukturtræet slået fra — den slankeste sti, der dropper det tagged-PDF-træ, så bytesporet gælder for flest mulige objekterMergeFileListkalder den med bevarelse slået til, så strukturtræet overlever, og resultatet forbliver en brugbar tagged PDF. Denne almindelige sti arver også sammenfletningen af bogmærker og formularer på tværs af flere dokumenterMergeFileListStrictslår streng tilstand til: det første metadatagennemløb stopper ved det første input, der ikke rapporterer en ren sammenfletning, så kun de dokumenter, der blev indsamlet før den dårlige fil, inkluderes, i stedet for at springe den dårlige fil over og fortsætte
At folde stierne sammen gjorde det også muligt at genopbygge den almindelige sammenfletning fra en parvis O(N²)-løkke — sammenflet fil et og to, sammenflet det resultat med tre, og så videre, mens den voksende akkumulator genparses for hvert skridt — til ét lineært gennemløb, der åbner hvert input én gang. De to mangeårige to-fil- og to-stream-indgangspunkter, MergeFiles og MergeStreams, er urørte og forbliver tilgængelige for kaldere, der oprigtigt ønsker en parvis sammenfletning
Én ærlig bemærkning om strukturtræets adfærd, fordi det bed testsuiten. Den hurtige stis "drop" er ikke totalt: den fjerner det første dokuments katalogreference til /StructTreeRoot, men selve strukturtræ-objektet skrives stadig ud som en forældreløs. Så det hurtige outputs bytes indeholder stadig strengen /StructTreeRoot, og du kan ikke skelne hurtigt fra almindeligt output ved at søge efter den streng — den reelle forskel er, om kataloget stadig når strukturtræet, hvilket er det, der afgør, om filen stadig er en navigerbar tagged PDF
Når du skal vælge hvilken vej
Bytestien er en gennemløbsoptimering til at samle mange dokumenter, hvor du ikke behøver strukturtræet for tagged PDF bevaret — rapportbundling, kontoudtogskørsler, batch-sammenkædning. Målt over gentagne sammenfletninger af mellemstore til store inputmængder trimmede bytegenbruget cirka fire til tretten procent af den forløbne tid, afhængigt af objektmikset, uden nye fejl på små eller fejlbehæftede inputs, fordi ethvert objekt, scanneren ikke kan bevise er sikkert, falder tilbage til den fulde parsning. Har du brug for, at strukturtræet er intakt af hensyn til tilgængelighed, skal du bruge den almindelige tagged-PDF-sammenfletningssti, som bevarer det; og arbejder du med meget store enkeltfiler i stedet for mange inputs, anvender byte-kopieringsteknikkerne beskrevet i sidestykket om sammenfletning og opdeling af store PDF'er med direkte filadgang den samme "kopiér bytes, undgå det fulde objekttræ"-filosofi i filskala
Sammenfletningsrutinerne og deres hurtige og strenge varianter er en del af PDF Library for Delphi Delphi PDF Library, hvis dokumentation indeholder den fulde reference til file-list-API'et og de sammenfletningsindstillinger, der er beskrevet her