Importujete FDF do formuláře a hodnoty polí se vrátí nenápadně špatně: bullet dorazí jako dagger, elipsa jako em dash. PDFium Component vystopoval celou tu rodinu symptomů k jedinému řádku ve své tabulce PDFDocEncoding — blok speciálních znaků v dodatku D.2 normy ISO 32000-1 začíná na $80, ne na $7F
Proč import FDF vrátí sousední znak?
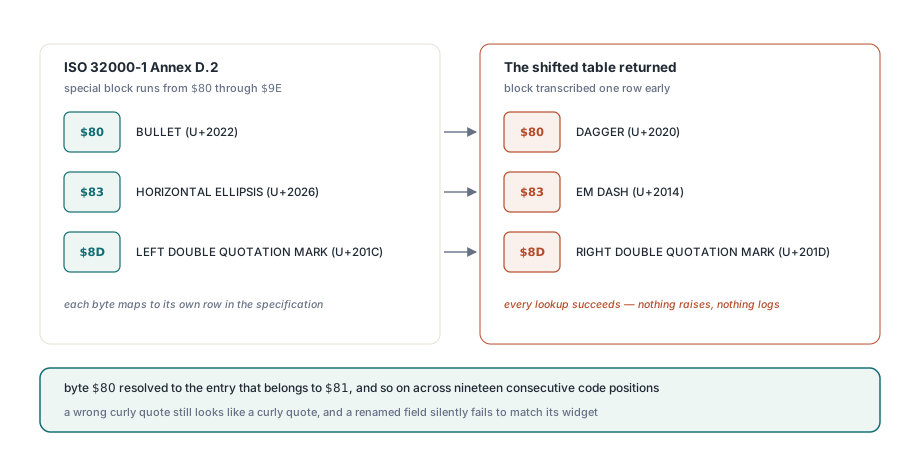
Protože tabulka kódování posunutá o jednu pozici je pořád dokonale věrohodně vypadající tabulka a každý lookup v ní projde. Blok, který dodatek D.2 přiřazuje $80 až $9E, byl přepsán o jeden řádek dřív, takže bajt $80 se vyřešil na záznam, který patří $81, bajt $81 na záznam pro $82 a tak dál přes devatenáct po sobě jdoucích kódových pozic. Nic nevyhodilo chybu, nic se nezalogovalo a žádné pole nebylo nikdy odmítnuto — TPdf.ImportFDF hlásil stejný počet polí jako vždycky
Škoda byla rovnoměrná a tichá. Bajt nesoucí $80, který dodatek D.2 definuje jako BULLET (U+2022), se vrátil jako DAGGER (U+2020). Bajt $83, HORIZONTAL ELLIPSIS (U+2026), se vrátil jako EM DASH (U+2014). Bajt $8D, LEFT DOUBLE QUOTATION MARK (U+201C), se vrátil jako RIGHT DOUBLE QUOTATION MARK (U+201D) — případ, kterého si nikdo nevšimne, protože špatná kudrnatá uvozovka pořád vypadá jako kudrnatá uvozovka ve formulářovém poli. Názvy polí potkal stejný osud jako hodnoty, což je horší: jméno, které už neodpovídá widgetu v dokumentu, se tiše nepoužije
Textové řetězce PDF nesou dvě různá kódování
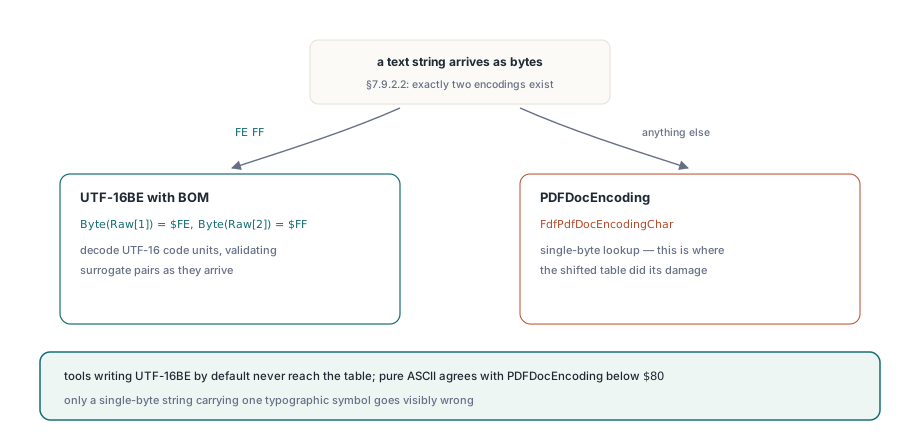
Norma ISO 32000-1 §7.9.2.2 definuje typ text string jako jedno z přesně dvou kódování, vybrané pohledem na první dva bajty, ne podle žádného záznamu ve slovníku. Řetězec, který začíná byte order mark FE FF, je UTF-16BE; cokoli jiného je PDFDocEncoding. Tahle jediná větev rozhoduje, který ze dvou úplně odlišných dekodérů poběží, a PDFium Component ji aplikuje uvnitř FDF parseru dřív, než se dotkne jediného znaku
// FDF textový řetězec: UTF-16, pokud je přítomen BOM, jinak PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... dekóduj UTF-16 kódové jednotky a ověřuj páry náhradníků
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
Tohle je důvod, proč se bug tak dlouho skrýval v běžném testování. Jakýkoli FDF vyrobený nástrojem, který píše defaultně UTF-16BE, se k FdfPdfDocEncodingChar vůbec nedostane, takže posunutá tabulka zůstává spící. Jen jednobajtové řetězce — a právě ty spousta FDF generátorů emituje pro obyčejné latinkové názvy polí, protože jsou kratší — jdou do větve, kde tabulka rozhoduje. Čistě ASCII názvy polí se pak stejně dekódují správně, protože pod $80 si PDFDocEncoding a ASCII odpovídají. Potřebujete jednobajtový řetězec s jediným typografickým symbolem, než se něco viditelně pokazí
Opravená tabulka a dvě kotvy, které ji připínají
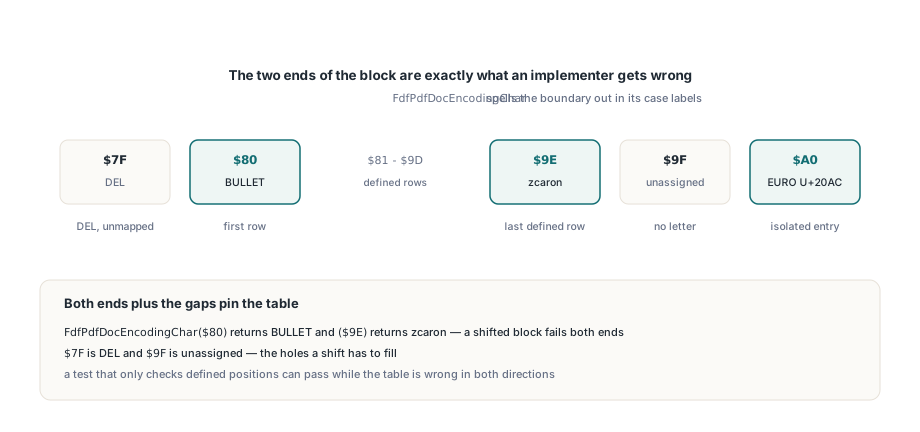
PDFium Component teď hranici vyslovuje přímo v FdfPdfDocEncodingChar, protože oba konce bloku jsou přesně to, co implementátor pokazí. $7F je DEL a nemá žádný PDFDocEncoding význam; blok se otevírá na $80 s BULLET a běží až k $9E se zcaron; $9F je nepřiřazený; a znak eura sedí osamoceně na $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Annex D.2. Blok začíná na $80, ne na $7F: $7F je DEL a
    // nemá v PDFDocEncoding žádný význam a Euro sedí na $A0, které by
    // výchozí větev by jinak vrátila jako pevnou mezeru
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, první řádek bloku
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 through $9D
    $9E: Result := WideChar($017E);   // zcaron, poslední definovaný řádek
    $9F: Result := WideChar($FFFD);   // nepřiřazeno v Annex D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Podívejte se, co posun udělal s těmi dvěma konci, protože tam off-by-one přestává být kosmetický. zcaron seděl ve specifikaci na $9E, ale v posunuté tabulce na $9D, takže bajt dokumentu $9E spadl za poslední přepsaný řádek a propadl se rovnou na identity fallback, který vrátil řídicí znak C1 místo písmene. A $A0, euro, nebylo do tabulky zapsáno vůbec — identity větev ho vracela jako U+00A0 NO-BREAK SPACE, znak, který přežije každou následnou validaci, tiskne se jako nic a nikdy neodpovídá názvu pole, který hledáte
Jak otestujete přepsanou tabulku kódování?
Testujte první řádek, poslední řádek a mezery — ne vzorek ze středu. Tohle je část opravy, kterou stojí za to přenést na každou další tabulku, kterou kopírujete ze specifikace, protože spot check ze středu bloku je přesně ten test, který posun celého bloku přežije. Ověřit, že $8D dává levou dvojitou uvozovku, nedokazuje nic, když $8C taky dává něco věrohodného; ověřit, že $80 dává BULLET a $9E dává zcaron, připne oba konce, a posunutý blok nemůže uspokojit oba najednou
procedure CheckPdfDocEncodingAnchors;
begin
  // Oba konce speciálního bloku Annex D.2: posun celého bloku je rozbije
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Kódové pozice, které specifikace nechává nedefinované, se nesmí dekódovat na písmeno
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // Izolovaný záznam nad blokem, snadno ho úplně vynecháš
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
Nepřiřazené pozice si zaslouží vlastní asserci místo přeskakování jako nezajímavé. Off-by-one musí někam něco dát a skoro vždycky to dá na kódovou pozici, kterou specifikace nechala prázdnou — $7F na začátku, $9F na konci. Test, který kontroluje jen definované pozice, může projít, zatímco tabulka je špatná v obou směrech; test, který připne díry, chytí posun hned napoprvé
Co tohle stojí v round-trip formulářovém workflow
Import FDF, který potichu přepíše jeden znak za symbol, je horší než ten, který selže, protože selhání vyplave po proudu a vypadá jako něco jiného. Názvy polí jsou tady ostrá hrana. TPdf.ImportFDF porovnává příchozí jména s widgety v otevřeném dokumentu a jméno, které se dekódovalo o jeden znak špatně, prostě neodpovídá — pole zůstane prázdné, návratová hodnota pořád počítá pole jako naparsované a report, který z pipeline vyjde, je o jednu hodnotu kratší, aniž by v logu bylo cokoli, co by to vysvětlovalo. Každý, kdo staví export-and-reimport smyčku typu popsaného v exportu a importu XFDF dat formulářů a anotací s PDFium Component, by měl před důvěrou smyčce round-tripnout název pole s typografickým symbolem, ne jen čisté ASCII
Taky stojí za to být poctivý ohledně mezí opravy. Tabulka teď odpovídá dodatku D.2 pro všech 256 bajtových hodnot, takže jednobajtové FDF řetězce se dekódují správně, ale PDFDocEncoding samo pokrývá latinkový repertoár a nic víc — cokoli mimo něj musí dorazit jako UTF-16BE s BOM, což je přesně to, co §7.9.2.2 zamýšlí. A UTF-16 řetězec má na Delphi straně pořád vlastní nástrahy, protože kódový bod nad U+FFFF potřebuje surrogate pár místo jednoho WideChar, problém popsaný v proč emoji a CJK znaky rozbíjejí WideChar v Delphi. Širší bod zobecňuje i za kódovací tabulky: PDF parser může odmítnout něco, co by přijmout měl, což zjistíte hned, nebo něco přijmout a potichu to pokazit, což zjistíte v produkci. Nástrahy name tokenů popsané v bezpečném parsování PDF slovníků sedí v té druhé kategorii, a stejně tak tabulka posunutá o řádek — cesta kódu projde, návratová hodnota vypadá rozumně a jen test napsaný proti specifikaci, ne proti implementaci, řekne něco jiného
ImportFDF, ExportFDF a ImportXFDF na TPdf spolu s FDF a XFDF parsery za nimi jsou součástí standardního PDFium Component pro Delphi a C++Builder