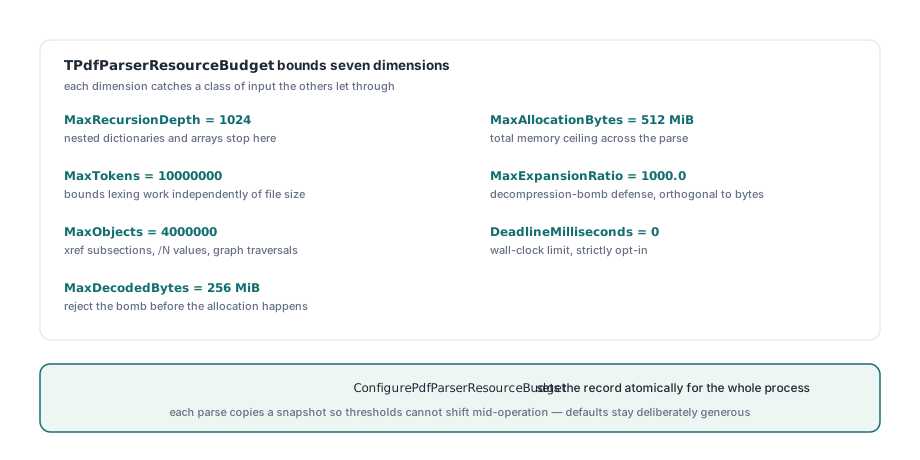
PDFium Component vystavuje TPdfParserResourceBudget, jediný record, který omezuje hloubku rekurze, počet tokenů, počet objektů, dekódované bajty, expanzní poměr, alokace a časový termín podle hodin pro každý PDF parser v knihovně. ConfigurePdfParserResourceBudget ho nastaví atomicky pro celý proces a každý parse si kopíruje snapshot, takže se prahy nemohou uprostřed operace posunout
Šest parserů, šest soukromých stropů
Situace, která tohle vynutila, byla všední a nejspíš povědomá. Sparse procházení xref mělo svůj vlastní strop na objekty. Inspektor streamů měl vlastní limit dekódovaných bajtů. XMP měl jeden, XFDF a FDF další, normalizace obsahu třetí a preflight defaulty čtvrtý. Každé z těch čísel bylo samo o sobě obhajitelné a žádné z nich nebylo zvenčí dosažitelné, takže volající, který chtěl říct „tahle intake cesta zvládá anonymní uploady, nic tady nesmí alokovat víc než 64 MiB ani běžet déle než čtyři sekundy", neměl kam to říct. Druhý problém byl horší, protože byl tichý: kde limit žil v měnitelném globálu, parse, který začal za jedné politiky, mohl skončit za jiné. Jedno vlákno zavolá setter, zatímco druhé je v půlce objektového streamu, a první půlka toho procházení je ohraničená starým stropem, zatímco druhá půlka novým. Nic nespadne, nic se nezaloguje a pak už nemůžete říct, pod jakými limity operace vlastně běžela, což je přesně ta vlastnost, kvůli které jste limity potřebovali
Co TPdfParserResourceBudget vlastně omezuje?
Sedm dimenzí, vybraných tak, že každá chytí třídu vstupů, které ostatní propustí. MaxRecursionDepth má default 1024 a zastaví zanořené slovníky a pole, aby se syntaxe objektů z §7.3 normy ISO 32000-1 nezměnila v přetečení zásobníku. MaxTokens má default 10 000 000 a omezuje lexikální práci nezávisle na velikosti souboru. MaxObjects má default 4 000 000 a pokrývá počty záznamů v cross-reference, hodnoty /N objektových streamů a procházení grafů. MaxDecodedBytes má default 256 MiB a MaxAllocationBytes 512 MiB, takže soubor lze odmítnout před alokací, ne až po ní. MaxExpansionRatio má default 1000.0 a je to dimenze, kterou lidé podceňují: filtry streamů z §7.4 normy ISO 32000-1 jsou obecná komprese, pár kilobajtů Flate dat se může legitimně rozbalit na stovky megabajtů a strop na poměr je standardní obrana proti dekompresní bombě. Je ortogonální vůči absolutnímu limitu bajtů, protože stream o 200 KiB, který chce být 200 MiB, je pod stropem 256 MiB a stejně je absurdní. DeadlineMilliseconds má default 0, tedy žádný termín, takže tahle dimenze je striktně opt-in. Defaulty jako celek jsou záměrně štědré, velikostně uzpůsobené tomu, aby obyčejné obchodní dokumenty nic nespouštěly, ne aby tvořily tvrzený profil; když váš vstup přichází z veřejného upload formuláře, chcete něco bližšího číslům níže, spolu s pravidly popsanými v zpevnění Delphi náhledového panelu PDF
uses
  FPdfPdfCommon;

procedure ApplyUntrustedIntakeBudget;
var
  Budget: TPdfParserResourceBudget;
begin
  Budget := TPdfParserResourceBudget.Default;
  // Defaults kept: MaxRecursionDepth 1024, MaxTokens 10000000,
  // MaxObjects 4000000
  Budget.MaxDecodedBytes      := Int64(32) * 1024 * 1024;  // default 256 MiB
  Budget.MaxAllocationBytes   := Int64(64) * 1024 * 1024;  // default 512 MiB
  Budget.MaxExpansionRatio    := 50.0;                     // default 1000.0
  Budget.DeadlineMilliseconds := 4000;                     // default 0 = off
  ConfigurePdfParserResourceBudget(Budget);
end;
Proč brát snapshot místo čtení globálu?
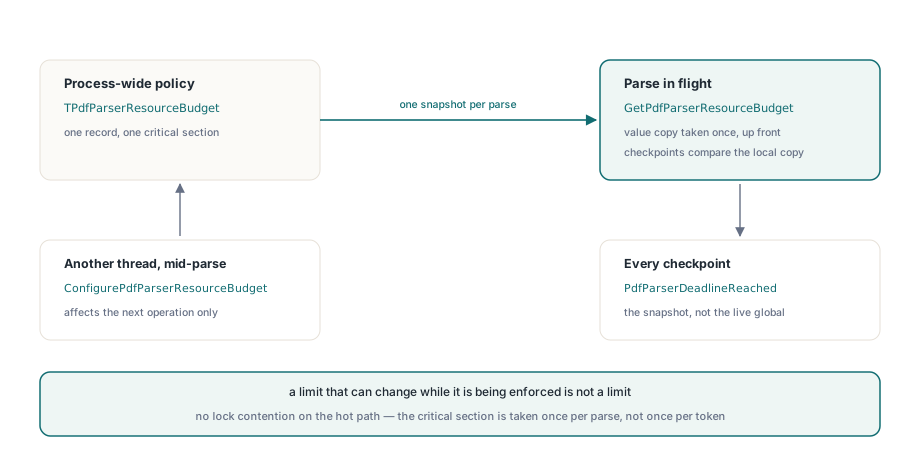
Protože limit, který se může změnit, dokud se vynucuje, není limit. To je jádro celé té funkce a je to jedna linie disciplíny na každém vstupním bodě: přečtěte politiku jednou na začátku operace do lokálního TPdfParserResourceBudget a pak každý checkpoint porovnává proti té lokální kopii. GetPdfParserResourceBudget vezme kritickou sekci a vrátí hodnotovou kopii rekordu a od té chvíle se parse měnitelného globálního stavu už nikdy nedotkne. Výsledkem je, že volání ConfigurePdfParserResourceBudget z jiného vlákna ovlivní příští operaci, nikdy tu probíhající. Souběžné parsy běží pod různými politikami, aniž by se rušily, operace, která selhala na limitu zdrojů, selhala proti jedinému koherentnímu souboru prahů, a na hot path není žádné lock contention, protože zámek se bere jednou za parse, ne jednou za token
type
  TCustomScanState = record
    Budget: TPdfParserResourceBudget;
    StartTick: Cardinal;
    TokenCount: Int64;
    Depth: Integer;
  end;

procedure BeginScan(var S: TCustomScanState);
begin
  S.Budget := GetPdfParserResourceBudget;  // snapshot pořízený jednou, hned na začátku
  S.StartTick := PdfParserStartTick;
  S.TokenCount := 0;
  S.Depth := 0;
end;

function ScanCheckpoint(var S: TCustomScanState): Boolean;
begin
  Result := False;
  if PdfParserDeadlineReached(S.StartTick, S.Budget) then
    Exit;
  Inc(S.TokenCount);
  if S.TokenCount > S.Budget.MaxTokens then
    Exit;
  if S.Depth > S.Budget.MaxRecursionDepth then
    Exit;
  Result := True;
end;
Když si na knihovně píšete vlastní parser, kopírujte tenhle tvar místo volání GetPdfParserResourceBudget uvnitř tokenové smyčky. Volat to per token je správné, ale zbytečné: zaplatíte kritickou sekci v každé iteraci a vrátíte zpět ten mid-operation drift, který měl snapshot zamezit
Proč strop na bajty nezastaví patologický soubor?
Protože velikost a cena spolu v PDF souvisí jen volně. Soubor o 400 KiB s cross-reference streamem z §7.5.8 normy ISO 32000-1, jehož pole /Index a /W popisují věrohodný, ale nepřátelský počet záznamů, řetěz objektových streamů, který se vrací ke stejným offsetům, nebo content stream operátorů, z nichž každý stojí víc, než vypadá, se pohodlně vejde pod každý váš strop na bajty i objekty a stejně zabere worker vlákno na minuty. Počty bajtů omezují paměť; neomezují čas. K tomu jsou PdfParserStartTick a PdfParserDeadlineReached. PdfParserStartTick zachytí hodnotu ticku na začátku operace a PdfParserDeadlineReached porovná uplynulý čas s DeadlineMilliseconds a vrací False, kdykoli je deadline 0. Odčítání běží v bezznaménkové aritmetice, takže přetočení tickového čítače nevyrobí falešný timeout. Parsování cross-reference, dekódování objektových streamů, normalizace content tokenů a čtečky FDF a XFDF to všechno kontrolují v hlavách smyček, takže parse nad rozpočet se zastaví na checkpointu, ne tím, že by ho někdo zvenčí zabil
Dvě poctivá upozornění. Je to čas podle hodin, ne CPU čas, takže stroj, který swapuje, nebo build server pod zátěží může spustit deadline, který by klidný stroj zvládl, což mluví pro nastavení výrazně nad vaším pozorovaným nejhorším případem, ne blízko mediánu. A je vypnutý defaultně, protože deadline, který se spustí na legitimně velkém dokumentu při měsíčním dávkovém zpracování, je horší selhání než to, kterému zabraňuje. Opt-in per intake cestu, ne globálně, a spárujte ho se strukturálními kontrolami z validace cross-reference streamů
Rozpočet je strop, ne náhrada formátových limitů
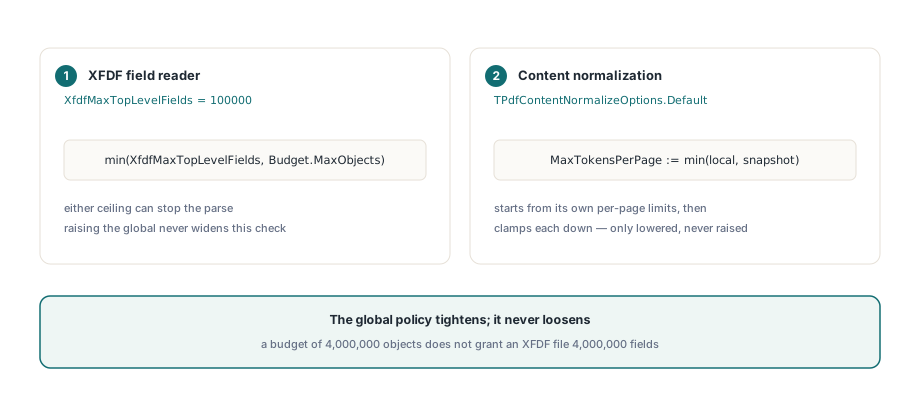
Každý parser si drží vlastní formátové konstanty a aplikuje obojí. XFDF je nejjasnější příklad: čtečka polí vynucuje XfdfMaxTopLevelFields a konstantu MaxFieldNodes 100000 vedle snapshot hodnoty a zastavit parse může kterékoli z nich
const
  XfdfMaxTopLevelFields = 100000;   // format-local, always applies
...
  // Oba stropy jsou aktivní; vyhrává ten nižší
  if (FieldCount >= XfdfMaxTopLevelFields) or
     (FieldCount >= Budget.MaxObjects) then
    Exit(False);
To je záměr a stojí za to si to vnitřně osvojit, než budete hledat knoflík, který neexistuje. Globální rozpočet 4 000 000 objektů nedává XFDF souboru 4 000 000 polí, protože 100000 polí už je dávno mimo cokoli, co produkuje reálný export anotací, a zvednutí globálního stropu by nemělo potichu rozšiřovat formátově specifickou kontrolu soudnosti. Normalizace obsahu funguje stejně z druhé strany: TPdfContentNormalizeOptions.Default startuje z vlastních limitů per stránku a pak každý z nich upne dolů na snapshot, takže MaxTokensPerPage může rozpočet jen snižovat, nikdy zvyšovat. Globální politika utahuje; nikdy nepovoluje
Špatná konfigurace selže ve chvíli, kdy ji konfigurujete
ConfigurePdfParserResourceBudget validuje dřív, než přiřadí. Nepozitivní hodnota v kterékoli ze šesti číselných dimenzí okamžitě vyhodí chybu a MaxDecodedBytes nad High(Integer) se odmítne jako překročení limitů platformy, ne aby se potichu ořízl někde hluboko v dekodéru. Záleží na tom víc, než to zní: rozpočet postavený z konfiguračního souboru s chybějícím klíčem vám dá nuly a nulový strop na objekty přijatý při startu se o tři hodiny později promění v záhadné selhání parse na prvním dokumentu, kdy už nikoho nenapadne vinit konfiguraci. Stejná péče platí pro každý kód, který rozpočet dočasně utáhne, včetně testů. Politika je procesní, takže nechat nainstalovaný 4sekundový deadline po skončení fixture otráví každý další; kolem změny ukládejte a obnovujte
var
  Saved: TPdfParserResourceBudget;
begin
  Saved := GetPdfParserResourceBudget;
  try
    ApplyUntrustedIntakeBudget;
    ProcessInboundDocument(FileName);
  finally
    ConfigurePdfParserResourceBudget(Saved);
  end;
end;
ResetPdfParserResourceBudget je hrubší verze, která rovnou obnoví TPdfParserResourceBudget.Default. Použijte ho v teardownu testů, kde chcete známý stav, a v produkčním kódu použijte save-and-restore, protože tam je stavem, ke kterému se musíte vrátit, to, co hostitelská aplikace nastavila při startu
Kde rozpočet přestává pomáhat
Je to jediná procesní politika, a to je jeho hlavní omezení. Nemůžete dát jednomu worker vláknu přísný profil a druhému benevolentní, protože za jedinou kritickou sekcí je jeden record; pokud skutečně potřebujete limity per tenanta, fungující tvar je serializovat každou třídu politik do vlastního procesu, nebo ohraničit práci save-and-restore a smířit se s tím, že ohraničení je bezpečné jen tehdy, když nic jiného nesparsuje souběžně. Omezuje taky parsování, ne renderování: paměť rasterizace, růst font cache a dekódování obrazů sedí mimo těchhle sedm dimenzí a potřebují vlastní kontroly. A rozpočet vám řekne, že operace byla příliš drahá, nikdy proč. Strop, který se spustil, je symptom a malformované pole /Index nebo utržený řetěz filtrů za ním se pořád musí diagnostikovat ručně, a proto stojí za to pochopit dekódovací cestu popsanou v dekódování objektových streamů a prediktorů, než začnete hýbat čísly. Berte rozpočet jako věc, která brání špatnému dokumentu stáhnout s sebou proces, a držte logování dost dobré na to, abyste zjistili, co ten dokument dělal
Celý povrch parser API, budget record a build ze zdrojáků pro Delphi, C++Builder a Lazarus jsou na stránce produktu: PDFium Component