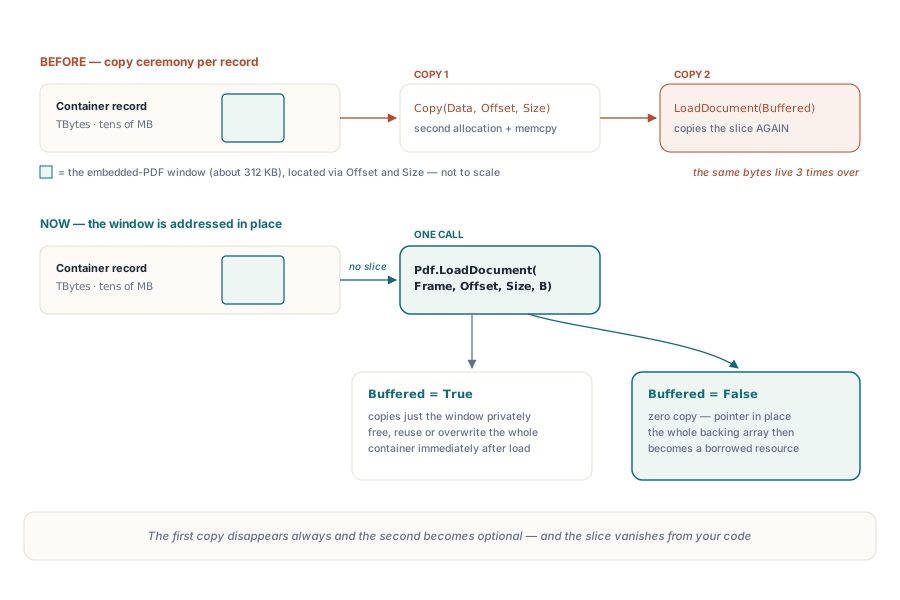
PDFium Component umí otevřít PDF, který žije uvnitř většího bufferu, přímo z rozsahu bajtů. Přetížení LoadDocument(const Data: TBytes; Index, Count: Integer; Buffered: Boolean) adresuje okno na místě, takže není potřeba žádné předběžné Copy. Výměnou po vás žádá, abyste pochopili jedno pravidlo: je-li Buffered rovno False, podkladové pole je vypůjčené, ne zkopírované
Jde o jiný mechanismus než přístup řízený callbacky popsaný v streamování velkých PDF na vyžádání s PDFium VCL, který předá PDFium čtečku FPDF_FILEACCESS a nechá jej podle potřeby stahovat bloky z disku. Ten je pro dokumenty příliš velké na to, aby se vešly do RAM. Tento je pro dokumenty už v RAM, sedící na známém offsetu uvnitř něčeho jiného. Oba se navzájem doplňují a poslední sekce vysvětluje, která situace patří ke které
40MB kopie, o kterou nikdo nežádal
Scénář se objevuje všude, kudy PDF cestují uvnitř jiných formátů. Poštovní úložiště drží těla zpráv a přílohy v jednom záznamu. Archivní kontejner spojuje manifest, pár obrázků a PDF. Vlastní drátový protokol rámuje dokument za hlavičkou s délkovým prefixem. V každém případě skončíte s jedním velkým TBytes a s vědomím, že PDF začíná na bajtu 1 182 336 a běží 312 kilobajtů
Než existovalo přetížení pro rozsah bajtů, idiomatickou odpovědí bylo Copy(Data, Index, Count), což alokuje druhé pole a memcpy okno do něj. Tento výřez pak předáte do LoadDocument s Buffered = True, které jej znovu zkopíruje do soukromého bufferu komponenty. Dvě kopie stejných bajtů, jedna z nich čistá ceremonie, a při skenování velké schránky se opakuje pro každou zprávu. Přetížení pro rozsah bajtů odstraňuje první kopii bezpodmínečně a druhou volitelně
Co přetížení pro rozsah bajtů skutečně dělá
Přetížení je záměrně tenké: validuje, spočítá jeden ukazatel a deleguje na formu LoadDocument s ukazatelem, přes kterou už protéká celá rodina. Index je od nuly, Count je délka v bajtech a Buffered má výchozí hodnotu True přesně tak jako u ostatních přetížení. Jednoargumentové LoadDocument(const Data: TBytes; Buffered: Boolean) je nyní samo jen voláním tohoto s Index = 0 a Count = Length(Data), takže existuje jedna validační cesta místo dvou
Volání vypadá jako kód, který jste už psali, minus výřez
var
  Frame: TBytes;          // celý záznam kontejneru, desítky megabajtů
  Offset, Size: Integer;
begin
  Frame := LoadContainerRecord('mailbox.dat');
  LocateEmbeddedPdf(Frame, Offset, Size);   // váš analyzátor kontejneru

  // Žádné Copy(Frame, Offset, Size) zde - okno se adresuje na místě
  Pdf.LoadDocument(Frame, Offset, Size, True);
  try
    RenderPreview(Pdf);
  finally
    Pdf.UnloadDocument;
  end;
end;
Proč přetéká kontrola hranic u Index plus Count?
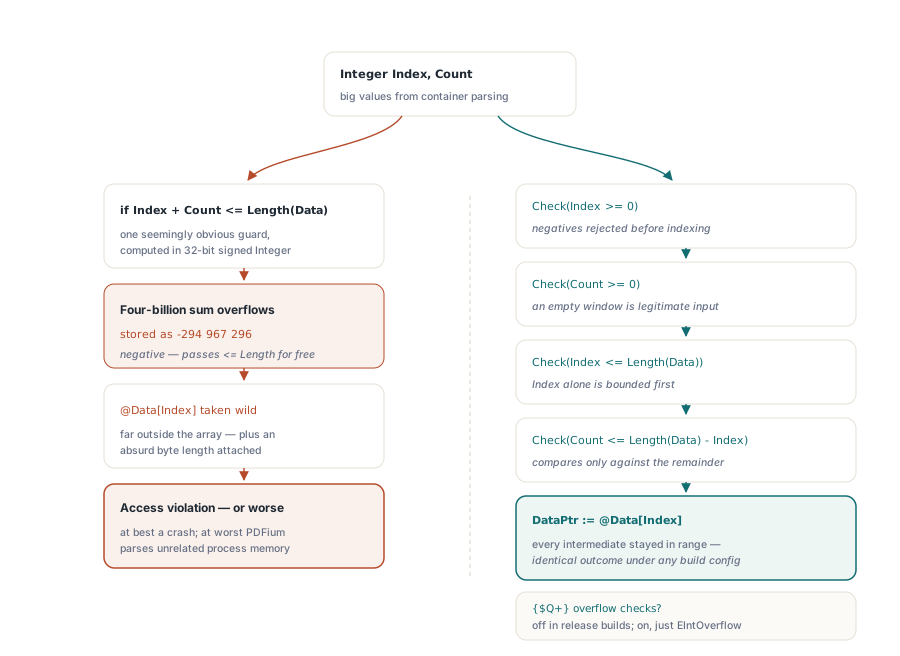
Protože Index i Count jsou oba Integer, a součet dvou velkých kladných hodnot Integer nemusí být velké kladné Integer. To je technické jádro tohoto přetížení a je to jediné místo, kde přirozeně vypadající kontrola je díra v bezpečnosti paměti. Zjevná formulace je chybná
// ŠPATNĚ: Index + Count se vyhodnotí v Integer a může se přetočit do záporu
if Index + Count <= Length(Data) then
  DataPtr := @Data[Index];

// SPRÁVNĚ: nejprve odmítněte záporné hodnoty, pak ohraničte každý člen zvlášť,
// s jedinou aritmetikou prováděnou jako odčítání, které se nemůže přetočit
Check(Index >= 0,  'PDF byte range index cannot be negative');
Check(Count >= 0,  'PDF byte range count cannot be negative');
Check(Index <= Length(Data), 'PDF byte range index exceeds data length');
Check(Count <= Length(Data) - Index, 'PDF byte range exceeds data length');
Projděte si chybný případ. Vezměte Index = 2000000000 a Count = 2000000000. Jejich skutečný součet je čtyři miliardy, ale ve 32bitové znaménkové aritmetice výsledek přeteče přesně na mínus 294 967 296. Tato hodnota je pohodlně menší než Length(Data), takže chybná kontrola projde, @Data[Index] se vezme daleko mimo pole, a PDFium dostane divoký ukazatel plus délku dvou gigabajtů. Následuje přístupová výjimka v dobrý den a tiché parsování nesouvisející paměti procesu ve špatný
Správné pořadí to opravuje tím, že nikdy nesčítá. Záporné hodnoty se odmítnou ještě před jakoukoli indexací, takže @Data[Index] nikdy nemůže být vzato pod hranicí pole. Poté je Index ohraničen samostatně proti Length(Data), což zaručuje, že Length(Data) - Index je nezáporné Integer. Teprve poté se Count porovná s tímto zbytkem. Každá mezihodnota zůstává uvnitř reprezentovatelného rozsahu, takže žádná konfigurace buildu nemůže výsledek změnit. Nenechte se ani svést k tomu, spolehnout se na kontrolu přetečení {$Q+} jako na záchrannou síť: release buildy ji běžně mají vypnutou, a i když je zapnutá, proměnili jste bezpečnostní chybu paměti na EIntOverflow unikající ze středu validační rutiny. PDFium Component zachází s aritmetikou nedůvěryhodné délky stejně jako se zbytkem hranice, disciplína popsaná šířeji v posílení ABI PDFium VCL a bezpečnosti paměti v Delphi
Proč musí okno nulové délky předat nil?
Protože @Data[Index] není legální výraz pro každý Index, který validace přijme. Index = Length(Data) s Count = 0 je naprosto dobře formované prázdné okno na konci bufferu, a prázdné TBytes dá Index = 0 na poli, které nemá vůbec žádný prvek nula. Vzetí adresy v obou případech indexuje za konec, nebo dereferencuje nil dynamické pole. Takže přetížení se větví: Count = 0 vydá nil ukazatel, jakýkoli jiný počet vydá @Data[Index]. Nil pak proudí do přetížení s ukazatelem, jehož vlastní hlídka přijímá nil ukazatel, je-li velikost nula, a načtení skončí obyčejnou chybou „Cannot load PDF document" místo přístupové výjimky. Volající, který spočítal nulabajtové okno z poškozeného kontejneru, dostane čistou, zachytitelnou EPdfError jako u jakéhokoli jiného chybného vstupu
Vypůjčené nebo zkopírované: co rozhoduje Buffered
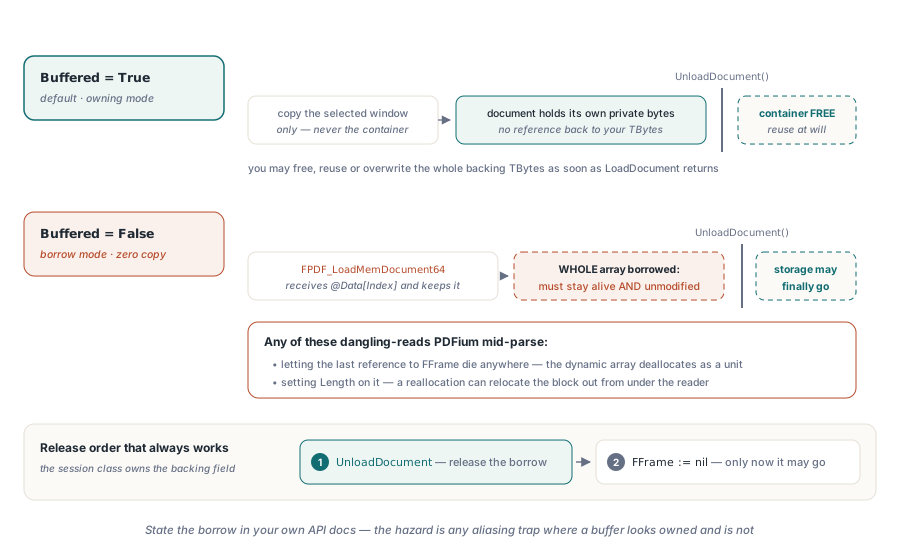
Buffered volí smlouvu o vlastnictví a je to jediný parametr zde s důsledky přesahujícími samotné volání. S Buffered = True PDFium Component zkopíruje vybrané okno, a jen toto okno, do svého interního bufferu ještě před načtením. 40MB kontejner se nekopíruje; kopíruje se 312KB PDF. Jakmile se LoadDocument vrátí, můžete kontejner ihned uvolnit, znovu použít nebo přepsat, protože komponenta na něj už neodkazuje. Toto je výchozí volba a správná volba pro téměř veškerý kód
Buffered = False předá @Data[Index] přímo do FPDF_LoadMemDocument64, a PDFium si tento ukazatel drží po celou dobu života dokumentu místo kopírování bajtů. To dělá načtení bez alokace, a dělá z celého podkladového TBytes vypůjčený zdroj. Musí zůstat naživu a nezměněný, dokud neproběhne UnloadDocument nebo Active nepřejde na False. Ne okno, celé pole: dynamické pole má počítání referencí jako jednotka, a pustit poslední referenci kdekoli ve vašem kódu uvolní paměť, kterou PDFium stále čte. Nastavení Length na něm je stejně fatální, protože realokace může blok přesunout. Uveďte to ve vlastní dokumentaci API všude, kde takové načtení vystavujete, ve stejném duchu jako jakoukoli jinou hranici výpůjčka-versus-vlastnictví v kódu Pascalu; způsob selhání je identický s hazardy aliasingu popsanými v úniku FillChar a výsledkového řetězce v Delphi, kde buffer vypadá vlastněný a není
type
  TFrameSession = class
  private
    FFrame: TBytes;   // vlastní úložiště, dokud je FPdf načten
    FPdf: TPdf;
  public
    procedure OpenEmbedded(Offset, Size: Integer);
    destructor Destroy; override;
  end;

procedure TFrameSession.OpenEmbedded(Offset, Size: Integer);
begin
  // Buffered = False: FFrame musí přežít načtený dokument
  FPdf.LoadDocument(FFrame, Offset, Size, False);
end;

destructor TFrameSession.Destroy;
begin
  FPdf.UnloadDocument;   // nejprve uvolněte výpůjčku
  FFrame := nil;         // teprve nyní může úložiště zmizet
  inherited;
end;
Kdy je okno rozsahu bajtů nesprávný nástroj
Buďte upřímní ohledně hranice. Přetížení pro rozsah bajtů předpokládá, že kontejner je už plně v paměti, a Count je Integer, takže jedno okno nemůže přesáhnout dva gigabajty. Je-li kontejner 6GB archiv na disku, nebo přichází přes soket, který nemůžete přetočit, toto přetížení vám nepomůže a přečtení celé věci do TBytes jen kvůli adresování okna uvnitř maří celý smysl. Přesně tam patří cesta FPDF_FILEACCESS, a článek o streamování na vyžádání ukazuje, jak vystavit pohled na soubor posunutý o offset jako vlastní zdroj dokumentu. Stejně tak, potřebují-li vložené bajty transformaci předtím, než je uvidí PDFium — dekompresi, dešifrování, krok rozbalení —, pak je skutečná kopie nevyhnutelná a Buffered = True na transformovaném poli je poctivá odpověď. Okno rozsahu bajtů se vyplatí přesně v jednom tvaru: souvislé, nezměněné bajty PDF, už rezidentní, na známém offsetu
Pokud toto vyhodnocujete pro prohlížeč, náhledový panel nebo dávkovou přijímací pipeline, přetížení pro rozsah bajtů a streamovací loader jsou dvě z několika strategií načítání, které PDFium Component nabízí vedle načítání ze souboru, streamu a syrového ukazatele. Kompletní povrch API, licencování a podpora verzí Delphi a C++Builder jsou zdokumentovány na stránce produktu PDFium Component