PDFium Component ve verzi 3.117.0 spojí tabulku, která se láme přes hranici stránek, když buď oba fragmenty sahají na okraje stránek, nebo mezi prvním fragmentem a druhým nesedí žádný tělový text, s běžovými hlavičkami a patičkami ignorovanými. ExtractDocumentTables aplikuje tenhle test podle obsahu jako alternativu ke staršímu testu okrajů stránek, odmítá fragment na další stránce, jehož první řádek je jediná buňka titulku přes celou šířku, a drží jediný řádek, který se vylil na následující stránku, jako část svého řetězce pokračování
Článek o detekci a extrakci tabulek představil pokračování jako čtyři přísné brány a bralo „sahá na okraj stránky" jako jednu z nich. Ten popis byl přesný pro vydání, které popisoval, a byl zároveň špatný pro většinu tabulek, které lidé komponentě reálně dávají. Tenhle článek je náprava: které dokumenty test okrajů nezvládne, co ho vystřídalo a dva postranní případy, které oprava přitáhla s sebou
Proč test okrajů stránek selhává na exportech z Wordu?
Test okrajů stránek selhává, protože textový procesor přestává rozmisťovat řádky na spodním okraji, ne na okraji papíru. S defaultním ContinuationMargin 36 bodů vyžadovalo původní pravidlo, aby spodní hrana dřívějšího fragmentu ležela do 36 bodů od spodku stránky a horní hrana pozdějšího do 36 bodů od vršku stránky. Dokument exportovaný z Wordu s defaultními okraji po palci dává poslední řádek aspoň 72 bodů nad spodek stránky, dál, pokud je přítomná patička, takže podmínka nikdy neplatila. Každá dlouhá tabulka v takovém dokumentu se vracela jako nezávislé fragmenty s ContinuationGroup nula a volající byl zpátky u ručního sešívání. Test pořád dává smysl pro to, kolem čeho byl stavěný: reporty generované layout enginy, které plní stránku do pevného obsahového rámečku a začínají další stránku zarovnaně u vršku. Není to špatné pravidlo, je to neúplné, proto ho verze 3.117.0 nechala a přidala druhou cestu místo náhrady
Co test podle obsahu kontroluje místo toho?
Test podle obsahu kontroluje, zda něco jiného než tabulka obsazuje prostor mezi oběma fragmenty, přes word boxy každé stránky místo geometrie stránky. Když ExtractDocumentTables projde dokument, zaznamenává na stránku nejnižší spodní hranu jakéhokoli slova, jehož vršek leží nad pásmem patičky, a nejvyšší vrchní hranu jakéhokoli slova, jehož spodek leží pod pásmem hlavičky. Obě pásma jsou ContinuationMargin bodů hluboká, takže tatáž volba teď dělá dvojí službu jako vůle na okraji stránky i jako výška zón běžové hlavičky a patičky. Pár fragmentů projde, když spodní hrana dřívějšího je na nebo pod nejnižším tělovým textem jeho stránky a horní hrana pozdějšího na nebo nad nejvyšším tělovým textem další stránky, každé v rámci AlignmentTolerance. Nahlas: tabulka byla poslední věcí na stránce N a první věcí na stránce N+1 a číslo stránky nebo název dokumentu v pásmu okraje se nepočítá. To vyloučení není libovolné. ISO 32000-1 §14.8.2.2 klasifikuje běžové hlavičky a patičky jako pagination artefakty, obsah, který existuje kvůli zlomu stránky, ne navzdory němu, a tatáž idea, která dovolí tagovanému readeru je přeskočit, dovolí tabulce pokračovat za nimi. Článek o marked contentu rozebírá, jak tagované soubory ty artefakty deklarují explicitně; tady se klasifikace odvozuje z pozice, protože většina exportovaných tabulek nenese žádné tagy
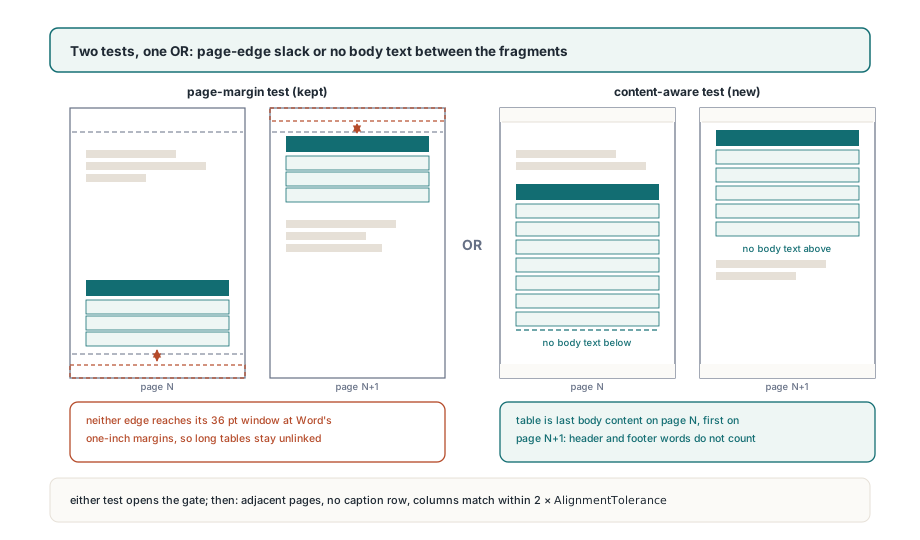
Ta dva testy se kombinují přes OR. Report z layout enginu, jehož tabulky běží k okraji papíru, projde prvním; export z Wordu, jehož tabulky končí na okraji, projde druhým; dokument, který dělá obojí, projde dvakrát. Teprve poté, co jeden z nich uspěje, běží zbývající brány a běží v pevném pořadí: čísla stránek musí být sousední, pozdější fragment nesmí otvírat řádkem titulku a sloupcové hranice musí odpovídat do dvojnásobku AlignmentTolerance, což je 6 bodů na defaultech. Enumerace je TPdfTableContinuation s hodnotami ptcNone, ptcStart, ptcMiddle a ptcEnd. Fragment označený ptcEnd, který pak odkazuje dál na další stránku, se povyšuje na ptcMiddle, takže třístránková tabulka čte start, middle, end v pořadí stránek. Skupinová čísla startují na 1 a 0 znamená nespojené a ToJson emituje tutéž informaci jako členy continuation a continuationGroup, což je forma, kterou upřednostnit, pokud sešívání dělá downstream služba
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectContinuations := True;     // default; ukázáno pro jasnost
    Options.ContinuationMargin := 54;        // dvouřádková patička, ~50 pt hluboká

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d (%d rows)',
          [Tables[I].PageNumber, Tables[I].RowCount]));
      end;
  finally
    Pdf.Free;
  end;
end;
Jak řádek titulku brání dvěma tabulkám, aby se nespojily?
Fragment na další stránce, jehož první řádek je jedna buňka přesahující všechny sloupce, se bere jako nová tabulka, nikdy jako pokračování předchozí. Toto pravidlo existuje, protože test podle obsahu sám o sobě spojuje příliš ochotně. Případ, který to vystavil, byl formulář ve stylu transcriptu: tabulka končí poblíž spodku stránky 1, druhá tabulka s identickými šířkami sloupců začíná poblíž vršku stránky 2, mezi nimi nesedí nic kromě patičky a sloupce sedí na tečku. Pod testem okrajů se ta dva nikdy nepotkala, protože žádný nesáhl na okraj; pod testem obsahu se spojily okamžitě a formulář se sekcemi se stal jednou nesourodou mřížkou. Co je odděluje, je vidět ve struktuře buněk. Druhá tabulka otvírá titulkem sekce jako „RECIPIENT INFORMATION" rozloženým jako jediná sloučená buňka přes celou šířku a skutečné pokračování to nikdy nedělá, protože titulek patří tabulce, která už začala na předchozí stránce. TableStartsWithCaptionRow kóduje přesně to: fragment má aspoň dva sloupce a obsahuje buňku s RowIndex = 0, ColumnIndex = 0 a ColumnSpan = ColumnCount. Kontrola běží jen na pozdějším fragmentu, takže tabulka, jejíž vlastní řádek titulku sedí na její první stránce, zůstává nedotčená; titulek je na stránce N a inspektuje se jen fragment stránky N+1
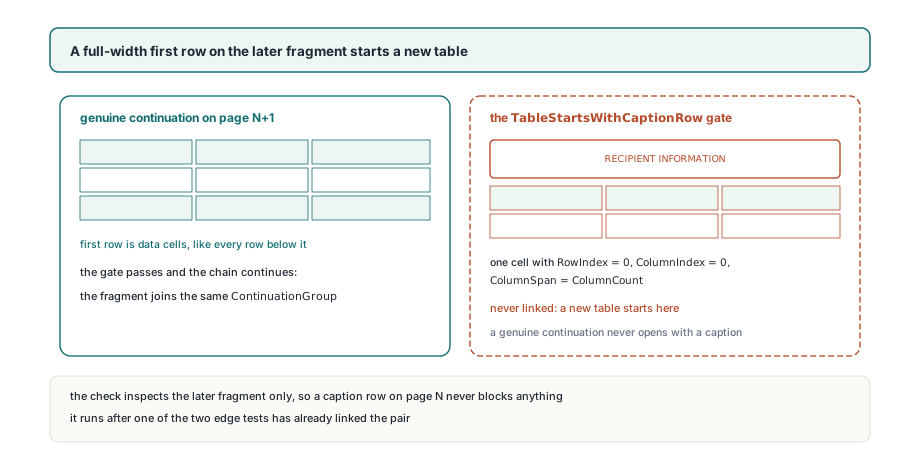
Srovnání sloupců, které následuje, TablesHaveMatchingColumns, je přísnější než „stejný počet sloupců". Znovu postaví pozice hranic každého fragmentu z obdélníků buněk, interpoluje hranice, které schovávají sloučené buňky, a odmítne pár, když se jakákoli hranice vychýlí víc než o toleranci. Dvě čtyřsloupcové tabulky s různými proporcemi proto zůstávají oddělené, i když všechno ostatní sedí
Co se stane s jediným řádkem, který se vyleje na další stránku?
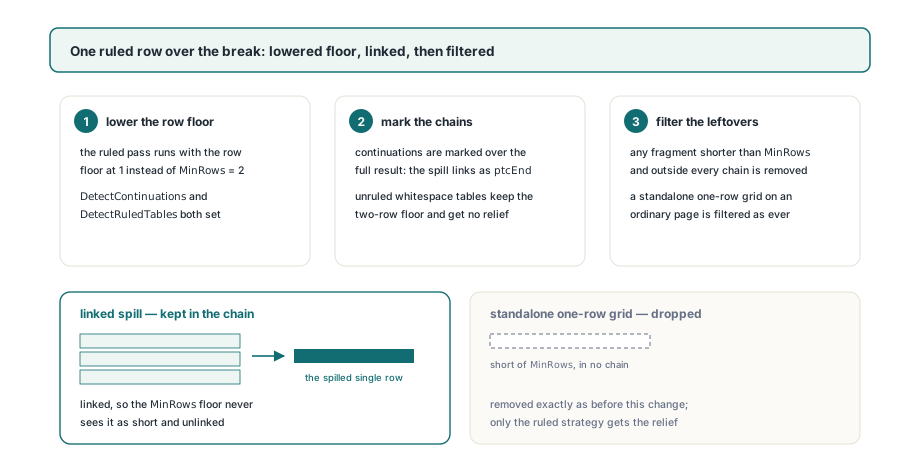
Čarovaná mřížka, která přenese jeden řádek na následující stránku, se teď detekuje a spojuje, pokud skončí v řetězci pokračování; sama o sobě se zahodí. Defaultní MinRows 2 existuje, aby pár toulavých čar nebyl hlášený jako tabulka, ale poslední řádek zatlačený přes zlom je reálný řádek, který tvrdá podlaha 2 potichu zahodila a zbytek tabulky vypadal kompletní, když nebyl. Sken na úrovni dokumentu to obstará ve třech krocích. Když jsou nastavené DetectContinuations i DetectRuledTables, průchod na stránku pouští ruled detektor s podlahou řádků dočasně sníženou na 1, proto ExtractTables teď akceptuje MinRows 1 pro ruled mřížky, zatímco detekce whitespace drží interní podlahu 2. Pokračování se označují nad celým výsledkem. Pak se odstraní každá tabulka kratší než MinRows volajícího a nepatřící do žádného řetězce. Jednořádkový fragment přežije jen proto, že byl spojený a jednořádková mřížka uprostřed jinak obyčejné stránky se filtruje přesně jako dřív
// Znovu postav každý řetězec jako jedno CSV a zahod opakované
// řádky hlaviček na fragmentech pokračování
procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R: Integer;
  Lines: TStringList;
  Csv: TStringList;
begin
  Csv := TStringList.Create;
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      if Tables[I].Continuation in [ptcNone, ptcStart] then
        Csv.Clear;
      Lines.Text := string(Tables[I].ToCsv);
      if (Tables[I].Continuation in [ptcMiddle, ptcEnd]) and
         (Lines.Count > 1) and (Tables[I].RowCount > 1) then
        Lines.Delete(0);            // hlavička opakovaná textovým procesorem
      for R := 0 to Lines.Count - 1 do
        Csv.Add(Lines[R]);
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Csv.SaveToFile(Format('%s\page%d-group%d.csv',
          [Folder, Tables[I].PageNumber, Tables[I].ContinuationGroup]));
    end;
  finally
    Lines.Free;
    Csv.Free;
  end;
end;
Dva detaily v téhle rutině jsou záměrné. Jednořádkový výlev se nikdy nestříhá, protože ho drží hlídka na RowCount a textový procesor, který opakuje řádek hlavičky na každé stránce, produkuje fragment, jehož první řádka je zase hlavička, takže zahodit řádku nula na middle a end fragmentech je správně pro tenhle případ a špatně pro generátor, který hlavičky neopakuje. Zkontrolujte jeden dokument, než pustíte rutinu na složku
Kde pravidla pořád končí
Test podle obsahu je jen tak dobrý, jak dobrá je textová vrstva, kterou čte. Na skenované stránce bez jakéhokoli textu se zaznamenané extrémy tělového textu vrací k hranicím stránky, podmínka „nic mezi" platí prázdno a zbývají jen brány řádku titulku a sloupců; ruled mřížka na takové stránce se pořád najde jako prázdná kostra, takže řetězec se může spojit správně, ale okolní text se doopravdy neověřil. Přidejte nejdřív textovou vrstvu, pokud na tom záleží. Patičky renderované jako obrázky místo textu jsou pro logiku pásem neviditelné a neškodné ze stejného důvodu
Pásma jsou jedno číslo. Patička hlubší než ContinuationMargin nechává své spodní řádky uvnitř tělové zóny, což dřívějšímu fragmentu vypadá jako následovaný textem a blokuje spojení; zvedněte volbu na reálnou hloubku pásma, jako to dělá první příklad. Zvednete-li ji moc daleko, krátký závěrečný odstavec poblíž spodku stránky uklouzne do pásma a ignoruje se, což spojí tabulku s čímkoli, co následuje. Pravidlo titulku má zrcadlově obrácené selhání: generátor, který píše sloučený banner „pokračování" jako první řádek každého fragmentu pokračování, bude mít ty fragmenty odmítnuté jako nové tabulky a jediná dnešní náprava je sešít sám přes ContinuationGroup, aniž byste cokoli uvolnili, protože pravidlo nemá přepínač
Tabulky detekované whitespace nedostávají žádnou z jednořádkové úlevy. Strategie whitespace potřebuje dva zarovnané řádky, aby tabulku vůbec viděla, takže nečarovaná tabulka, která vyleje jeden řádek, se pořád hlásí zkrácená o ten řádek. Když na to narazíte, word boxy za strukturovanými textovými bloky a reading orderem vám dají surové pozice, jak to zachránit. Na vzorkové sadě, která táhla tuhle práci, třináct exportů z textových procesorů a prohlížečů, všech pět dokumentů se skutečnými vícestránkovými tabulkami se spojilo do jednotlivých řetězců a transcript formulář, který se dřív slil, zůstal oddělený, což je laťka, podle níž se vydání měřilo, ne slib o každém rozložení
Označování pokračování, pravidlo titulku i jednořádkový průchod všechny bydlí v cestě na úrovni dokumentu sdílené buildy Delphi, C++Builder a Lazarus; plné API extrakce tabulek je popsáno na stránce PDFium Component for Delphi