Dejte za odkaz naskenovaný report o 80 MB, otevřete jej v prohlížeči a sledujte, co se stane: prohlížeč sedí na prázdné ploše, dokud nedorazí velká část těch bajtů, a pak vykreslí první stránku naráz. Skočte na stránku 40 a u špatně postaveného souboru se celé stahování možná rozjede znovu. Frustrující na tom je, že čtenář chtěl celou dobu jen tu první stránku. Linearizace je strukturální odpověď na tento problém. Přeuspořádá PDF tak, aby prohlížeč mohl úvodní stránku vykreslit z malé předpony souboru a zbytek si vyžádal až podle potřeby, a proto Adobe tuto funkci prodává pod názvem „Fast Web View“
Nic z toho není jiný souborový formát. Linearizované PDF je obyčejné PDF, které vyhovující čtečka otevře bez zvláštního zacházení. Celý trik je jen v tom, jak jsou seřazené bajty, a ve dvou dodatečných strukturách, jež soubor nese. ISO 32000-1 celé uspořádání popisuje v příloze F, a jakmile to rozvržení uvidíte, chování přestane vypadat jako kouzlo a začne vypadat jako záměrná výměna pořadí v souboru za latenci prvního vykreslení
Co linearizace vlastně přeuspořádá
Běžné PDF může své objekty rozházet skoro v libovolném pořadí. Funguje to díky křížové odkazovací tabulce na konci souboru: čtečka skočí na konec, přečte ukazatel startxref, načte xref a odtud dokáže podle offsetu najít každý objekt. Ten návrh je vynikající pro místní soubory, kde skok na konec nic nestojí, a špatný pro soubor tekoucí po síti, kde je konec přesně tou částí, jež dorazí poslední. K vykreslení první stránky potřebuje běžná čtečka objekt stránky, jeho obsahový proud, fonty, na které odkazuje, a všechny obrázky, které kreslí, a v neseřazeném souboru mohou sedět kdekoli, i v posledním megabajtu
Linearizace pořadí spraví. Objekty potřebné k zobrazení první stránky se posbírají do souvislého bloku blízko začátku, hned za malou hlavičkovou sekcí, takže dorazí v proudu bajtů brzy. Všechno ostatní, zbývající stránky a zdroje, které sdílejí, následuje v předvídatelném sledu. Na konci pořád žije druhá, úplná křížová odkazovací tabulka pro čtečky, jež optimalizaci ignorují, ale linearizovaný soubor navíc umisťuje dopředu i křížové odkazy pro první stránku a parametry, které proudová čtečka potřebuje. Čtečka už nemusí sáhnout na konec, aby mohla cokoli nakreslit
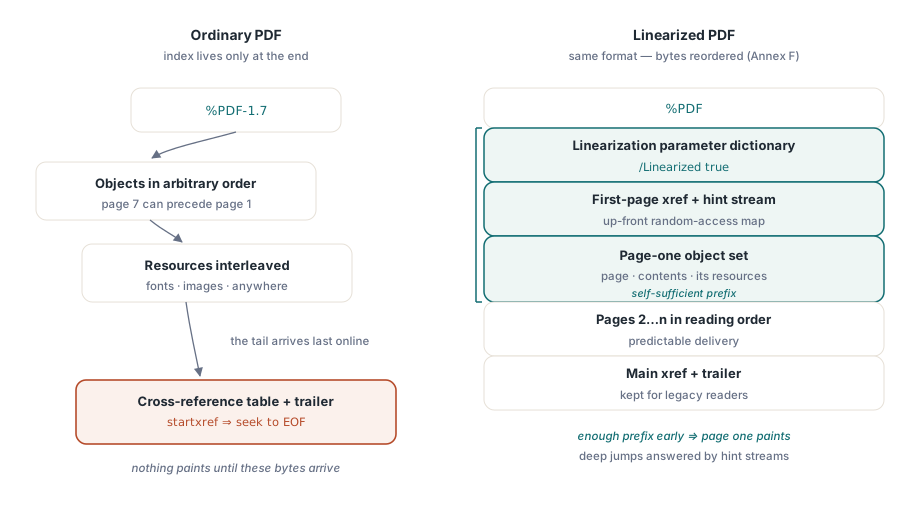
Sada objektů první stránky a slovník linearizačních parametrů
Úplně prvním objektem v linearizovaném souboru, hned za hlavičkou %PDF, je slovník linearizačních parametrů. Právě ten proudová čtečka hledá, aby rozhodla, zda je optimalizace přítomná a jak ji použít. Slovník zaznamenává délku celého souboru, bajtový offset, kde začíná hlavní sekce křížových odkazů, číslo objektu první stránky a umístění i délku hint streamu, jenž následuje. S těmito čísly čtečka už z úvodních kilobajtů ví, kolik musí stáhnout, aby ukázala první stránku, a kde hledat rejstřík, který jí dovolí skočit jinam
Příloha F je přísná v tom, co tady „první stránka“ znamená. Sekce první stránky musí obsahovat samotný objekt stránky, jeho obsahové proudy a zdroje, na které tyto proudy odkazují, aby byla stránka po stažení té předpony soběstačná. Se sdílenými zdroji, s fontem použitým na každé stránce nebo s logem opakujícím se v záhlaví, se zachází zvlášť: objeví se dost brzy na to, aby posloužily první stránce, ale jsou označené jako sdílené, aby si je čtečka nestahovala znovu, až bude vykreslovat stránku 30. Právě rozdíl mezi objekty soukromými pro stránku a objekty sdílenými většina podomácku vyrobených „optimalizátorů“ splete, a splést jej znamená vyrobit soubor, jenž o sobě tvrdí, že je linearizovaný, a přesto se zadrhává
Hint streamy: rejstřík, díky kterému jsou skoky po stránkách levné
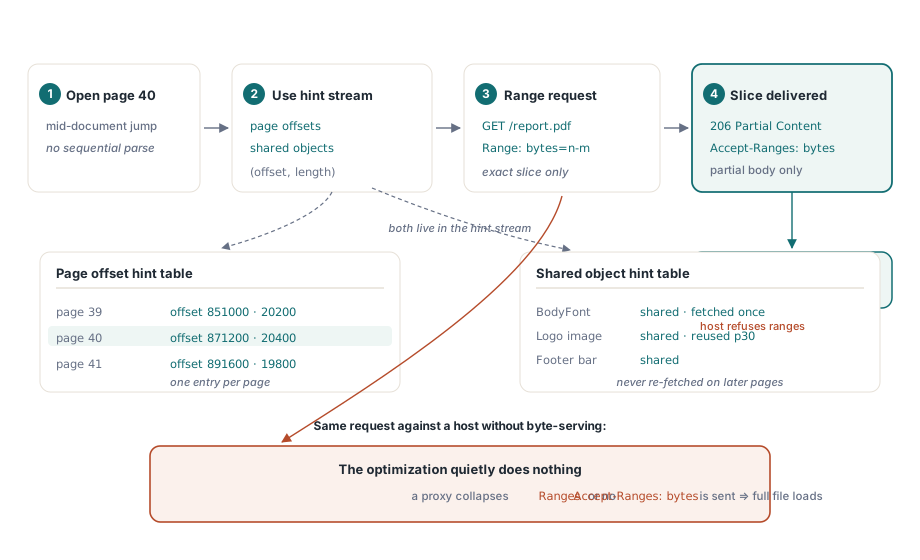
Rychlé zobrazení první stránky je jen půlka hodnoty. Druhá půlka je skok na libovolnou stránku bez stahování všeho mezi tím, a to poskytují hint streamy. Linearizovaný soubor nese tabulku offsetů stránek a tabulku sdílených objektů, uložené jako proud, na který odkazuje slovník parametrů. Tabulka offsetů stránek zaznamenává u každé stránky, kde v souboru její objekty začínají a jak daleko sahají. Tabulka sdílených objektů dělá totéž pro zdroje používané napříč více stránkami
S těmito tabulkami čtečka, která chce stránku 40, soubor neprochází sekvenčně. Nahlédne do hint tabulky, aby zjistila, jaký rozsah bajtů stránka 40 zabírá, vyžádá si od serveru přesně ten rozsah a jakmile ty bajty dorazí, stránku vykreslí, přičemž si týmž mechanismem dotáhne sdílené zdroje, které ještě nemá. Hint stream je vlastně mapa náhodného přístupu položená přes dokument a je důvodem, proč dobře linearizovaný soubor o 500 stránkách působí na pomalé lince svižně, kdežto neoptimalizovaný soubor téže velikosti ne
Proč musí spolupracovat i server
Linearizace předpokládá, že přenos umí doručit libovolné výseky souboru, a tento předpoklad stojí za ověření dřív, než za špatné výsledky obviníte formát. Mechanismem je bajtové doručování přes HTTP: čtečka posílá rozsahové požadavky a server na ně odpovídá odpověďmi 206 Partial Content. Pokud server neinzeruje Accept-Ranges: bytes nebo pokud proxy či CDN před ním rozsahové požadavky sloučí do celého přenosu, čtečka nemá jak stáhnout stránku 40 samostatně a spadne zpět ke stažení celého souboru. Struktura uvnitř PDF je pak naprosto správná a úplně k ničemu
Tohle je selhání, které se nejčastěji chybně diagnostikuje jako „linearizace nefunguje“. Soubor je v pořádku; cesta doručení není. Než dokument přestavíte, ověřte podmíněným požadavkem, že hostitel na URL, kam čtečka sahá, skutečně vrací částečný obsah. Řada statických hostingů to dělá ve výchozím nastavení a řada špatně nastavených aplikačních serverů a vrstev s cache ne
Inkrementální aktualizace linearizaci tiše rozbíjejí
Tady je omezení, které překvapí ty, kdo linearizované soubory generují správně a pak se diví, proč se optimalizace vypaří. Linearizace stojí na jediném pečlivě seřazeném rozvržení s rejstříkem vpředu. Inkrementální aktualizace to porušuje ze své podstaty. Když nástroj přidá podpis, vyplní formulářové pole nebo připojí anotaci inkrementálním uložením, soubor nepřepisuje. Na konec připojí změněné objekty, novou sekci křížových odkazů a nový trailer a původní bajty nechá být. Právě to připojení je smyslem inkrementálních aktualizací: je rychlé a zachovává předchozí revizi pro audit nebo ověření podpisu
Vedlejším efektem je, že soubor teď má nejnovější data křížových odkazů na konci, až za pečlivě umístěným blokem první stránky, a slovník linearizačních parametrů vpředu popisuje rozvržení, jež souboru už neodpovídá. Vyhovující čtečka nesoulad rozpozná a zachází s dokumentem jako s normálním, nelinearizovaným PDF. Fast Web View je pryč, přestože původní linearizovaná struktura pořád leží v první polovině souboru. Připojíte-li několik aktualizací, každá naskládá na konec další revizi a mezera mezi zastaralým předním rejstříkem a skutečným stavem se rozšiřuje
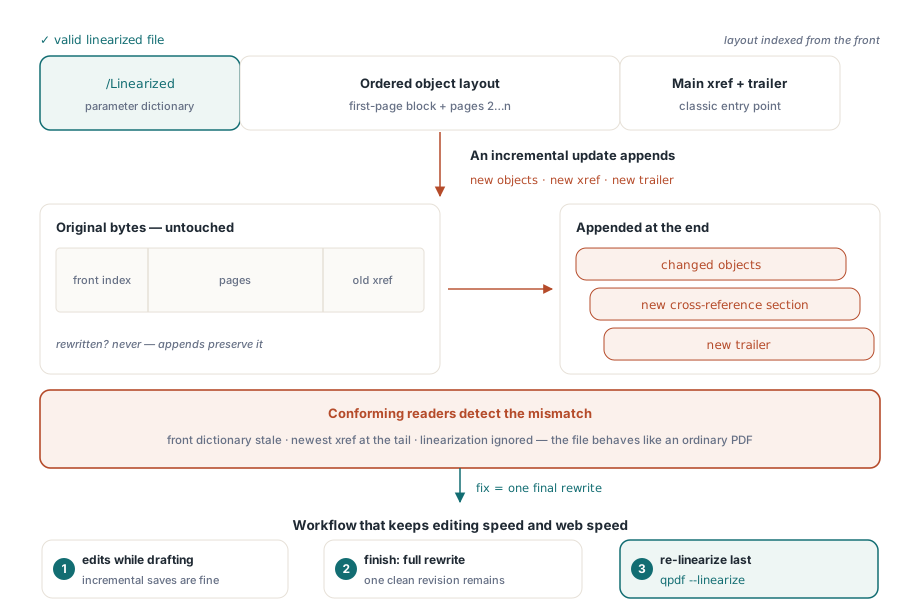
Pokud váš workflow potřebuje úpravy i Fast Web View, pravidlo plyne přímo ze struktury: upravujte inkrementálně, dokud je dokument v pohybu, a pak na konci jednou znovu linearizujte. Rozvržení obnoví plný přepis. V pojmech HotPDF to znamená, že rozpracovaná úprava jde přes BeginIncrementalUpdate a SaveIncrementalUpdate, jež připojí rozdíl, kdežto závěrečný krok načte celý dokument a serializuje jej načisto pomocí LoadFromFile a následného SaveLoadedDocument, což zahodí nashromážděné staré revize a vydá jedno čisté rozvržení. Stejná výměna se objevuje u objektových proudů: zapnutí UseObjectStreams spolu s UseXRefStream zkomprimuje křížové odkazy a objekty sbalí těsně k sobě, což pomůže velikosti souboru, ale jako každá strukturální volba se musí uplatnit při onom závěrečném přepisu, ne přišroubovat k připojené revizi
// Úpravy za letu: připojí rozdíl, předchozí revize zůstanou nedotčené.
// Soubor tím zůstává NElinearizovaný.
Pdf.BeginIncrementalUpdate('report.pdf');
Pdf.AddPage;
Pdf.CurrentPage.TextOut(72, 760, 0, 'Addendum');
Pdf.SaveIncrementalUpdate('report.pdf');

// Závěrečný krok: plná reserializace vytvoří jedno čisté rozvržení
// a zahodí naskládané revize. Na výstup pak znovu pusťte linearizátor.
Pdf.LoadFromFile('report.pdf');
Pdf.SaveLoadedDocument('report-final.pdf');
HotPDF nenabízí rutinu „linearizuj“ na jedno volání, takže praktický postup je vyrobit čistý, plně přepsaný soubor a pustit přes něj vyhrazený optimalizátor. Přeuspořádání zvládají přímo nástroje z příkazové řádky. qpdf přepíše soubor do linearizované podoby jediným přepínačem:
qpdf --linearize report-final.pdf report-web.pdfJak poznáte, že je soubor linearizovaný
Nevěřte názvu souboru ani nástroji, který tvrdí, že jej vyrobil; ověřte bajty. Nejpřímější kontrolou je začátek souboru: otevřete jej a hledejte slovník linearizačních parametrů jako první objekt za hlavičkou, nesoucí klíč /Linearized. Zkratkou na straně čtečky je dialog Vlastnosti dokumentu v Acrobatu, jenž hlásí „Fast Web View: Ano“ jen tehdy, když je struktura opravdu přítomná a aktuální
Pro skriptované kontroly hlásí qpdf jak přítomnost, tak celistvost struktury, na čemž záleží, protože soubor může nést linearizační slovník, který už jeho rozvržení neodpovídá — přesně ten stav, jaký po sobě zanechá inkrementální aktualizace:
# Hlásí "File is linearized" a ověřuje tabulky nápověd podle rozvržení
qpdf --check report-web.pdf

# Podrobně vypíše parametry linearizace a data nápověd
qpdf --show-linearization report-web.pdf
Krok validace je ten, který se vyplatí. Průchod, jenž jen potvrdí, že slovník existuje, s radostí požehná souboru, jehož rejstřík ukazuje na špatné offsety; kontrola, která hint tabulky srovná se skutečnými pozicemi objektů, je to, co vám řekne, že optimalizace obstojí i pod rozsahovými požadavky skutečné čtečky
Linearizaci se pořád vyplatí použít na jakýkoli velký dokument servírovaný po webu, zvlášť pro mobilní čtečky na nevyrovnaném připojení, a stojí pár procent velikosti souboru za rejstřík vytažený dopředu. Dvě věci je třeba držet v hlavě: správná musí být jak struktura uvnitř PDF, tak bajtové doručování vně, a jakákoli pozdější úprava optimalizaci ruší, dokud soubor nepřepíšete. Berte novou linearizaci jako poslední krok linky, až se usadí každá další změna. Chování křížových odkazů, objektových proudů a inkrementálních aktualizací popsané zde je součástí strukturálního modelu, který implementuje HotPDF Delphi Component pro Delphi a C++Builder; širší pozadí rozvržení souboru popisuje jak je PDF strukturováno a workflow s inkrementálními aktualizacemi a velkými soubory v kódu ukazuje zpracování velkých PDF z Delphi