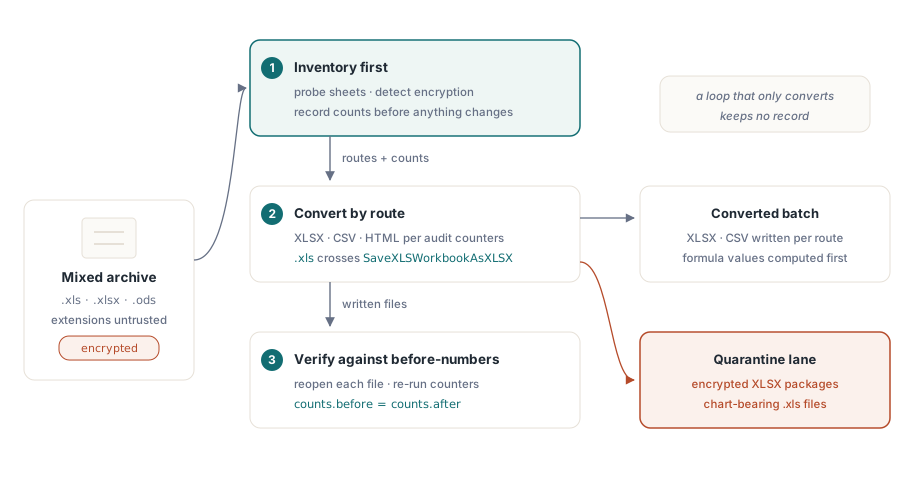
Dávková normalizace tabulek jsou tři problémy v jednom kabátě. Máte archiv smíšených formátů: .xls z éry BIFF, moderní .xlsx, směska .ods z nějakého experimentu s LibreOffice a hrstka souborů, které nikdo neotevře, protože heslo odešlo s bývalým zaměstnancem. Cílem je převést vše na XLSX a CSV. Verze té práce, kterou napíše většina lidí, je smyčka, která otevře každý soubor a uloží jej pod novou příponou, a funguje to přesně do chvíle, kdy se někdo zeptá, které soubory přišly o grafy, ztratily makra nebo se vůbec neotevřely. Smyčka nemá odpověď, protože samotný převod nevede žádnou evidenci. Workbench ano: nejprve inventarizuje, poté převede a nakonec ověří, a tyto tři fáze musí sdílet informace, aby byl celý proces důvěryhodný
Sestavení takového workbenche v Delphi nebo C++Builderu znamená propojit čtyři schopnosti HotXLS, z nichž žádná nepotřebuje Excel nainstalovaný kdekoli v pipelines. K dispozici jsou dva nativní enginy, fasáda BIFF8 pro .xls a fasáda OOXML pro .xlsx a .ods. K dispozici jsou levné probe volání, která čtou metadata bez parsingu celého souboru. K dispozici jsou počítadla auditu pro každý list, která vám řeknou, co sešit skutečně obsahuje. A k dispozici je matice převodů s dokumentovaným profilem věrnosti pro každou cestu. Práce spočívá v tom vědět, kde má každý z nich ostrou hranu, protože každý ji má, a ty hrany jsou přesně to, co promění čistý noční batch v pondělní ranní incident
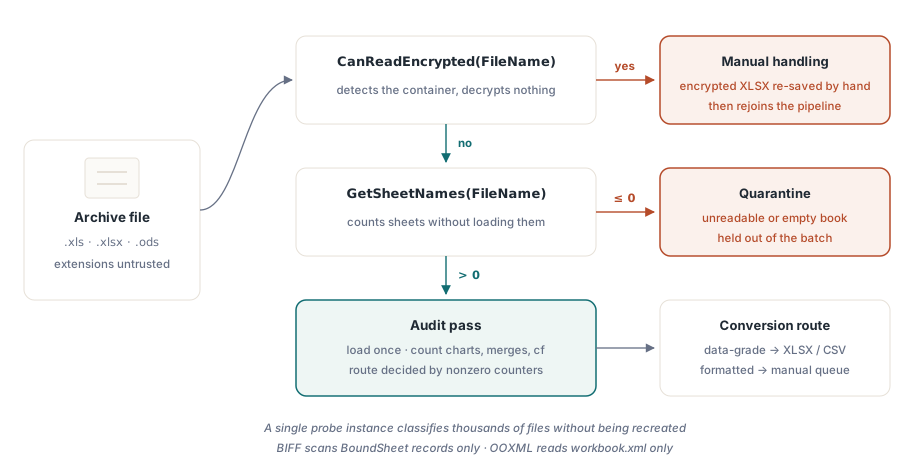
Otestujte před načtením: názvy listů a detekce šifrování
Otevření 200 MB sešitu jen proto, abyste zjistili, že je šifrovaný, plýtvá minutami na soubor, a násobeno napříč velkým archivem plýtvá dny. Obě fasády zpřístupňují GetSheetNames, které čte metadata listů bez načtení sešitu. Implementace BIFF skenuje pouze záznamy BoundSheet na začátku proudu; implementace OOXML čte pouze workbook.xml uvnitř zipu. Vedle toho CanReadEncrypted detekuje šifrovací kontejner bez pokusu o dešifrování:
var
  Probe: TXLSXWorkbook;
  Names: TStringList;
begin
  Names := TStringList.Create;
  Probe := TXLSXWorkbook.Create;
  try
    if Probe.CanReadEncrypted(FileName) then
    begin
      Writeln(FileName + ': encrypted container - route to manual handling');
      Exit;
    end;
    if Probe.GetSheetNames(FileName, Names) <= 0 then
      Writeln(FileName + ': unreadable - quarantine')
    else
      Writeln(Format('%s: %d sheet(s), first "%s"',
        [FileName, Names.Count, Names[0]]));
  finally
    Probe.Free;
    Names.Free;
  end;
end;
Dvě provozní detaily činí tuto smyčku levnou. GetSheetNames neresetuje ani nenaplní instanci sešitu, takže jediný probe objekt může klasifikovat tisíce souborů bez znovuvytváření. A verze stejného volání z XLS fasády také rozumí balíčkům .xlsx, což z ní činí pohodlnou jedinou sondu, když nelze důvěřovat příponám souborů — což jen zřídka lze v archivu tak starém. Triage před načtením si zaslouží vlastní pojednání; mechanika lehké inspekce je v našem článku o výpisu listů a lehké inspekci sešitu
Počítání toho, co sešit skutečně obsahuje
Jakmile soubor projde triage, průchod auditem rozhodne o jeho převodní cestě. Fasáda XLSX zpřístupňuje počítadlo pro každou rodinu funkcí, která se dotýká rozhodnutí o věrnosti: sloučené buňky, grafy, obrázky, podmíněné formáty, ověření dat, tabulky, hypertextové odkazy a komentáře, plus příznaky na úrovni sešitu pro makra, ochranu a zdrojový formát. Převodní cesta souboru závisí téměř výhradně na tom, které z nich se vrátí nenulové
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  I: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.Open(FileName) <> 1 then Exit;
    for I := 0 to Book.Sheets.Count - 1 do
    begin
      Sheet := Book.Sheets[I];
      Writeln(Format('%s: cells=%d merges=%d charts=%d cf=%d dv=%d protected=%s',
        [Sheet.Name, Sheet.Cells.Count, Sheet.MergedCells.Count,
         Sheet.Charts.Count, Sheet.ConditionalFormats.Count,
         Sheet.DataValidations.Count, BoolToStr(Sheet.IsProtected, True)]));
    end;
    if Book.HasVbaProject then
      Writeln('  contains VBA project - macro policy applies');
    if Book.ExternalLinks.Count > 0 then
      Writeln(Format('  %d external link(s)', [Book.ExternalLinks.Count]));
  finally
    Book.Free;
  end;
end;
Čtěte Cells.Count s jednou výhradou v mysli. Úložiště buněk je řídké, takže číslo počítá instanciované buňky, nikoli obdélníkovou oblast použitého rozsahu. List s jednou hodnotou v A1 a další v ZZ9999 hlásí dvě buňky, ne onen milion lichý, které leží mezi nimi. Ekvivalentní sken na straně BIFF používá hranice UsedRange společně s ForEachCell, a nese v sobě off-by-one, který skoro každého poprvé nachytá: UsedRange.FirstRow a jeho sourozenci jsou 0-based, zatímco Cells.Item[Row, Col] je 1-based. Průchod, který zapomene přičíst jedničku ke každé hranici, audituje špatný obdélník a nikdy to neřekne
Dvě páky snižují náklady průchodu určeného pouze k auditu přes velké legacy soubory. Nastavení _DisableGraphics na true před otevřením .xls přeskočí parse OfficeArt kreslicí vrstvy úplně, což šetří reálný čas u sešitů hutných tvary. Je to výhradně optimalizace jen pro čtení: uložení z instance otevřené tímto způsobem by zahodilo kresby, které nikdy neparsela, takže příznak patří pouze na cesty, které nikdy nezapíší soubor zpět. Když audit potřebuje obsah buněk spíše než počty, callback ForEachCell projde naplněné buňky přímo a vyhne se per-access Variant režii, kterou indexované vlastnosti buněk platí při každém čtení a která se rychle sčítá napříč miliony buněk
Normalizujte nekonzistentní návratové kódy brzy
I/O volání HotXLS hlásí chyby přes celočíselné výsledky spíše než přes výjimky, a konvence nejsou napříč API jednotné. Většina open a save volání vrací 1 při úspěchu a -1 při selhání. GetSheetNames vrací počet listů nebo -1 se vyčištěným seznamem. XLSX SaveAsHTML opět vzor porušuje a vrací 0 pro úspěch, -1 pro index listu mimo rozsah. Workbench, který testuje = 1 všude, tiše špatně klasifikuje volání, která signalizují úspěch jiným způsobem, a ten, který testuje <> -1, spolkne ta, která selžou s jiným kódem
Pravidlo, které přežije kontakt s celým API, je užší, než vypadá: považujte <= 0 za selhání pro volání vracející počty, ověřte dokumentovanou hodnotu úspěchu pro každou save rutinu, kterou skutečně používáte, a uložte oboje za jednu malou funkci pro kontrolu výsledku, aby konvence žila přesně na jednom místě. Dávkové pipelines selhávají mnohem častěji pomalým nahromaděním neověřených návratových kódů než exotickou chybou parseru, a cena za to, že to uděláte špatně, přichází o čtyřicet tisíc souborů později, kdy si nikdo nepamatuje, které převody skutečně proběhly
Matice převodů a kde každá cesta ztrácí data
Dvě fasády si mezi sebe rozdělují převodní práci. TXLSXWorkbook otevírá XLSX, ODS a CSV a ukládá XLSX, ODS, CSV, HTML, RTF a AES-šifrované XLSX. TXLSWorkbook otevírá a ukládá BIFF a exportuje HTML, RTF a CSV. Užitečné je, že každá cesta přichází s dokumentovaným profilem věrnosti, nikoli s vágním slibem správnosti, takže můžete předem rozhodnout, které cesty jsou bezpečné pro které soubory
Export CSV zapisuje UTF-8 s BOM, konce řádků CRLF a RFC 4180 quotování. Co nedělá, je vyhodnocovat vzorce: buňka obsahující =SUM(...) se exportuje jako doslovný text vzorce, takže list vzorců se promění v list řetězců, pokud nejprve nevypočítáte hodnoty. Export HTML vytváří jednu tabulku, přičemž colspan a rowspan zastupují sloučené buňky a základní styly jsou inlinované. Export RTF má ostřejší limit: nedokáže roztáhnout sloučené buňky napříč sloupci, takže pokračovací buňky sloučení vyjdou prázdné. Import ODS je záměrně lehký, podle vlastní dokumentace knihovny. Skalární hodnoty a cached výsledky vzorců projdou; styly, živé ODF výrazy vzorců a kresby nikoli. To záleží okamžik, kdy archiv obsahuje skutečné soubory OpenDocument řízené OASIS ODF 1.3, kde cokoli blízkého vizuálně věrnému převodu potřebuje více, než byl tento importní cesta postavena unést, a průchod auditem je to, co vám řekne, že tyto soubory existují, než je batch tiše zploští
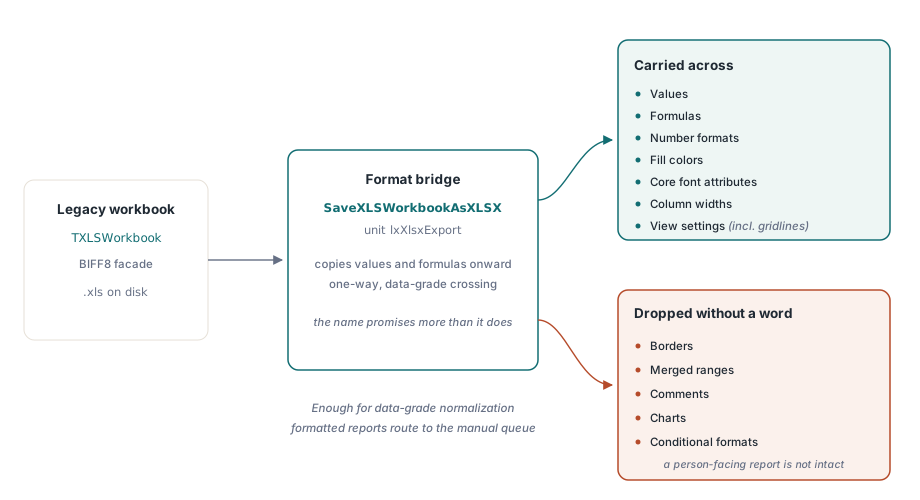
SaveXLSWorkbookAsXLSX je datový most, nikoli most rozložení
Fasáda BIFF nedokáže zapisovat OOXML přímo, takže přechod z .xls na .xlsx probíhá přes funkci SaveXLSWorkbookAsXLSX v unitu lxXlsxExport. Věrnost toho mostu stojí za to říct na rovinu, protože název naznačuje více, než dělá. Kopíruje hodnoty, vzorce, číselné formáty, barvy výplně, základní atributy písma, šířky sloupců a nastavení zobrazení jako mřížku. Nekopíruje ohraničení, sloučené rozsahy, komentáře, grafy ani podmíněné formáty. Pro normalizaci datové třídy, kde alavirchlové systémy budou výsledek parsit a nikdo se nedívá na formátování, je to přesně dost a není ztraceno nic, co by někdo potřeboval. Pro formátovanou zprávu pro vedení určenou ke čtení člověkem to nestačí, a to je přesně místo, kde si počítadla auditu zaslouží své místo: soubor, který audit označil jako nosič grafů a podmíněných formátů, by měl směřovat do ruční fronty, nikoli přes most, který obě zahodí bez slova
var
  Legacy: IXLSWorkbook;        // reference rozhraní: nevolat Free
  Modern: TXLSXWorkbook;
begin
  if SameText(ExtractFileExt(FileName), '.xls') then
  begin
    Legacy := TXLSWorkbook.Create;
    if Legacy.Open(FileName) <= 0 then Exit;
    if SaveXLSWorkbookAsXLSX(Legacy,
         ChangeFileExt(FileName, '.xlsx')) <= 0 then
      Writeln('bridge failed: ' + FileName);
  end
  else
  begin
    Modern := TXLSXWorkbook.Create;
    try
      Modern.StreamingWrite := True;     // streamujte XML listu do zipu
      if Modern.Open(FileName) = 1 then
        Modern.SaveAsCSV(ChangeFileExt(FileName, '.csv'), 0, ',');
    finally
      Modern.Free;
    end;
  end;
end;
Smyčka výše také ukazuje páku propustnosti na straně OOXML. Nastavení StreamingWrite na true streamuje XML listů přímo do výstupního balíčku spíše než staging jako jeden obrovský řetězec v paměti, což je rozdíl mezi pohodlným během a pádem z nedostatku paměti, jakmile soubory dosáhnou stovek tisíc řádků. Dimenzování a chování paměti pro tento režim má vlastní pojednání v našem článku o streamovaných zápisech pro dávkové úlohy serveru. Ještě jedna vlastnost záleží pro batch, který chce využít každé jádro: žádná fasáda není thread-safe, ale ani jedna nesdílí globální stav, takže podporovaný vzor pro paralelní převod je jedna instance sešitu na worker vlákno, bez zamykání mezi nimi
Soubory s heslem a co s nimi dělat
Zamčené soubory archivu se čistě dělí podle formátu a toto rozdělení rozhoduje, kam jdou. Legacy šifrování .xls, ať už RC4, RC4 přes CryptoAPI nebo staré XOR obfuskace, je čitelné: předejte heslo Open a soubor se převede jako každý jiný. Šifrované balíčky .xlsx jsou jiný příběh. HotXLS je detekuje pomocí CanReadEncrypted, ale nedokáže je dešifrovat, takže jediný poctivý krok je směrovat je do fronty, kde člověk každý otevře a znovu uloží v Excelu, než znovu vstoupí do pipelines. Ta asymetrie se vyplatí navrhnout předem, protože šifrované XLSX soubory jsou ty, u kterých je nejpravděpodobnější, že jde o záznamy, na kterých někomu skutečně záleží
Uzavření smyčky ověřením
Třetí fáze je ta, která se přeskočuje, a její přeskočení je to, co promění hromadný převod v riziko. Žádná save cesta v HotXLS nevyhodnocuje vzorce. Excel přepočítá při otevření souboru, takže převod XLSX-na-XLSX zůstane správný, ale cíl CSV obdrží text vzorce doslovně, pokud pipelines nejprve nespustí Calculate na buňkách a nezapíše výsledky zpět. Vědět to předem je rozdíl mezi CSV plným čísel a CSV plným =SUM(...) řetězců, které nikdo nezpozoruje, dokud se na ně alavirchlový import nezkúsní
Samo ověření je dost levné na to, aby nebyla omluva ho vynechat. Znovu otevřete každý převedený soubor se stejnou knihovnou, znovu spusťte počítadla auditu a porovnejte je s čísly před převodem, která průchod inventarizací již zaznamenal. Počet listů, který klesl, počet grafů, který šel na nulu tam, kde zdroj měl tři, počet buněk, který se zřítil z útesu: každé je tichá ztráta zachycená za cenu druhého otevření. Kromě vizuální kontrola vzorku v Excelu nebo LibreOffice, a kombinace zachytí drtivou většinu poškození z převodu, než odjde. To je celý důvod, proč fáze inventarizace napájí fázi ověření. Bez čísel předtím čísla potom nedokazují nic
Workbench s auditem jako prvním mění riskantní hromadný převod v měřitelný proces s karanténní dráhou pro soubory, které nemohou projít čistě. Všechna probe, počítací a převodní volání zde ukázaná jsou součástí HotXLS Delphi Component, která je provádí nativně v procesu bez automatizace Excelu