HotXLS vytváří tabulkové slicery Excelu z Delphi a C++Builderu jedním voláním — Worksheet.Slicers.Add(Table, ColumnName) — a zapisuje všech osm míst v balíčku, která slicer potřebuje: části slicer a slicerCache, oba content-type override, vztahy worksheetu a workbooku s jejich odpovídajícími extLst bloky a kreslicí kotvu
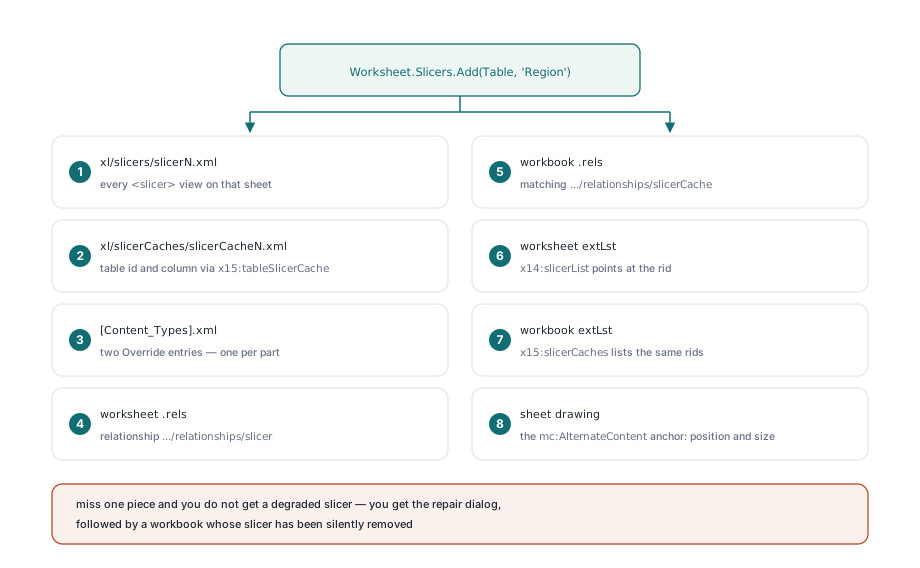
Slicer vypadá jako ovládací prvek, který upustíte na sheet. V souboru není nic takového. Je to distribuovaný záznam rozprostřený přes dvě nové části, dva relační grafy, tři extension bloky a jednu kreslicí kotvu, a celek se validuje jako jednotka, když Excel otevře balíček. Zmeškejte jeden kus a nedostanete degradovaný slicer; dostanete dialog opravy a za ním workbook s tiše odebraným slicerem. Tenhle způsob selhání dělá ze slicerů nepříjemnost k ruční emisi, a proto je tu zajímavé inženýrství v účetnictví, ne ve vykreslování
Proč se jeden slicer dotýká osmi míst v balíčku?
Protože slicer jsou tři samostatné koncepty, které OPC tlačí do tří samostatných domovů: stav filtru (v rozsahu workbooku), pohled (v rozsahu worksheetu) a tvar (v rozsahu kresby). HotXLS zapisuje přesně osm přistávacích bodů na jeden tabulkový slicer a každý z nich nese zátěž
xl/slicers/slicerN.xml— jedna část na worksheet, držící každý pohled<slicer>na tom listu v namespacehttp://schemas.microsoft.com/office/spreadsheetml/2009/9/mainxl/slicerCaches/slicerCacheN.xml— na úrovni workbooku, jeden na každý slicovaný sloupec tabulky, nesoucí skutečné bindování- a
<Override>v[Content_Types].xmlpro každou z těch dvou částí, používajícíapplication/vnd.ms-excel.slicer+xmlaapplication/vnd.ms-excel.slicerCache+xml(ECMA-376 Part 2 vyžaduje content type pro každou část a Excel bez nich balíček odmítne) - vztah worksheetu typu
.../office/2007/relationships/slicerplus rozšíření<x14:slicerList>uvnitř worksheetextLst, které ukazuje na ten rid - vztah workbooku typu
.../office/2007/relationships/slicerCacheplus rozšíření<x15:slicerCaches>uvnitř workbookextLst, vypisující stejné ridy - kotva
mc:AlternateContentv kresbě sheetu, která dává sliceru pozici a velikost - blok
<x15:tableSlicerCache>uvnitř cache části, který ho svazuje s id tabulky a id sloupce tabulky
Extension bloky používají standardní mechanismus extLst z ECMA-376 Part 1 §18.2.10: každý <ext> nese atribut uri, který identifikuje funkci, a čtečky, které GUID neznají, blok přeskočí. HotXLS rozlišuje tabulkové slicery od pivot slicerů jen podle toho GUID — {3A4CF648-6AED-40f4-86FF-DC5316D8AED3} pro tabulkový slicerList, {A8765BA9-456A-4dab-B4F3-ACF838C121DE} pro pivotový a odpovídajícně {46BE6895-7355-4a93-B00E-2C351335B9C9} a {BBE1A952-AA13-448e-AADC-164F8A28A991} pro dvě workbook rozšíření slicerCaches. Samotné tabulkové bindování žije pod {2F2917AC-EB37-4324-AD4E-5DD8C200BD13}. Ty konstanty jsou v unitu vystavené jako XlsxExtUriSlicerListX15, XlsxExtUriWbSlicerCachesX15 a XlsxExtUriTableSlicerCache, takže nic v cestě zápisu nenese magic string
Které části lze přehrát doslovně a které se musí znovu postavit?
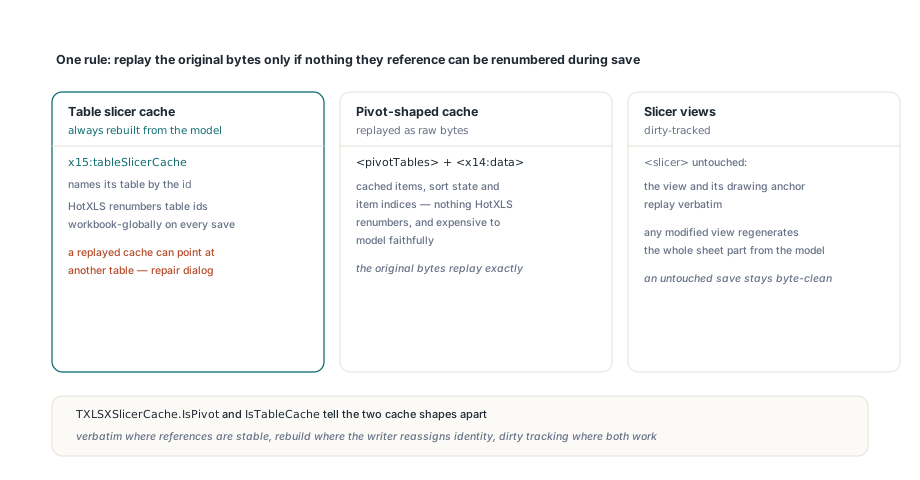
HotXLS odpovídá jediným pravidlem: část může přehrát své původní bajty, jen pokud nic, na co odkazuje, nemůže být při uložení přečíslováno. Cache tabulkových slicerů ten test nesplňuje, takže je HotXLS při každém uložení bezpodmínečně znovu staví z modelu — i když se uživatel sliceru nikdy nedotkl. Důvod je tableId: element <x15:tableSlicerCache> identifikuje svou tabulku atributem id na <table> a HotXLS přečíslovává id tabulek globálně napříč workbookem při zápisu. Raná implementace ukládala cache část při otevření jako raw bajty a při uložení je posílala zpět, což je správná strategie pro většinu neprůhledných částí. Produkovala soubory, které se v běžném případě otevřely čistě a v zajímavém spustily opravu: přidejte tabulku na dřívější sheet, uložte, a cache teď ukazuje na id tabulky, které patří něčemu jinému, nebo vůbec ničemu. Chyba je v obyčejném open-and-save regresním testu neviditelná, protože id se náhodou nepohnou
Cache pivotového tvaru jdou opačnou cestou. Jejich payload je <pivotTables> plus blok <x14:data> popisující cache položky, stav řazení a indexy položek — struktura bez přečíslování na straně HotXLS a taková, kterou je drahé věrně modelovat. Ty se drží jako raw bajty a přehrají se přesně, přičemž TXLSXSlicerCache.IsPivot a IsTableCache ty dvě rozlišují. Pohledy sliceru se řídí třetí politikou, dirty-tracked: nedotčený element <slicer> a jeho kreslicí kotva se přehrají doslovně a v okamžiku, kdy se upraví jakýkoli pohled na listu, se celá sheet část znovu vygeneruje z modelu. To je obecný tvar toho úsudku — doslovné přehrání tam, kde jsou reference stabilní, stavba z modelu tam, kde zapisovač přiděluje identitu znovu, dirty tracking tam, kde jsou přijatelné obojí — a platí daleko za slicery, jak to poznámky o lossless round tripu pro theme, extLst bloky a calcChain probírají do větší hloubky
Vytvoření tabulkového sliceru z Delphi
TXLSXSlicers.Add je celé API pro vytváření. Se TXLSXTable a jménem sloupce materializuje id sloupců tabulky, najde nebo vytvoří podkladovou TXLSXSlicerCache, rezervuje odpovídající defined name a ukotví pohled napravo od tabulky. Přetížení se dvěma argumenty volí umístění; se šesti bere explicitní 1-based inkluzivní box
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Slicer: TXLSXSlicer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('sales.xlsx');
    Sheet := Book.Sheets[0];

    // Výchozí umístění: dva sloupce od tabulky,
    // 13 řádků vysoký při výchozí výšce řádku 19pt
    Slicer := Sheet.Slicers.Add(Sheet.Tables[0], 'Region');
    Slicer.Caption   := 'Sales region';
    Slicer.StyleName := 'SlicerStyleLight1';
    Slicer.ColumnCount := 2;

    Book.SaveAs('sales-sliced.xlsx');
  finally
    Book.Free;
  end;
end;
Dvě pravidla pojmenovávání stojí za znalost, protože jsou konvence Excelu, ne vynálezy HotXLS. Cache se jmenuje Slicer_<column> s převedením neidentifikátorových znaků na podtržítka a kolize přilepí číselnou příponu — Slicer_Region, pak Slicer_Region1 a tak dál. A každé jméno cache je taky rezervované jako defined name workbooku s formulí #N/A, což dělá TXLSXSlicers.ReserveCacheDefinedName. Excel si to jméno vytváří sám, a záleží na tom: jména cache a defined names sdílejí jeden namespace, takže workbook, který už jméno Slicer_Region má, by jinak při příštím uložení kolidoval. Pokud stavíte tabulky a validaci společně, interakce defined names v článku o datové validaci, AutoFilteru a tabulkách pokrývají sousední případy. Sdílení se řídí stejným pravidlem jako Excel. TXLSXSlicerCaches.FindForTableColumn(ATableId, ATableColumnId) se konzultuje, než se vytvoří nová cache, takže dva pohledy sliceru nad stejným sloupcem tabulky — jeden na dashboard listu, jeden na detailním — sdílejí jedinou cache část a zůstávají filtr-synchronizované. Smazání pohledu spouští zpětnou kontrolu napříč každým listem workbooku a upustí cache plus její rezervované jméno #N/A jen tehdy, když zmizel poslední pohled, který na ni odkazoval
Jak zůstávají id vztahů stabilní na obou koncích?
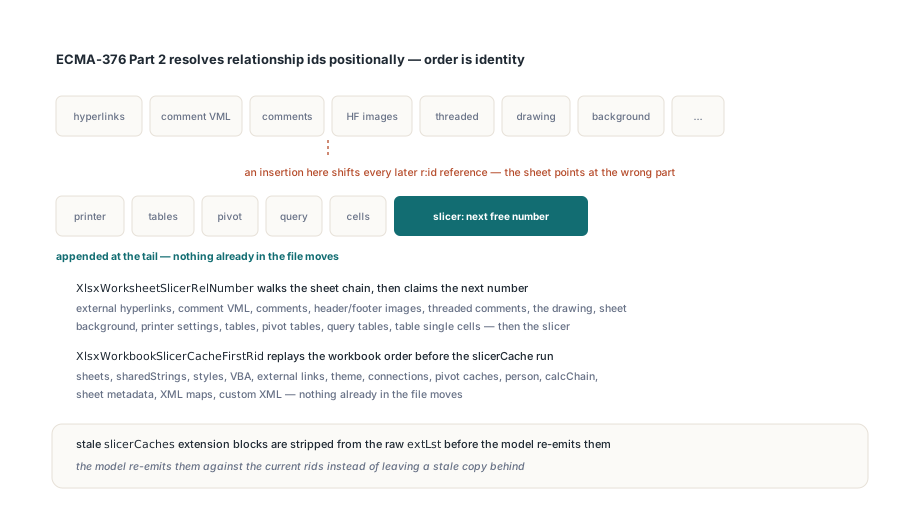
Zůstávají stabilní, protože HotXLS počítá slicer rid přehráním přesného pořadí, ve kterém emituje každý jiný vztah, a nové vztahy přilepí na konec. Nic, co už v souboru je, se nehýbe. Zní to jako over-engineering, dokud neodladíte alternativu. Id vztahů ve worksheet .rels jsou odkazované zevnitř worksheet části — hyperlinky, kresbou, komentáři, tabulkovými částmi — a ECMA-376 Part 2 je rozlišuje pozičně uvnitř relačního grafu, ne podle nějaké stabilní identity. Když zapisovač vloží slicer vztah doprostřed, každá reference po něm se posune o jedničku a sheet tiše začne ukazovat na špatnou část. Takže XlsxWorksheetSlicerRelNumber prochází celý deterministický řetězec — externí hyperlinky, pak komentářové VML, komentáře, hlavičkové a patičkové obrázky, threaded comments, kresbu, pozadí sheetu, nastavení tiskárny, tabulky, pivot tabulky, query tabulky, table single cells — a teprve pak si nárokuje další číslo pro slicer. XlsxWorkbookSlicerCacheFirstRid dělá totéž na straně workbooku: sheets, sharedStrings, styles, VBA, external links, theme, connections, pivot cache, person, calcChain, sheet metadata, XML maps, custom XML, pak běh slicerCache. Obecný problém je rozebraný v kusu o OPC relationship resolution. Extension na straně workbooku pak z těch čísel staví XlsxBuildWorkbookSlicerCachesExtXml, a pokud zdrojový soubor už extension bloky slicerCaches měl, nejdřív se z raw extLst odstraní, takže je model pře-emituje proti aktuálním ridům místo ponechání zastaralé kopie
Kotva AlternateContent a její legacy fallback
Kreslicí kotva je jediné místo, kde markup sliceru skutečně zdivočí, a ta divokost je záměrná. HotXLS emituje tvar uvnitř elementu mc:AlternateContent podle ECMA-376 Part 3, s větví Choice, kterou berou Excel 2013 a novější, a větví Fallback pro všechno starší
// Co XlsxSlicerAnchorPayloadXml produkuje, strukturálně:
//
//   <mc:AlternateContent>
//     <mc:Choice xmlns:sle15=".../drawing/2012/slicer" Requires="sle15">
//       <xdr:graphicFrame>
//         <a:graphicData uri=".../drawing/2010/slicer">
//           <sle:slicer xmlns:sle=".../drawing/2010/slicer" name="Region"/>
//         </a:graphicData>
//       </xdr:graphicFrame>
//     </mc:Choice>
//     <mc:Fallback><xdr:sp>...notice shape...</xdr:sp></mc:Fallback>
//   </mc:AlternateContent>
Podívejte se na ty dva namespace. Token Requires="sle15" se rozkládá na slicer namespace z roku 2012, což je verze brány — čtečka, která slicerům z roku 2012 nerozumí, musí přeskočit celou větev Choice. Ale graphicData/@uri a element sle:slicer uvnitř používají namespace 2010, protože to je identifikátor na kreslicí straně, který graphic frame používal vždycky. Otočit to naruby produkuje soubor, který Excel otevře bez reptání a pak vykreslí jako prázdný frame, což je symptóm, na který se nezapomíná. Větev Fallback drží obyčejný obdélník s textovým tělem vysvětlujícím, že tabulkové slicery tato verze nepodporuje — to je to, co čtečka z éry 2007 kreslí místo ovládacího prvku, a proto starší Excel umí workbook round-tripnout, aniž by cokoli zničil. TXLSXSlicer vystavuje geometrii jako 1-based inkluzivní box přes SetBounds(ARow1, ACol1, ARow2, ACol2) a jednotlivé vlastnosti FromRow / ToCol, plus AnchorType pro obvyklé chování move-and-size-with-cells. HasAnchor je False pro jeden konkrétní případ: slicer vnořený uvnitř group shape. Ty se přehrají se svou group kotvou doslovně a HotXLS pro ně záměrně nesyntetizuje druhou kotvu, protože by to tvar emitovalo dvakrát
Úprava existujícího sliceru
var
  Slicer: TXLSXSlicer;
  Cache: TXLSXSlicerCache;
begin
  Slicer := Sheet.Slicers.FindByName('Region');
  if Slicer <> nil then
  begin
    Slicer.SetBounds(2, 8, 16, 11);      // 1-based, inkluzivní
    Slicer.ShowCaption := 1;             // -1 = atribut vynechán
    Slicer.LockedPosition := 1;
    Slicer.RowHeightEmu := 19 * XlsxEmuPerPoint;   // 241300 EMU

    Cache := Slicer.Cache;
    if Cache <> nil then
    begin
      Cache.SortOrder   := 'descending';
      Cache.CrossFilter := 'showItemsWithNoData';
    end;
  end;

  // Odebrání posledního pohledu nad sloupcem upustí jeho cache
  // i rezervované defined name #N/A
  Sheet.Slicers.Delete(Sheet.Slicers.IndexByName('Region'));
Trojstavové celočíselné vlastnosti si zaslouží poznámku, protože vypadají jako modelovací nehoda a nejsou. ShowCaption, LockedPosition, ColumnCount, StartItem a CustomListSort všechny používají -1 k vyjádření, že atribut ve zdrojovém souboru chyběl a při zápisu má chybět i nadále, přičemž 0 a 1 jsou explicitní hodnoty. Excel v pár místech zachází s chybějícím a explicitně defaultním jinak a zachování toho rozdílu drží byte diff nedotčeného uložení čistý. RowHeight a ColumnWidth se drží jako raw řetězce z příbuzného důvodu: Excel zapisuje do těch EMU atributů desetinná čísla a jejich přeparsování přes integer by na round tripu ztratilo přesnost. RowHeightEmu je celočíselný pohodlný přístup přes stejné úložiště, s XlsxSlicerDefaultRowHeight na 241300 EMU — 19 bodů při poměru XlsxEmuPerPoint 12700
Kde to končí
Dva poctivé limity. Za prvé, HotXLS modeluje tabulkový slicer kompletně, ale vytváření pivot slicerů nemodeluje — umíte otevřít workbook s pivot slicery, přečíst jejich identitu, zachovat je při uložení a smazat je, ale cache strana se přehrává jako bajty a žádné API na stavbu od nuly není. Za druhé, slicer sám nic nefiltruje. Je to UI nad sloupcem tabulky a stav viditelných řádků, který řídí, je na straně Excelu; HotXLS zapisuje ovládací prvek a bindování, ne spočítaný výsledek filtru. Pokud chcete řádky v uloženém souboru skutečně vyfiltrované, nastavte i AutoFilter tabulky. Jakýkoli atribut, který HotXLS na <slicer> nebo <x15:tableSlicerCache> nemodeluje, se přenese beze změny, takže slicer z novějšího buildu Excelu se pořád re-serializuje s neznámými atributy neporušenými, i když ho přesunete. To je vlastnost, která dělá cestu dirty-rebuild bezpečnou: stavba z modelu je přijatelná jen tehdy, když je model nadmnožinou toho, co naparsoval. GUID-označený extension mechanismus z ECMA-376 Part 1 §18.2.10 a definice slicer částí v [MS-XLSX] jsou to, co tu záruku vůbec umožňuje vyjádřit
Tabulkové slicery se dodávají v HotXLS Delphi Component, který čte a zapisuje XLSX, XLSM a legacy BIFF workbooky od Delphi 5 po aktuální release, plus C++Builder a Free Pascal, bez instalace Excelu a bez OLE. Plný API reference a trial build jsou na produktové stránce HotXLS Delphi Spreadsheet Component