Napište do buňky =NORM.DIST(115,100,15,TRUE) a Excel bez okolků vrátí 0.8413447. To volání vypadá jako vyhledání v tabulce. Není. Za tím jediným číslem stojí kumulativní normální rozdělení, integrál bez uzavřeného tvaru, a za CHISQ.INV.RT a BETA.DIST sedí speciální funkce, které pečlivá knihovna musí vyhodnotit, ne odhadnout od oka. Tabulková komponenta, jež si nárokuje kompatibilitu s Excelem, musí tyto hodnoty reprodukovat do poslední číslice, kterou Excel ukáže, což znamená reprodukovat numerické metody, ne jen názvy funkcí
HotXLS implementuje více než padesát těchto statistických funkcí a práce, díky které jsou správné, je z řádku vzorců téměř neviditelná. Tohle je prohlídka toho, jak je engine počítá: sdílené jádro speciálních funkcí, rozhodnutí o větvích, která drží aritmetiku stabilní, a jedna chyba v inverzním normálním rozdělení, jež se dlouho skrývala ve chvostu, protože běžný případ se rozbitého řádku nikdy nedotkl
Jedno volání v listu, padesát rozdělení za ním
Funkce pokrývají rodiny, po kterých statistický sešit sahá. Je tu normální rodina, NORM.DIST a NORM.S.DIST s jejich inverzemi; rodina gamma a chí-kvadrát, GAMMA.DIST, CHISQ.DIST, CHISQ.DIST.RT, CHISQ.INV.RT; rodina beta, BETA.DIST a BETA.INV; výběrová rozdělení T.DIST, T.DIST.2T, F.DIST a F.INV; diskrétní dvojice BINOM.DIST a POISSON.DIST; a pomocníci pro statistickou inferenci jako CONFIDENCE.T a CONFIDENCE.NORM. Ze židle volajícího je každá z nich jediný vzorec. Nastavíte vstupy do buněk, požádáte sešit o vyhodnocení a přečtete výsledek
var
  wb: IXLSWorkbook;
  sh: IXLSWorksheet;
begin
  wb := TXLSWorkbook.Create;
  sh := wb.Sheets.Add;
  sh.Range['A1', 'A1'].Value := 115;   // pozorování
  sh.Range['A2', 'A2'].Value := 100;   // střední hodnota
  sh.Range['A3', 'A3'].Value := 15;    // směrodatná odchylka

  // Parser vzorců XLS používá jako oddělovač argumentů ';'.
  Writeln(wb.Calculate('=NORM.DIST(A1;A2;A3;TRUE())'));   // 0.8413447
  Writeln(wb.Calculate('=CHISQ.INV.RT(0.05;10)'));        // 18.3070381
  Writeln(wb.Calculate('=BETA.DIST(0.5;2;3;TRUE())'));    // 0.6875
end;
Metoda Calculate na sešitu zkompiluje a vyhodnotí ad hoc vzorec proti živému listu a vrátí Variant. Jeden detail napoprvé leckoho podrazí: parser vzorců za metodou Calculate bere jako oddělovač argumentů středník, takže se píše =SUM(A1;B1), ne =SUM(A1,B1). Vzorce uložené v buňkách si drží čárku podle standardu Excelu. Tentýž evaluátor rozesílá každou statistickou funkci níže, takže jakmile jedna z nich v Calculate funguje, ostatní jdou stejnou cestou
Dvě funkce, na kterých stojí všechno ostatní
Většina kumulativních rozdělení v této sadě se nepočítá sčítáním ani integrováním vlastních definic. Počítají se ze dvou speciálních funkcí: regularizované dolní neúplné gamma, psané P(a, x), a regularizované neúplné beta, psané Ix(a, b). Uvnitř jsou to pomocné funkce, o které se dispečeři opírají, a řetěz je krátký. CDF chí-kvadrát je CDF gamma s tvarem df/2 a měřítkem 2. CDF gamma je přímo P(a, x). Kumulativní funkce t, F i binomického rozdělení jsou všechno hodnoty regularizované neúplné beta ve správných argumentech. CDF Poissonova rozdělení je horní neúplná gamma Q. Napište funkce gamma a beta dobře a tucet rozdělení jejich přesnost zdědí zadarmo
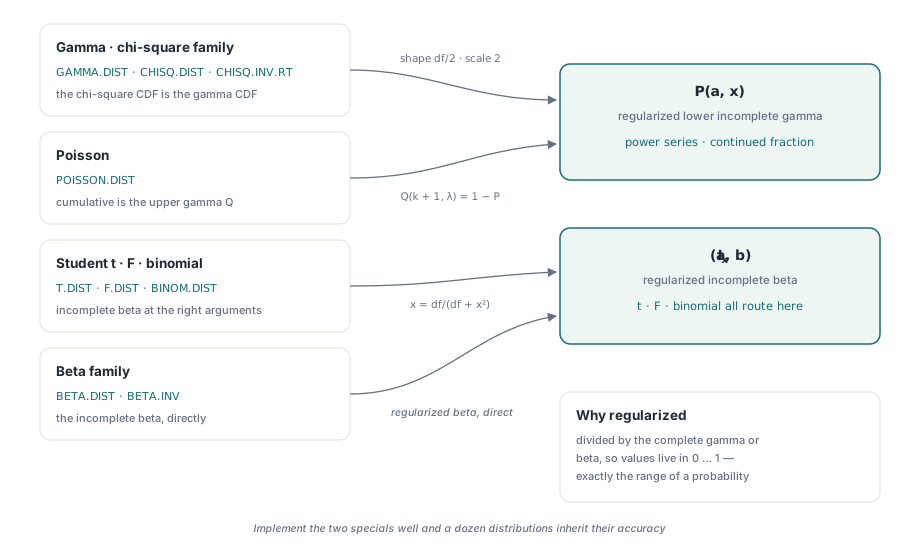
Slovo „regularizované“ je celý vtip. Surová neúplná gamma roste jako faktoriál a surový integrál beta může podtéct nebo přetéct dávno předtím, než to udělá odpověď. Regularizované tvary se dělí úplnou gamma nebo beta, takže žijí celé v intervalu od nuly do jedné, což je přesně rozsah, který zabírá pravděpodobnost. Právě tato normalizace umožňuje, aby táž rutina obsloužila chí-kvadrát se dvěma stupni volnosti i se dvěma sty, aniž by mezivýsledky utekly z rozsahu typu double. Vysvětluje to i to, proč se CDF nepočítá sčítáním dlouhého chvostu členů hustoty: každý člen si nese vlastní zaokrouhlovací chybu, chyby se během běhu řady kumulují a regularizovaná speciální funkce se sčítání úplně vyhne tím, že místo něj vyhodnotí rychle konvergující řadu nebo řetězový zlomek
Řada pod diagonálou, řetězový zlomek nad ní
Rutina neúplné gamma udělá jedno rozhodnutí dřív, než cokoli spočítá: porovná x s a + 1. Ta hranice není libovolná. Rozvoj P(a, x) v mocninnou řadu konverguje rychle, když je x vůči a malé, a pomalu, nakonec nepoužitelně, když je x velké. Řetězový zlomek má opačnou povahu. Engine tedy používá mocninnou řadu pro x pod a + 1 a Lentzův řetězový zlomek pro x rovné a + 1 nebo větší a po každé větvi chce jen tu práci, ve které je dobrá
Řetězový zlomek potřebuje jednu pojistku. Lentzova metoda pracuje tak, že si nese průběžný čitatel a jmenovatel a jmenovatel v každém kroku převrací, a když se kterýkoli z nich blíží nule, převrácení vyletí do vzduchu. Řešením je drobná spodní mez: kdykoli mezivýsledek klesne v absolutní hodnotě zhruba pod 1e-30, ořízne se na 1e-30, což udrží rekurenci konečnou, aniž by to narušilo zkonvergovanou hodnotu. Táž mez se ze stejného důvodu objevuje v řetězovém zlomku neúplné beta. Je to malá konstanta, která nese velkou váhu — rozdíl mezi stabilním vyhodnocením a dělením něčím, co je od nuly k nerozeznání
Horní chvost, Q(a, x), je prostě 1 minus P(a, x), a přesně tak se počítá kumulativní větev Poissonova rozdělení: pravděpodobnost nejvýše k událostí se střední hodnotou λ je Q(k + 1, λ). Vést to přes horní neúplnou gamma místo sečtení k + 1 Poissonových členů je opět volba vyhodnotit jeden konvergentní výraz místo hromadění mnoha malých
Diskrétní pravděpodobnosti bez přetečení faktoriálu
Diskrétní rozdělení přinášejí jiné nebezpečí. Binomická pravděpodobnostní funkce obsahuje binomický koeficient a koeficient „padesát dva nad dvaceti šesti“ je obrovské celé číslo. Vytvořte jej přímo a čitatel přeteče typ double dřív, než jej dělení stáhne zpátky na rozumnou pravděpodobnost. Engine jej nikdy nevytváří. Faktoriály počítá v logaritmickém prostoru funkcí log-gamma, logaritmy sčítá a odečítá, přimíchá logaritmus pravděpodobnosti úspěchu a neúspěchu a exponenciálu použije jedinkrát úplně na konci
// Binomická pravděpodobnostní funkce, vyhodnocená celá v logaritmickém prostoru.
// LnGammaF(n+1) je ln(n!); ty tři logaritmy faktoriálů tvoří ln(C(n,k))
// a celý exponent se sestaví ještě před jediným voláním Exp.
//   ln P(X=k) = ln(n!) - ln(k!) - ln((n-k)!) + k*ln(p) + (n-k)*ln(1-p)
result := Exp(LnGammaF(nt + 1) - LnGammaF(kk + 1) - LnGammaF(nt - kk + 1)
  + kk * Ln(pp) + (nt - kk) * Ln(1 - pp));
Samotná funkce log-gamma je Lanczosova aproximace, přesná na celé kladné poloose a levná na vyhodnocení. Protože se každá velká veličina drží jako svůj logaritmus až do závěrečného Exp, největší číslo, které rutina kdy zhmotní, je sama pravděpodobnost, tedy nejvýše jedna. Poissonova pravděpodobnostní funkce jde stejným receptem, kde jediný člen log-gamma zastupuje faktoriál ve jmenovateli. Uzavřené tvary jsou na okrajích ošetřeny zvlášť, kde je p přesně nula nebo jedna, takže kód nikdy nezavolá Ln(0). HotXLS vrací 0.2460938 pro BINOM.DIST(5,10,0.5,FALSE) a 0.6766764 pro kumulativní POISSON.DIST(2,2,TRUE), což se shoduje s Excelem do všech číslic, které vypíše
Inverze ohraničením dopředné křivky
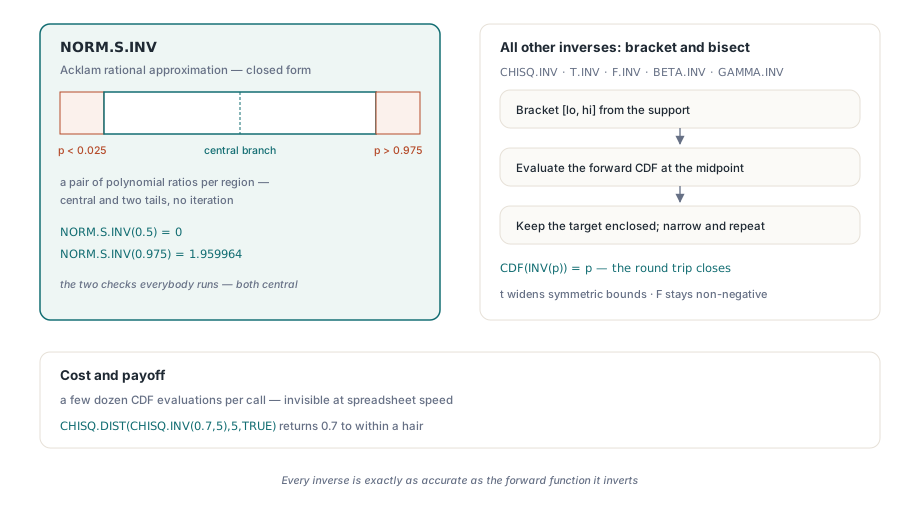
Inverzní distribuční funkce se ptá opačně: je dána pravděpodobnost, najdi hodnotu, jejíž CDF se jí rovná. Rychlý přímý vzorec má v této sadě jediná inverze. NORM.S.INV, inverze standardního normálního rozdělení, používá Acklamovu racionální aproximaci, dvojici polynomiálních podílů přesných zhruba na přesnost typu double v celém rozsahu, rozdělenou na centrální oblast a dva chvosty. Je to vyhodnocení v uzavřeném tvaru bez jediné iterace
Ostatní inverze takový vzorec nemají, engine je tedy invertuje numericky. Odpověď ohraničí dolní a horní mezí zvolenou z nosiče rozdělení a pak půlí interval: vyhodnotí dopřednou CDF ve středu, posune tu mez, která udrží cílovou pravděpodobnost uvnitř, a opakuje, dokud není interval úzký. U inverzí gamma a chí-kvadrát začíná ohraničení na nule a na štědrém horním odhadu postaveném z tvaru a měřítka, přičemž horní mez zdvojnásobuje, dokud pravděpodobnost není uzavřena. Inverze t ohraničuje symetrické meze, které se rozšiřují ven; inverze F půlí na nezáporném intervalu. Cenou je několik desítek vyhodnocení CDF na volání, což je při rychlosti tabulky neviditelné, a přínosem je, že každá inverze je přesně tak přesná jako dopředná funkce, kterou invertuje. Proto se okružní cesta jako CHISQ.DIST(CHISQ.INV(0.7,5),5,TRUE) vrátí jako 0.7 s přesností na vlásek
Dekadický logaritmus, který se skrýval ve chvostu
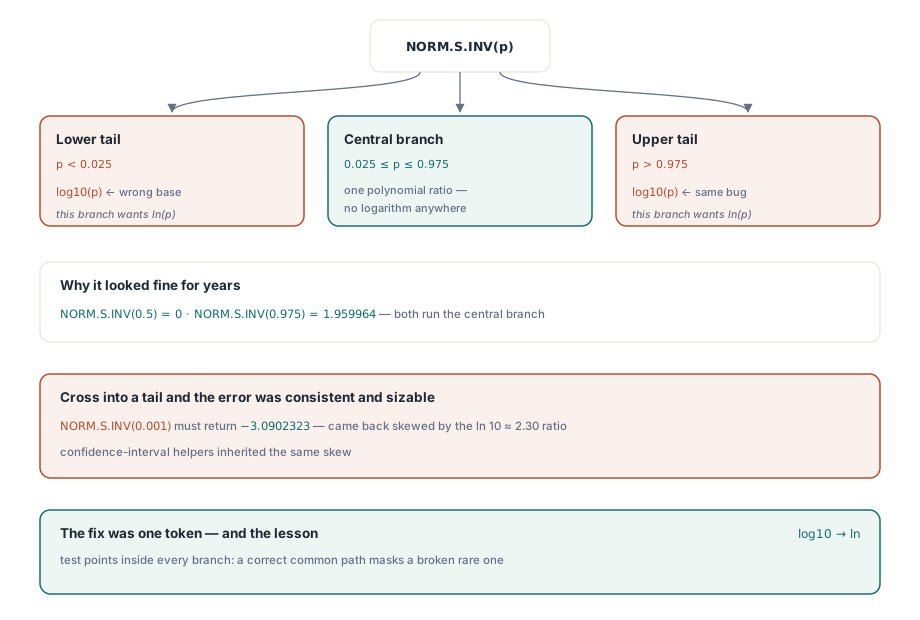
Tady je ta chyba, kterou stojí za to vyprávět, protože je z toho druhu, jenž přežívá dlouho. Acklamova rutina pro inverzní normální rozdělení má tři větve. Široká centrální větev, používaná vždy, když pravděpodobnost leží zhruba mezi 0.025 a 0.975, prožene vstup polynomiálním podílem, ve kterém není nikde žádný logaritmus. Obě chvostové větve, pro velmi malé nebo velmi velké pravděpodobnosti, si ze vstupu nejprve berou logaritmus, protože chvost se chová jako odmocnina z minus přirozeného logaritmu p
Raná verze chvostové větve brala dekadický logaritmus tam, kam patřil přirozený. Ty dva se liší konstantním faktorem asi 2.30, takže výsledky ve chvostu byly chybné o soustavný a pořádný kus. A přesto funkce v každé zběžné kontrole vypadala v pořádku, protože zběžné kontroly žijí uprostřed. NORM.S.INV(0.5) je nula, NORM.S.INV(0.975) je učebnicových 1.959964 a obojí běží centrálním polynomem, který žádný logaritmus vůbec nevolá. Chyba se ukázala, teprve když pravděpodobnost přešla do chvostu, řekněme NORM.S.INV(0.001), jež musí vrátit -3.0902323 a místo toho se vracela mimo o poměr přirozeného a dekadického logaritmu. Každá funkce, která se ve chvostu opírá o inverzní normální rozdělení, včetně pomocníků pro intervaly spolehlivosti, zdědila tentýž posun. Poučení je banální a drahé: funkce s větvením potřebuje testovací body uvnitř každé větve, protože správná běžná cesta s chutí zamaskuje rozbitou vzácnou. Oprava byla změna jediného tokenu z dekadického logaritmu na přirozený a hodnoty ve chvostu zapadly k těm Excelovým
Znaménko x rozhoduje o chvostu Studentova rozdělení
Kumulativní funkce Studentova rozdělení t nese jemnost, kterou lze snadno vzít obráceně. Její hodnota pochází z regularizované neúplné beta vyhodnocené v df / (df + x²), jenže ta hodnota beta je pravděpodobnost ve chvostu za velikostí x, ne kumulativní pravděpodobnost až po x. Symetrický tvar rozdělení t znamená, že převod závisí na tom, na které straně nuly x leží
// CDF Studentova rozdělení t. ib je regularizovaná neúplná beta v df/(df+x*x),
// která měří symetrický chvost. Kumulativní hodnota závisí na
// znaménku x; vrátit ib bez převodu dá špatný chvost.
ib := BetaIF(df / 2, 0.5, df / (df + x * x));
if x > 0 then
  result := 1 - 0.5 * ib        // nad střední hodnotou: jedna minus půl chvostu
else if x < 0 then
  result := 0.5 * ib            // pod střední hodnotou: půl chvostu
else
  result := 0.5;                // přesně ve střední hodnotě
Pro x nad nulou je kumulativní pravděpodobnost jedna minus polovina symetrického chvostu; pro x pod nulou je to polovina toho chvostu; v nule je to přesně jedna polovina. Vraťte hodnotu beta přímo a ohlásíte špatnou stranu rozdělení, mimo o celé tělo křivky pro jakékoli nenulové x. Varianty pro pravý chvost a oba chvosty stojí na téže větvi, a proto se T.DIST.2T(1,1) vrací jako 0.5 a T.DIST(1,1,TRUE) jako 0.75, a inverze T.INV půlí interval proti této opravené CDF, takže se okružní cesta uzavře
Nic z toho není z buňky vidět, a to je zamýšlený výsledek. Napíšete vzorec a přečtete číslo, které se shoduje s Excelem. Pokud engine rozšiřujete vlastní logikou, mechaniku registrace funkce popisuje náš průchod enginem vzorců a vlastními funkcemi a způsob, jakým vzorce sahají napříč listy a na pojmenované oblasti, popisuje článek o definovaných jménech a vzorcích napříč listy. Všechno to je součástí tabulkové komponenty HotXLS pro Delphi pro Delphi a C++Builder, vedle API pro čtení, zápis, grafy a formátování popsaných jinde na tomto blogu