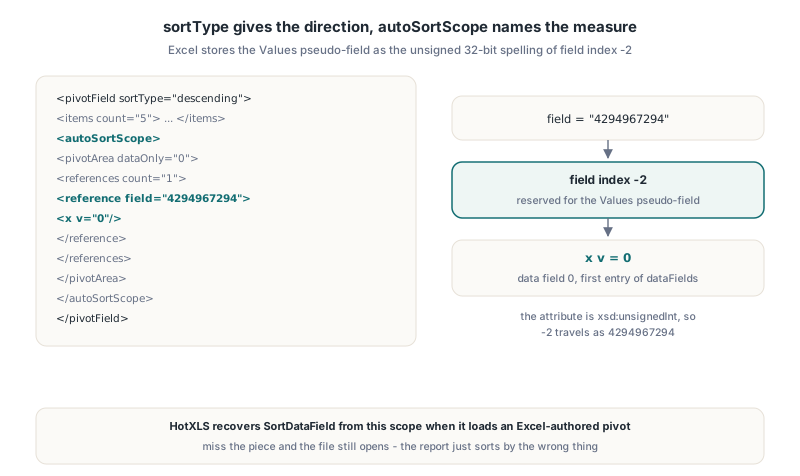
HotXLS řadí položky PivotTable podle hodnoty v Delphi přes dvě vlastnosti na TXLSPivotField: SortType vybírá vzestupně nebo sestupně a SortDataField jmenuje nulově indexované datové pole, jehož součty řídí pořadí. Když HotXLS otevírá XLSX psaný Excelem, obnoví to datové pole z elementu autoSortScope, kde Excel ukládá pole Values jako field="4294967294", beznaménkový zápis -2
Řazení podle hodnoty je požadavek, který dostane nakonec každá prodejní zpráva: „ukaž mi regiony od největšího po nejmenší". V UI Excelu jsou to dva kliky. V formátu souboru je to atribut, vnořená pivot oblast, rezervovaný index pole a ordinal vybraného datového pole a čtečka, které jediný z těch kusů chybí, otevře soubor bez stížnosti. Jen řadí podle špatné věci
Kde Excel ukládá míru řazení podle hodnoty?
Excel ukládá míru řazení jen uvnitř autoSortScope, ne na samotném poli. Atribut sortType na <pivotField> (hodnota ECMA-376 Part 1 ST_FieldSortType: manual, ascending nebo descending) říká, kterým směrem řadit. Podle které míry řadit žije v dítěti <autoSortScope>, které obaluje <pivotArea>, jejíž reference datové osy vybírá jedno datové pole
<pivotField axis="axisRow" showAll="0" sortType="descending">
  <items count="5"> ... </items>
  <autoSortScope>
    <pivotArea dataOnly="0" outlineLevel="all" fieldPosition="0">
      <references count="1">
        <reference field="4294967294" count="1" selected="0">
          <x v="0"/>
        </reference>
      </references>
    </pivotArea>
  </autoSortScope>
</pivotField>
Element reference normálně míří na pivot pole indexem. Index pole -2 je v části PivotTable ECMA-376 rezervovaný pro pseudopole Values, to, které Excel ukazuje jako „Values", když na ose sedí dvě a více měr. Atribut je typovaný jako beznaménkový 32bitový integer, takže -2 jde po drátě jako 4294967294. <x v="0"/> pod ním vybírá datové pole 0, první položku v <dataFields>. Existuje i atribut rankBy na <pivotField>, ale v souborech, které jsme srovnávali, ho Excel vynechal a spoléhal jen na scope
Proč se míra řazení vrátila jako -1?
Čtečka HotXLS původně ztratila míru řazení, protože 4294967294 se nevejde do znaménkového 32bitového integeru. Helper atributu je tenký wrapper nad StrToIntDef a hodnota mimo rozsah tiše vrátí default, takže test datové osy se nikdy netrefil, SortDataField zůstalo na -1 a pole si drželo jen sortType="descending" bez žádné míry
Selhání bylo tiché nejhorším možným způsobem. Sestupné pole bez míry stále řadí, jen podle popisku položky pozpátku, takže zpráva, kterou Excel seřadil podle součtu, se z HotXLS vrátila s obráceným pořadím položek. Nic nevyhodilo výjimku a čísla v každé buňce byla správná. Jen pořadí řádků bylo špatné, a to jen u souborů, které napsal Excel
Oprava v lxPivotXml.pas srovnává surový token atributu jako řetězec před jakoukoli celočíselnou konverzí. Nastavil-li rankBy už míru, vyhrává; jinak reference, jejíž token field je přesně '4294967294', řeší SortDataField ze své vybrané hodnoty x. Vyhodnocovací strana nepotřebovala změnu: komparátor už finalizoval součty po členech na osách řádků a sloupců, obsluhoval sestupné pořadí a rozhodoval remízy. Data se k němu prostě nikdy nedostala
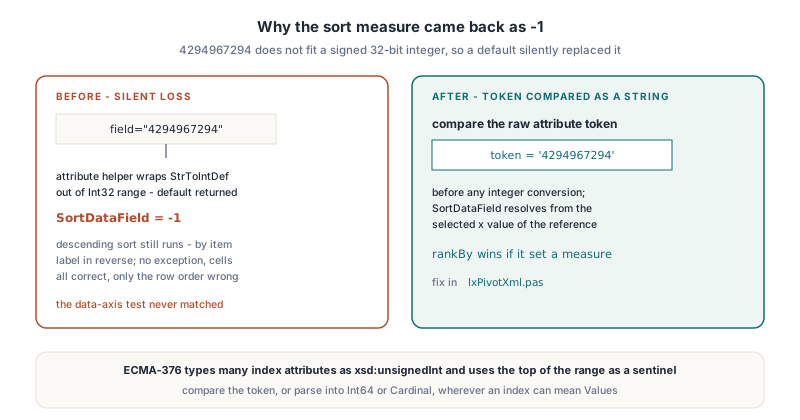
Obecná lekce platí pro jakoukoli čtečku OOXML psanou v Delphi. ECMA-376 typuje několik indexových atributů jako xsd:unsignedInt a pak používá strop rozsahu jako sentinel, takže znaménková čtečka s defaultním fallbackem změní rezervovanou hodnotu na „atribut chybí". Srovnávejte token, nebo parsujte do Int64 či Cardinal, kdekoli může index pole znamenat Values
Řazení položek pivotu podle míry z kódu Delphi
Chcete-li seřadit pivot pole HotXLS podle hodnoty, nastavte SortType na xlpfstAscending nebo xlpfstDescending a SortDataField na nulový index míry v seznamu DataFields tabulky. S SortType = xlpfstManual, což je default, se SortDataField ignoruje a položky si drží cache nebo programové pořadí
uses
  SysUtils, lxHandleX, lxPivot;

var
  Book: TXLSXWorkbook;
  Data, Report: TXLSXWorksheet;
  Pivot: TXLSPivotTable;
  Region: TXLSPivotField;
begin
  Book := TXLSXWorkbook.Create;
  try
    Data := Book.Sheets.Add('Data');
    Data.Cells[1, 1].Value := 'Region';
    Data.Cells[1, 2].Value := 'Product';
    Data.Cells[1, 3].Value := 'Units';
    // ... fill rows 2..41 ...
    Report := Book.Sheets.Add('Report');

    Pivot := Report.AddPivotTable('Data!A1:C41', 3, 1, 'UnitsByRegion');
    Region := Pivot.AddRowField('Region');
    Pivot.AddDataFieldByName('Units', xlpaSum);   // datové pole 0

    Region.SortType := xlpfstDescending;  // největší region první
    Region.SortDataField := 0;            // řadit podle Sum of Units
    Region.AutoSortScope := '0';          // vysílá i vlastní autoSortScope Excelu

    if Book.MaterializeNativePivotTable(Pivot) <> 1 then
      raise Exception.Create('Pivot layout was rejected');
    Book.SaveAs('units-by-region.xlsx');
  finally
    Book.Free;
  end;
end;
Dva detaily si zaslouží poznámku. Writer HotXLS vysílá SortDataField jako rankBy a není-li AutoSortScope prázdný, zapíše taky blok autoSortScope s referencí datové osy 4294967294 a vloží řetězec vlastnosti do slotu x v. Při načtení dostává AutoSortScope tentýž token x v, takže u řazení podle hodnoty drží vlastnost ordinal datového pole jako text. Nastavení na '0' proto produkuje soubor, který nese míru na obou místech, což je nejbližší shoda s tím, co sám Excel zapisuje. MaterializeNativePivotTable pak připraví seřazenou mřížku i její layout metadata společně a vrátí 1 při úspěchu nebo -1 s diagnostikou
Řadí se nejen řádky položek. Sloupcová pole procházejí stejným komparátorem, se součty po sloupcích místo součtů po řádcích, takže sloupcové pole s SortType = xlpfstDescending a platným SortDataField seřadí své sloupce podle hodnoty úplně stejným způsobem
Prozkoumání řazení, které už sešit Excelu nese
U souborů psaných Excelem plní HotXLS SortType, SortDataField a AutoSortScope při načítání definice pivotu, takže můžete auditovat nebo měnit řazení zprávy bez přestavby tabulky. Snippet níže vypíše každé pole, které řadí podle míry, a jmenuje míru podle jejího DisplayName
var
  Book: TXLSXWorkbook;
  Pivot: TXLSPivotTable;
  Field: TXLSPivotField;
  I: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('sales-report.xlsx');
    Pivot := Book.Sheets.SheetByName('Report').PivotTables[0];
    for I := 0 to Pivot.FieldCount - 1 do
    begin
      Field := Pivot.Fields[I];
      if (Field.SortType <> xlpfstManual) and (Field.SortDataField >= 0) then
        Writeln(Field.Name, ' sorted by ',
          Pivot.DataFields[Field.SortDataField].DisplayName);
    end;

    // překlopte řazení Region na vzestupné a znovu postavte existující mřížku
    Field := Pivot.FindFieldByName('Region');
    if Field <> nil then
      Field.SortType := xlpfstAscending;
    if Book.MaterializeNativePivotTable(Pivot, True) <> 1 then
      raise Exception.Create('Could not re-materialize the pivot');
    Book.SaveAs('sales-report-asc.xlsx');
  finally
    Book.Free;
  end;
end;
Druhý argument MaterializeNativePivotTable říká HotXLS, aby převzal existující výstupní rozsah pivotu místo brání ho jako kolizi. Tentýž vzor se objevuje v průvodci Show Values As rank a průběžnými součty v HotXLS, kde pořadí řazení záleží, protože průběžné součty se akumulují v zobrazovacím pořadí
Jak HotXLS rozhoduje remízy, když mají dvě položky stejnou hodnotu?
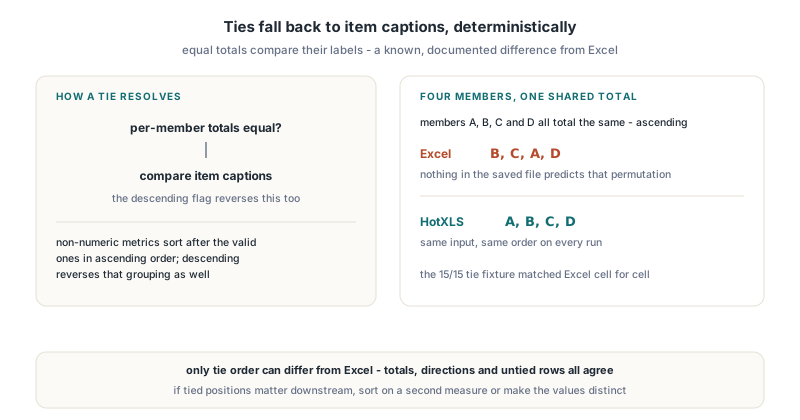
HotXLS rozhoduje remízy podle popisku položky, deterministicky, což je známý rozdíl vůči Excelu. Když mají dva členové identické součty, sáhne komparátor po srovnání jejich titulků a sestupný příznak obrací i to srovnání. Položky, jejichž metrika není platné číslo, se řadí za platné ve vzestupném pořadí a sestupný příznak obrací celé srovnání, včetně toho seskupení
Excel neslibuje žádné pořadí remíz vůbec. Ve fixture, kde čtyři členové A, B, C a D měli všechny stejný součet, vyprodukoval vzestupný sort v Excelu B, C, A, D. Nic v uložených metadatech nepředpovídá tu permutaci; je to vedlejší produkt nestabilního sortu a může se lišit mezi soubory. HotXLS vrací pro stejný vstup A, B, C, D. Naše ověření pro ten případ kontroluje sadu členů a hodnoty po členech místo sekvence a sestupná fixture s remízou 15/15 se s Excelem shodla buňku po buňce. Závisí-li váš downstream kód na přesné pozici remizujících řádků, řaďte podle druhé míry nebo udělejte hodnoty odlišnými
Sbalené členy a nejvnitřnější pole
Sbalené členy se materializují v HotXLS jako jeden agregátní řádek na sbalenou položku. Když Excel skryje detaily položky, zapíše sd="0" na ten <item>; HotXLS to vystavuje jako TXLSPivotItem.IsDetailHidden. Sbalená položka se renderuje s prostým popiskem, nahradí celý svůj podstrom a sbalení platí pro tu položku pod každým rodičem, zatímco obklopující bloky si drží vlastní mezisoučty
var
  Category: TXLSPivotField;
begin
  // Pivot má na řádcích Category (vnější) a Product (vnitřní)
  Category := Pivot.FindFieldByName('Category');
  if (Category <> nil) and (Category.ItemCount > 0) then
    Category.Items[0].IsDetailHidden := True;   // sbal první kategorii
  if Book.MaterializeNativePivotTable(Pivot, True) <> 1 then
    raise Exception.Create('Collapse was rejected');
end;
Sbalení se s řazením pojí předvídatelně: sbalený řádek je stále členem svého pole, takže si bere pozici ze svého součtu jako jakákoli jiná položka. Nejvnitřnější pole je jiné. Nemá žádnou vnitřní úroveň, takže nemá co sbalovat a od dřívější opravy HotXLS pro něj renderuje ani řádek mezisoučtu, i když je jeho příznak defaultSubtotal nastaven. Excel se chová stejně na jedno-polových i víceúrovňových osách a před tou změnou mohl HotXLS vysílat fantomový řádek Total pod nejvnitřnějším polem. K atributům na úrovni pole, které se tu objevují, popisuje průvodce HotXLS validitou schématu CT_PivotField, co schema vyžaduje na <pivotField> a jeho položkách
Pasti při kontrolování proti Excel automatizaci
Když křížově kontrolujete sort HotXLS proti Excelu přes COM automatizaci, volejte AutoSort s lokalizovaným titulkem míry, napsaným přesně tak, jak ho Excel ukazuje. Na čínsky hovořícím Excelu je defaultní titulek pro součtové pole Units '求和项:Units'; podání 'Sum of Units' na tom stroji nevyhodí žádnou chybu a nic nezmění. Tentýž skript, který funguje na anglickém Excelu, se jinde tiše stane no-opem, takže čtěte titulek z datového pole místo hard-codování
PivotField.SortTypenešel v Excel buildu, který jsme testovali, přečíst zpět přes COM, takže sort ověřujte z uloženého XML nebo vykreslených buněk- V tom buildu potlačilo rodičovské pole ruční skupiny na téže ose mimo řazené pole řazení členů podle hodnoty; řazený render pod rodiči ručních skupin není ověřený
- Zápisy do
PivotField.OutlineaPivotField.LayoutFormbyly v tom buildu také odmítnuty, takže outline layout pro fixture nastavte přesPivotTable.RowAxisLayout
Žádná z těch zvláštností nemění formát souboru, ale rozhodují o tom, zda regresní test dokazuje něco. Test, který volá AutoSort se špatným titulkem, projde proti pivotu, který nikdy seřazený nebyl
FAQ
Co znamená pole 4294967294 v souboru XML PivotTable?
Pole 4294967294 je beznaménkové 32bitové kódování indexu pole -2, které ECMA-376 rezervuje pro pseudopole Values. Uvnitř autoSortScope značí referenci datové osy a jeho dítě x vybírá, podle kterého datového pole se položky řadí
Řadí HotXLS položky pivotu podle hodnoty bez instalovaného Excelu?
Ano. HotXLS vyhodnotí sort sám, když materializuje pivot mřížku, s použitím součtů po členech vybraného datového pole, a zapíše sortType, rankBy a volitelně autoSortScope, takže Excel po refreshi drží totéž pořadí. Jen pořadí remíz mezi rovnými hodnotami se může od Excelu lišit
Proč jsou moje pivot položky seřazené abecedně místo podle hodnoty?
Obvykle proto, že pole má směr řazení, ale žádnou míru. Zkontrolujte, že SortType není xlpfstManual a že SortDataField leží mezi 0 a DataFieldCount - 1; s -1 řadí HotXLS položky podle popisku v požadovaném směru
Řazení podle hodnoty, sbalené členy i zbytek nativní pivot pipeline dodává HotXLS, komponenta Delphi pro tabulky XLS a XLSX, která čte, upravuje a zapisuje sešity Excelu bez instalovaného Excelu. Stavíte-li pivot od nuly nejdřív, tutorial HotXLS o stavbě a refreshi pivot tabulek pokrývá cache, pole a refresh, než se dostanete k jejich řazení