HotXLS Delphi Excel Component zachovává kontingenční tabulky OpenDocumentu během cyklu otevření a uložení ODS tak, že při otevření zachytí podstrom <table:data-pilot-tables> z content.xml doslovně a při uložení ho přehraje, a to od v2.382.0. Od v2.382.1 fragment navíc nese každou vazbu XML namespace, kterou deklarovali jeho předci, takže uložená definice pivotu zůstává well formed pro jakéhokoli konzumenta, ne jen pro HotXLS
Bug, který vynutil obě změny, vypadl z přísného korpusového běhu. Ukázka official-pivot.ods napsaná vývojářským buildem LibreOffice 6.1 drží jeden pivot jménem DataPilot1, který čte Sheet1.A2:E30 a výsledek ukotvuje v Sheet1.G6:J18. Otevřete ho HotXLsem, uložte beze změny, spočítejte elementy <table:data-pilot-table> ve výstupu: jedna dovnitř, nula ven, na Win32 i Win64 stejně. Nic v testu se pivotu nedotklo. První kolo sond porovnávalo jen konstanty buněk a prošlo; strukturní assertion je to, co ztrátu vystavil na světlo, což je připomínka, že „hodnoty sedí" je slabá definice věrnosti round tripu
Proč kontingenční tabulka ODS po uložení knihovnou zmizí?
ODS pivot zmizí proto, že HotXLS nemá žádný in-memory model kontingenčních tabulek OpenDocumentu a zapisovač ODS staví content.xml výhradně z modelu. Zapisovač skládá automatické styly, jeden <table:table> na list, <table:content-validations>, <table:named-expressions> a <table:database-ranges>, všechno generované z objektů, které sešit doopravdy drží. Definice pivotu — ODF 1.3 Part 3 §9.6, kontejner <table:data-pilot-tables> s jedním <table:data-pilot-table> na pivot, nesoucí jeho table:source-cell-range, potomky table:data-pilot-field, jeho table:target-range-address a table:buttons — nemá objekt, ve kterém by bydlela, takže regenerovaná část ji prostě vynechá
Kontrast s XLSX je záměrný. HotXLS parsuje pivot cache a pivot tabulky SpreadsheetML do reálného modelu, který můžete stavět, rozšiřovat počítanými poli a refreshovat z Delphi, takže ty uložení přežijí tím, že se přepíšou, ne zkopírují. ODS pivoty jsou mnohem vzácnější žádanka a modelovat slovník ODF data pilotů jen kvůli round tripu by bylo hodně kódu, který nikdo needituje. Pragmatická odpověď je ta samá, kterou HotXLS už aplikuje na neznámé bloky extLst v XLSX: nech si, co nemodeluješ, po bajtech, když to jde, po událostech, když nejde
Co první zachycení přes Pos pokazilo?
Zachycení z v2.382.0 vystřihlo definici pivotu z content.xml jako obyčejný řetězec a výstřižku chyběly deklarace namespace, které jí dávaly smysl. Implementace byla tak krátká, jak zní — dekóduj part do WideString, najdi otevírací tag přes Pos, najdi za ním zavírací tag, zkopíruj rozsah do FRawOdsDataPilotTablesXml na sešitu:
// HotXLS v2.382.0 -- o jedno vydání později nahrazeno
function OdsCaptureDataPilotTablesXml(Stream: TStream): WideString;
const
  OpenTag: WideString = '<table:data-pilot-tables';
  CloseTag: WideString = '</table:data-pilot-tables>';
var
  Text: WideString;
  StartPos, ClosePos: Integer;
begin
  Result := '';
  Text := LoadPartAsWideString(Stream);   // celé content.xml v paměti
  StartPos := Pos(OpenTag, Text);
  if StartPos = 0 then Exit;
  ClosePos := Pos(CloseTag, Copy(Text, StartPos, MaxInt));
  if ClosePos = 0 then Exit;
  Result := Copy(Text, StartPos, ClosePos + Length(CloseTag) - 1);
end;
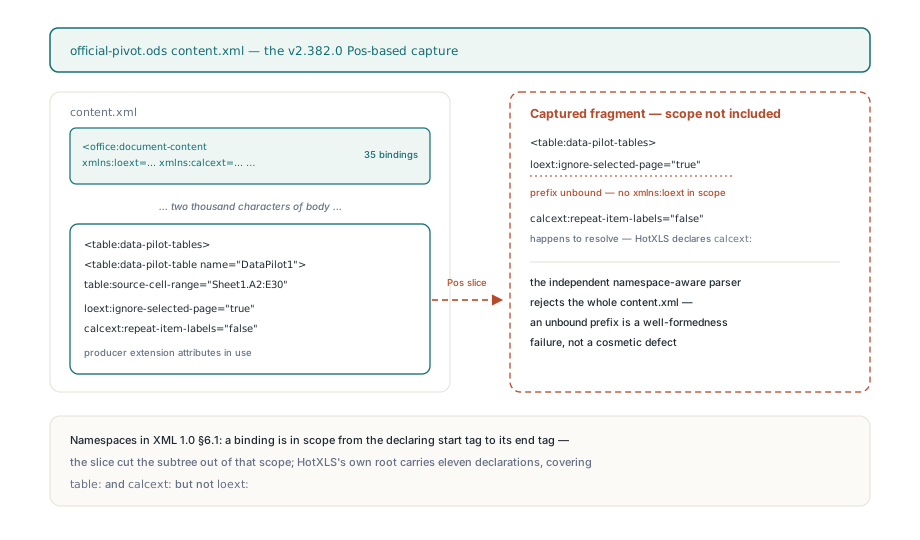
Count assertion zezelenal a oprava vyšla. Chytilo ji to druhou, přísnější kontrolu přidanou týž den: každý XML part uloženého balíčku putuje do nezávislého parseru vnímajícího namespace mimo HotXLS a tenhle parser odmítl nové content.xml chybou unbound-prefix. Pivot z LibreOffice nese atributy rozšíření producenta — loext:ignore-selected-page="true" na page fieldu, calcext:repeat-item-labels="false" na každé úrovni — a vystřižený řetězec ty atributy obsahoval, ale ne deklarace xmlns:loext a xmlns:calcext, které je vázaly. Ty deklarace seděly na kořeni <office:document-content> zdrojového souboru, pětatřicet z nich, dva tisíce znaků od pivotu
W3C Namespaces in XML 1.0 §6.1 definuje pravidlo, které z toho dělá tvrdé selhání, ne kosmetickou vadu: deklarace namespace je ve scope od start tagu elementu, na kterém stojí, až po jeho end tag a každé prefixované jméno v tom scope se rozřešuje proti ní. Vystřihněte podstrom z dokumentu a vystřihnete ho i ze scope. HotXLS píše vlastní kořen <office:document-content> s jedenácti deklaracemi — office, table, text, style, number, fo, draw, svg, xlink, calcext, tableooo — takže calcext: se náhodou rozřešilo, table: se náhodou rozřešilo a loext: ne. Parser vnímající namespace bere nevázaný prefix jako porušení well-formedness, což znamená, že celý part je nečitelný, ne jen jeden atribut
Jak HotXLS přenáší vazby xmlns předků na fragment?
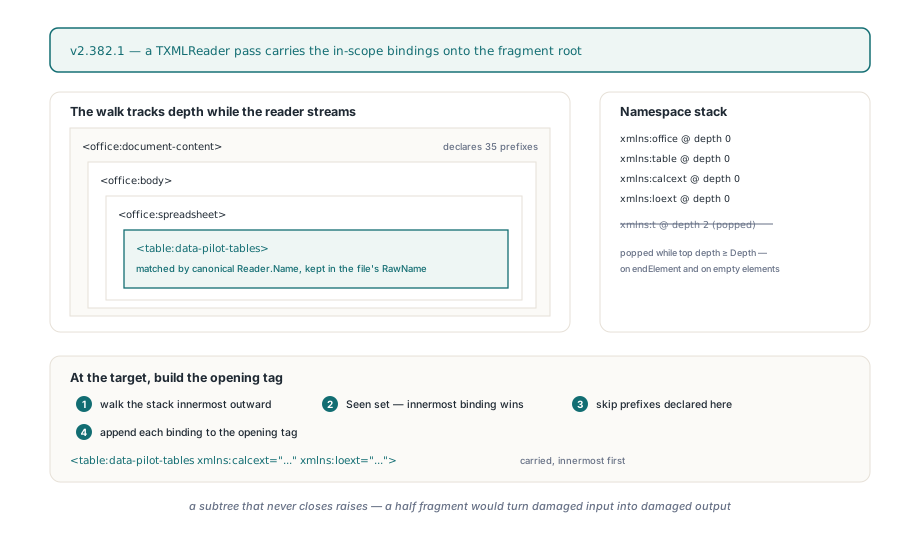
HotXLS v2.382.1 vyměnil řetězcový výstřižek za průchod content.xml vlastním streamovacím TXMLReader, který drží zásobník vazeb namespace označených hloubkou, v jaké byly deklarovány, a ve chvíli, kdy dosáhne cíle, zkopíruje stále účinné vazby na kořenový element fragmentu. Reader běží se zapnutým PreserveWhitespaceText, takže textové uzly se vracejí přesně tak, jak napsané, a znovu postavené tagy používají TXMLReader.RawName a TXMLReader.Attribute[I].RawName — hláskování prefixu ze souboru — místo kanonických jmen, která reader normálně podává parserům partů. Tady je jádro smyčky:
// Namespaces: TStringList 'xmlns:p=uri' s deklarující hloubkou v Objects[]
while Reader.Read do
begin
  if CaptureDepth >= 0 then
    XlsxAppendRawXmlReaderNode(Result, Reader);   // element, text, CDATA, komentář
  if Reader.NodeType = xmlntElement then
  begin
    for I := 0 to Reader.AttributeCount - 1 do
    begin
      AttrName := Reader.Attribute[I].RawName;
      if (AttrName = 'xmlns') or (Pos(WideString('xmlns:'), AttrName) = 1) then
        Namespaces.AddObject(String(AttrName) + '=' + String(Reader.Attribute[I].Value),
          TObject(NativeInt(Depth)));
    end;
    if (CaptureDepth < 0) and (Reader.Name = 'table:data-pilot-tables') then
    begin
      Opening := XlsxRawXmlReaderOpenTag(Reader);   // nejdřív ořízni koncové '>' nebo '/>'
      ...
      // Přeneste účinné vazby předků na kořen fragmentu.
      for I := Namespaces.Count - 1 downto 0 do
      begin
        AttrName := WideString(Namespaces.Names[I]);
        if Seen.IndexOf(String(AttrName)) >= 0 then Continue;   // vyhrává nejvnitřnější vazba
        Seen.Add(String(AttrName));
        if not Reader.HasAttribute(AttrName) then               // už tady deklarované? přeskočit
          Opening := Opening + ' ' + AttrName + '="' +
            XlsxEscapeAttr(WideString(Namespaces.ValueFromIndex[I])) + '"';
      end;
      ...
      CaptureDepth := Depth;
    end;
    if not Reader.IsEmptyElement then Inc(Depth);
  end
  else if Reader.NodeType = xmlntEndElement then
  begin
    Dec(Depth);
    if Depth = CaptureDepth then Exit;                           // podstrom se zavřel
  end;
  if (Reader.NodeType = xmlntEndElement) or
     ((Reader.NodeType = xmlntElement) and Reader.IsEmptyElement) then
    while (Namespaces.Count > 0) and
          (NativeInt(Namespaces.Objects[Namespaces.Count - 1]) >= Depth) do
      Namespaces.Delete(Namespaces.Count - 1);                   // opustit scope
end;
if CaptureDepth >= 0 then
  raise Exception.Create('OpenDocument pivot definition ended inside an element');
Tři detaily v té smyčce nesou správnost. Procházení zásobníku od nejvnitřnější vazby ven a zapamatování si každého prefixu v Seen implementuje stínování: když blížší předek převáže xmlns:table, vyhrává bližší hodnota, přesně jak §6.1 nařizuje. Přeskakování prefixů, které element deklaruje sám, vyhne se emisi téhož atributu dvakrát, což by byla jiná chyba well-formedness. A pop pravidlo pálí na end tagech i na prázdných elementech, protože <x/> nikdy neprodukuje událost EndElement — stejná samouzavírací past, kterou se muselo naučit zachycení extLst v XLSX. Párování cíle přes Reader.Name místo RawName je tišší výhra: reader kanonizuje URI namespace ODF tabulky na prefix table, takže producent, který ho napíše jako t:data-pilot-tables, pořád sedne, zatímco emitovaný fragment drží ten prefix, jaký použil producent
Smyčka navíc odmítá hádat. Když part skončí, dokud je zachycení pořád otevřené — useknuté nebo poškozené content.xml — OdsCaptureDataPilotTablesXml vyhodí výjimku místo vrácení napůl fragmentu, protože napůl fragment by se při uložení zapsal zpátky a proměnil poškozený vstup v poškozený výstup se jménem knihovny na něm
Kam fragment v uloženém content.xml dopadne?
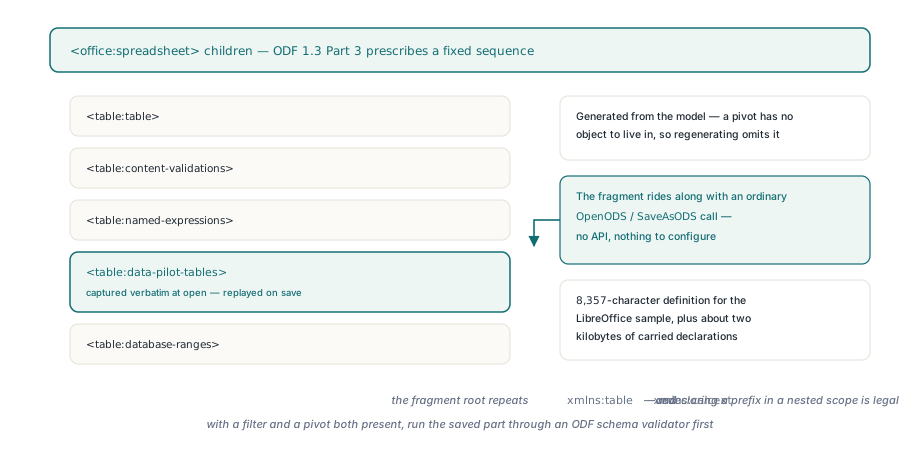
HotXLS zapisuje zachycený fragment do <office:spreadsheet> hned za jím generovaným <table:named-expressions> a před <table:database-ranges>. Content model <office:spreadsheet> z ODF 1.3 Part 3 předepisuje pro ty závěrečné potomky pevné pořadí, takže doslovný blok nelze prostě přilepit tam, kde se zapisovač zrovna nachází; musí dopadnout do konkrétního slotu. Ze strany volajícího neexistuje žádné API a není co konfigurovat; definice putuje spolu s obyčejným otevřením a uložením:
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.OpenODS('official-pivot.ods') <> 1 then
      raise Exception.Create('open failed');
    Book.Sheets[0].Cells[2, 5].Value := 1250.0;   // editace uvnitř zdrojového rozsahu pivotu
    Book.SaveAsODS('official-pivot-out.ods');
    // content.xml ve výstupu stále nese DataPilot1 se svým
    // zdrojovým rozsahem, poli, cílovým rozsahem, buttons a atributy loext:/calcext:
  finally
    Book.Free;
  end;
end;
Redundance je záměrná a stojí za to o ní vědět. Kořen fragmentu teď opakuje xmlns:table a xmlns:calcext, i když je kořen uloženého dokumentu taky deklaruje; Namespaces in XML dovoluje znovu deklarovat prefix ve vnořeném scope, takže duplikáty jsou neškodné. U ukázky LibreOffice je přenášená sada všech pětatřicet kořenových deklarací, zhruba dva kilobajty navíc na 8357znakové definici, protože zachycení neanalyzuje, které prefixy podstrom doopravdy používá. Sken použitých prefixů by to zkrátil a může přijít později; nejdřív správnost, pak úspornost
Pravidlo pro vystřihování podstromů z XML k doslovnému přehrání
Obecné poučení zní, že podstrom je sám o sobě úplný, až když to zařídíte, a namespace scope je první věc, která se rozbije, když na to zapomenete. Checklist, který HotXLS teď aplikuje na jakékoli zachycení ve stylu „nech si, co nemodeluješ":
- Procházejte dokument skutečným readerem a sledujte vazby ve scope. Řetězcové hledání přes
Posscope nevidí vůbec a navíc sedne na vnořené elementy stejného jména, na odpovídající řetězec uvnitř komentáře nebo sekceCDATAa na hodnoty atributů, které náhodou obsahují text tagu - Zkopírujte účinné vazby na kořen fragmentu, od nejvnitřnější, jednou na prefix, s vynecháním toho, co kořen už deklaruje
- Držte v emitovaných tagech syrové hláskování prefixu; cíl párujte podle rozřešeného namespace, ne podle literálního prefixu
- Zachovávejte textové uzly s bílými znaky a pamatujte, že prázdný element zavírá vlastní scope bez události end tagu
- Validujte uložený part parserem, který není testovaná knihovna. Knihovna si s potěšením znovu přečte vlastní výstup touž shovívavou cestou, která ho napsala
Ten poslední bod je ten, který HXLS-003 podruhé doopravdy našel. Přijímací kontrola v2.382.0 byla regulární výraz počítající start tagy data-pilot-table v uloženém content.xml a regulární výraz vidí tag, ne dokument — je slepý k tomu, zda jsou prefixy na tom tagu vázané. Přísný korpusový běhač přidaný ve v2.382.1 parsuje každý XML a .rels part uloženého balíčku parserem vnímajícím namespace a pak porovnává pivot strom — tag, seřazené atributy, text, potomky, rekurzivně — s originálem. To porovnání je namespace-expandované, takže přepsání prefixu by pořád prošlo a nevázaný prefix nemůže
Kde doslovná záruka končí
Doslovné přehrání definici uchovává; nerozumí jí, a hranice z toho plynou. HotXLS nevystavuje žádné API pro čtení, editaci nebo refresh ODS pivotu, takže FRawOdsDataPilotTablesXml je interní pole a jediné pozorovatelné chování je, že definice přežije. Fragment se znovu serializuje z událostí readeru, ne kopíruje jako bajty: uvozování atributů a samouzavírací tvary se normalizují, text a bílé znaky se drží. Zachycené XML emituje jen zapisovač obsahu ODS, takže sešit otevřený z .ods a uložený jako .xlsx o pivot přijde a sešit otevřený z .xlsx nemá co přehrát do uložení .ods — asymetrie importní a exportní cesty ODS platí tady jako všude. A protože je definice neprůhledná, nemůže následovat vaše editace: přejmenujte Sheet1 nebo pohněte se zdrojovými daty v HotXLsu a uložený pivot pořád míří na Sheet1.A2:E30, přičemž na konzumentovi je, aby nahlásil rozbitý rozsah, až si příště refreshne. Jedna poznámka k pořadí sem taky patří: HotXLS emituje rozsahy AutoFilter jako <table:database-ranges> za fragmentem pivotu a korpusová ukázka nenese žádný database range, takže sešit s filtrem i pivotem zároveň byste měli pustit validátorem ODF schématu, než se spolehnete na vzájemné pořadí těch dvou elementů
Testujte na souborech vlastního producenta, ne jen na korpusové ukázce. Přenos namespace zvládne jakýkoli prefix, který producent deklaruje na předkovi, ale dokument, který deklaruje prefix přímo na elementu pivotu, nebo který pro tabulkový slovník používá default namespace, prověří větve přeskočení a stínování, které ukázka LibreOffice ne. Obě jsou implementované; ukázka v korpusu pro ně ještě není a právě tenhle rozdíl changelog záznam rád rozmazá
Doslovné zachycení data pilotů ve v2.382.0 a oprava namespace scope ve v2.382.1 dodává současný HotXLS Delphi Excel Component, jehož produktová stránka uvádí kompletní pokrytí čtení a zápisu ODS, XLSX a XLS pro Delphi a C++Builder