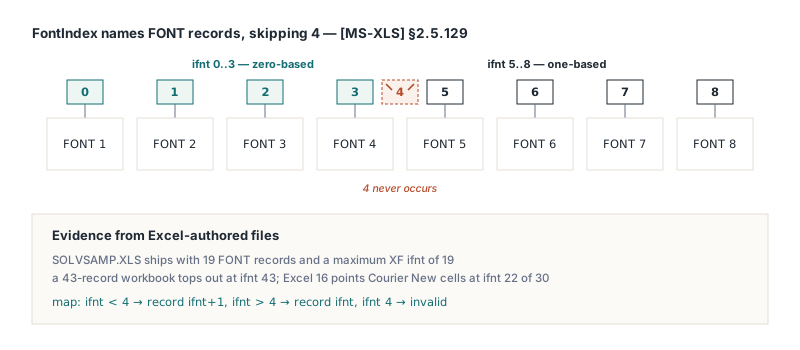
HotXLS čísluje každou referenci na písmo v BIFF8 tak, jak ji definuje [MS-XLS] §2.5.129 FontIndex: hodnoty 0 až 3 jsou indexované od nuly, hodnoty nad 4 indexované od jedničky a 4 se nikdy neobjeví, takže pátý záznam FONT je ifnt 5 a největší validní ifnt se rovná počtu záznamů FONT. Od HotXLS 2.384.4 toto pravidlo dodržuje XF writer, XF reader, rich text runy stringů i migrace runů mezi sešity a 2.384.5 s 2.384.6 ho rozšiřují na runy komentářů a textových boxů, včetně kopírování a vkládání řádků
Pravidlo vypadá jako překlep, dokud do něj nenarazíte. Někdo otevře sešit s osmi záznamy FONT, najde XF ukazující na písmo 8 a usoudí, že writer vyprodukoval index mimo rozsah. Přesně takhle uvažovala oprava ve HotXLS 2.384.1 a z korektní implementace udělala takovou, ve které každé vlastní písmo v souboru otevřeném v Excelu dopadlo o slot dřív. Zajímavý není sám off-by-one, ale to, kolik míst v knihovně pro BIFF8 nese stejnou konvenci, a to, že vazba na písmo může jedno uložení přežít a rozbít se při druhém. Pokud jste už bojovali se zvláštnostmi délky a kódování popsanými v Dekódování XLUnicodeString BIFF8 v Delphi: cch a fHigh, je to stejná rodina bugů: soubor je v pořádku, aritmetika není
Co pravidlo FontIndex z [MS-XLS] doopravdy říká?
[MS-XLS] §2.5.129 říká, že FontIndex pod 4 je pozice záznamu počítaná od nuly, FontIndex nad 4 je pozice počítaná od jedničky a hodnota 4 se NESMÍ používat. Stejný typ FontIndex používají záznamy XF, formátovací runy SST i formátovací runy TXO, takže jedno špatně přečtené pravidlo poškodí všechny tři. Důkaz se snadno zreprodukuje se soubory od Excelu: SOLVSAMP.XLS dodávaný s Office má 19 záznamů FONT a maximální XF ifnt 19, sešit se 43 záznamy končí na 43 a soubor uložený Excelem 16 se 30 záznamy FONT ukazuje buňky s Courier New na ifnt 22, tedy dvacátý druhý záznam. V žádném z nich se 4 nikdy neobjeví. Pokud potřebujete analyzovat mapování sami v diagnostickém nástroji, konverze jsou dvě krátké funkce
// [MS-XLS] 2.5.129 FontIndex: 0..3 od nuly, > 4 od jedničky, 4 neplatná
function FontIndexToRecordNo(Ifnt: Word): Integer;  // záznam FONT počítaný od 1
begin
  if Ifnt < 4 then
    Result := Ifnt + 1
  else if Ifnt > 4 then
    Result := Ifnt
  else
    Result := -1;  // 4 nesmí nastat
end;

function RecordNoToFontIndex(RecordNo: Integer): Word;
begin
  if RecordNo <= 4 then
    Result := RecordNo - 1
  else
    Result := RecordNo;
end;
Uvnitř HotXLS žije totéž pravidlo na dvou zrcadlových místech. TXLSFontList.GetSaveIndex vezme pozici písma v odkazovaném seznamu počítanou od 1 a dekrementuje jen pozice 1 až 4, takže pozice 5 se zapisuje jako ifnt 5. TXLSReader.ParseXF dělá při načtení opak: jakýkoli ifnt 5 a víc se dekrementuje na slot seznamu písem počítaný od nuly a cokoli pod tím zůstává. Remap rich runů SST a CountRichRunFontRefs aplikují stejnou konverzi ifnt >= 5 — a přesně o to jde: jedna konvence, každý konzument
// TXLSFontList.GetSaveIndex (strana writeru)
Result := inherited GetSaveIndex(Index);   // odkazovaná pozice od 1
if (Result > 0) and (Result < 5) then
  Dec(Result);                             // 1..4 se stanou 0..3, 5+ beze změny

// TXLSReader.ParseXF (strana readeru)
fnti := Data.GetWord(0);
if fnti >= 5 then
  Dec(fnti);                               // ifnt 5 je slot 4 v seznamu písem
Proč zero-based „oprava" posunula každé vlastní písmo o jedničku?
Zero-based přepis v HotXLS 2.384.1 posunul každé vlastní písmo, protože četl index počítaný od jedničky jako index od nuly a pak přiohlásil čtyři místa volání, aby odpovídala tomuhle čtení: GetSaveIndex, ParseXF, remap runů SST a migraci runů mezi sešity v Sheets.AddCopy. Round trip uvnitř HotXLS pořád vypadal dobře, protože se writer a reader shodovali navzájem. Excel nesouhlasil. Soubor zapsaný verzí 2.384.1 postavil první vlastní písmo na ifnt 4, což Excel bere jako defaultní písmo, a každé pozdější vlastní písmo o záznam dřív; otevírání souboru od Excelu jelo opačným směrem a vázalo každé písmo o záznam později
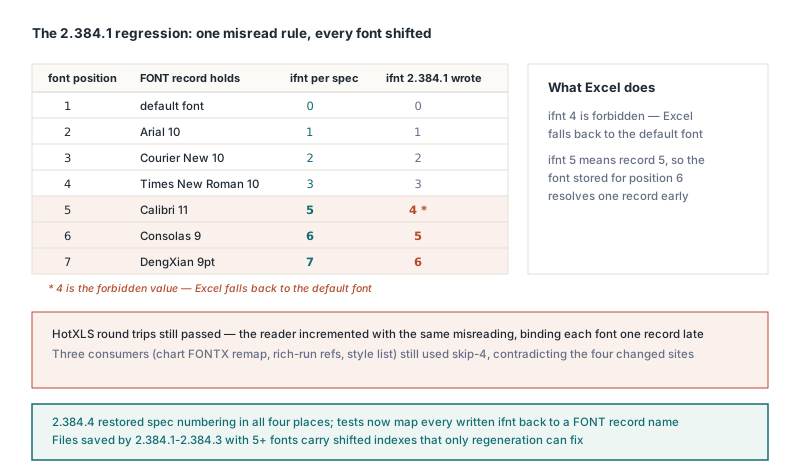
Stopa, která měla změnu zastavit, ležela ve stejném kódu. CountRichRunFontRefs, remap FONTX a FBI u grafů a seznam písem ve style engine nebyly nikdy sahnuty a pořád používaly skip-4, takže si knihovna protiřečela v okamžiku, kdy 2.384.1 vyjela, a kontradikci udržovala v tajnosti jen shoda okolností, že písma rich textu bývala obvykle odkazovaná i nějakým XF. Když se jedna konvence objevuje na sedmi místech a měníte čtyři, podezřívejte svou změnu dřív než zbylé tři. Verze 2.384.4 obnovila číslování podle specifikace na všech čtyřech místech a starý regresní test, který assertoval ifnt < FontCount a tedy zakódoval špatné čtení, nahradily testy mapující každý zapsaný ifnt zpět na jméno záznamu FONT přes vzorec ze specifikace. Jedna upřímná mezera zůstává: soubory uložené verzemi 2.384.1 až 2.384.3 s pěti a více písmy nesou posunuté indexy, které reader neodliší od validních dat, takže jediným lékem je jejich regenerace
Proč se runy písem komentářů lámou až při druhém uložení?
Runy komentářů a textových boxů se lámaly při druhém uložení, protože HotXLS držel prvních N-1 záznamů FONT bezpodmínečně a zahazoval jen poslední, pokud na něj neodkazoval žádný XF, zatímco formátovací runy TXO ([MS-XLS] §2.4.329) se zapisovaly zpět bajt po bajtu bez přečíslování. Soubory .xls od Excelu končí vždy neodkazovaným závěrečným písmem (9pt DengXian na systému s čínským locale), takže při prvním uložení nebylo písmo používané jen runem komentáře nikdy poslední a nic se viditelně nepohnulo. To první uložení ale závěrečné písmo upustilo a povýšilo písmo jen pro komentář na poslední pozici. Druhé uložení ho pak zahodilo jako neodkazované, ifnt runu ukazoval za konec a Excel spadl zpátky na defaultní písmo; pokud si sešit mezitím připsal nové písmo, run se potichu svázal s ním, což při testování změnilo stylizovaný run textového boxu na Arial. Soubory plné komentářů, jako ty popsané v Komentáře buněk a odkazy v Excelu v Delphi s HotXLS, jsou přesně místa, kde tohle kouše, protože se pořád otevírají, komentují a ukládají
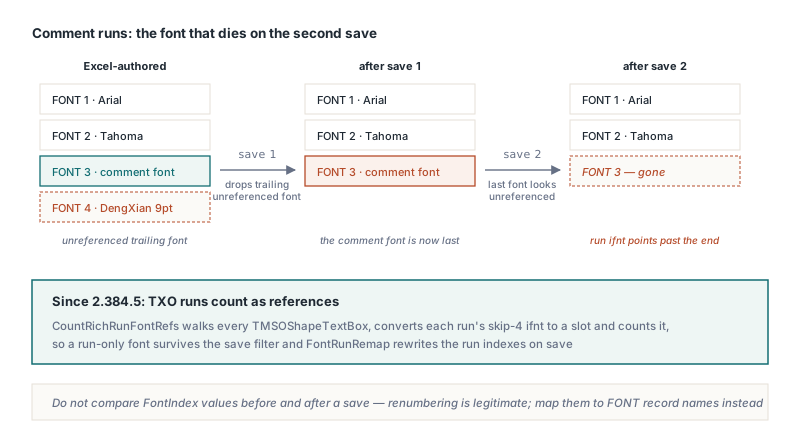
HotXLS 2.384.5 bere runy TXO jako runy SST. CountRichRunFontRefs teď projde každý TMSOShapeTextBox na každém listu, zkonvertuje skip-4 ifnt každého runu na slot a započítá ho jako referenci, takže písmo používané jen runem přežije save filtr. Výslednou tabulku slotů na save index dostane každý drawing do svého FontRunRemap a TMSOShapeTextBox.Store přepíše indexy runů na privátní kopii surových bajtů runů, přičemž závěrečnému TxOLastRun nechá pokoj, protože žádné písmo nenese. Pro aplikační kód je kontrakt prostý: TXLSComment.TextRuns.FontIndex a TXLSTextBox.TextRuns.FontIndex používají číslování souboru s vynechanou 4, přesně jak přišlo z readu; indexy runů se počítají od 1 a CharIndex je znakový offset, kde run začíná. Po uložení se uložené číslo může lišit od toho, které jste nastavili, ale ukazuje pořád na totéž písmo
var
  Book: IXLSWorkbook;
  Note: TXLSComment;
  I: Integer;
  Ifnt: Word;
begin
  Book := TXLSWorkbook.Create;
  if Book.Open('review-notes.xls') <> 1 then
    raise Exception.Create('Cannot open review-notes.xls');
  Note := Book.Sheets[1].Range['C2', 'C2'].Comment;
  if Note <> nil then
    for I := 1 to Note.TextRuns.Count do
    begin
      Ifnt := Note.TextRuns.FontIndex[I];   // číslování souboru, 4 vynecháno
      if Ifnt = 4 then
        raise Exception.CreateFmt('Run %d uses invalid ifnt 4', [I]);
      Writeln(Format('run %d at char %d: ifnt %d = FONT record #%d',
        [I, Note.TextRuns.CharIndex[I], Ifnt, FontIndexToRecordNo(Ifnt)]));
    end;
end;
Kopie, vkládání řádků a migrace runů mezi sešity
Od HotXLS 2.384.6 zachovává každá copy cesta classic engine formátovací runy komentářů, protože Range.Copy, CopyRange, Sheets.AddCopy i posuny buněk za Range.Insert a Range.Delete jdou přes TXLSRange.CopyCell a CopyCell kopíroval dřív jen text komentáře a autora. Posun je kopie plus vymazání, takže vložení jediného řádku nad poznámkou se dvěma runy ho nechalo s nulou runů a jedním písmem. Oprava kopíruje každý run a stěhuje jeho písmo přes TXLSWorkbook.MigrateRunFontIndex, které zkonvertuje skip-4 index na slot, přestěhuje písmo po hodnotě do cílové tabulky písem a zkonvertuje zpět na číslování souboru; migrace rich textu SST v Sheets.AddCopy teď volá tutéž funkci místo to, aby vozila vlastní kopii aritmetiky. Přibyly dva edge cases: in-place paste, kde zdroj a cíl je tentýž komentář, nesmí vymazat runy dřív, než je přečte, a Sheets.AddCopy dělá druhé kolo i pro komentáře připojené k buňkám bez uloženého záznamu buňky, které dřív přeskočil úplně. Strana tabulky písem u kopírování mezi sešity následuje tutéž logiku po hodnotě jako strana vzorců popsaná v Kopírování mezi sešity a přepojení vzorců v HotXLS pro Delphi. Na XLSX engine klonovaly copy cesty runy po hodnotě už dřív; díra byla přímo v části komentářů, kde reader ignoroval rFont, strike, u a vertAlign a writer nikdy nevypustil u ani vertAlign, takže runy teď přežívají uložení a znovuotevření symetricky
Jak testovat font indexy v souborech BIFF8?
Testujte font indexy uložením a znovuotevřením, ideálně přes víc než jednu generaci, a mapováním každého ifnt zpět na záznam FONT místo assertování číselného rozsahu. Každý bug v tomhle příběhu prošel in-memory testem: regrese 2.384.1 bydlela ve spárovaném páru writeru a readeru, drift TXO potřeboval dvě uložení se změnou tabulky písem mezi nimi a ztracené runy komentářů na XLSX se ukázaly až po znovuotevření. Užitečný harness otevře vzorek od Excelu, uloží ho dvakrát přes HotXLS, mezi uloženími přidá nebo odebere písmo a pak zkontroluje pozice runů a na úrovni bajtů jména písem za každým ifnt. Neporovnávejte hodnoty FontIndex před a po uložení, protože přečíslování je legitimní
procedure CheckNoteSurvivesShiftAndSave(const SrcFile, OutFile: string);
var
  Book: IXLSWorkbook;
  Note: TXLSComment;
  RunCount: Integer;
  SecondRunAt: Word;
begin
  Book := TXLSWorkbook.Create;
  Assert(Book.Open(SrcFile) = 1);          // od Excelu, C2 má dva runy
  Note := Book.Sheets[1].Range['C2', 'C2'].Comment;
  RunCount := Note.TextRuns.Count;
  SecondRunAt := Note.TextRuns.CharIndex[2];

  Book.Sheets[1].Range['C2', 'C2'].Copy(Book.Sheets[1].Range['E5', 'E5']);
  Book.Sheets[1].Range['C1', 'C1'].Insert(xlShiftDown);   // C2 se přesune na C3
  Assert(Book.SaveAs(OutFile) = 1);

  Book := TXLSWorkbook.Create;               // znovuotevření, paměti nevěřte
  Assert(Book.Open(OutFile) = 1);
  Note := Book.Sheets[1].Range['C3', 'C3'].Comment;
  Assert((Note <> nil) and (Note.TextRuns.Count = RunCount));
  Assert(Note.TextRuns.CharIndex[2] = SecondRunAt);
  Note := Book.Sheets[1].Range['E5', 'E5'].Comment;
  Assert((Note <> nil) and (Note.TextRuns.Count = RunCount));
end;
Pokud čtete a zapisujete classic XLS z Delphi nebo C++Builderu a nechcete dohánět, který z mnoha konzumentů písem v knihovně zrovna souhlasí s [MS-XLS] §2.5.129, skip-4 číslování, přečíslování runů při uložení a migrace runů po hodnotě popsané tady jsou zabudované v komponentě HotXLS pro Excel v Delphi, která čte a zapisuje XLS a XLSX bez Excelu a OLE automation