Když PDF font nevkládá, vykreslí komponenta HotPDF tenhle text nainstalovaným Windows fontem vybraným přes HPDFMapBaseFontToSystem: dekóduje název /BaseFont, ořeže style část, zkouší několik hláskování, dokud GDI nepotvrdí, že rodina je nainstalovaná, měří chybějící šířky standard 14 z metricky kompatibilních fontů a před kreslením převede jednobajtové kódy na Unicode. Každý z těch kroků existuje proto, že naivní verze na reálných souborech selhávala. Page renderer RenderLoadedPageToBitmap si s vloženými programy poradí dobře; tohle je příběh fontů, které v souboru nejsou vůbec
Proč GDI potichu kreslí špatný řez pro nevložený font?
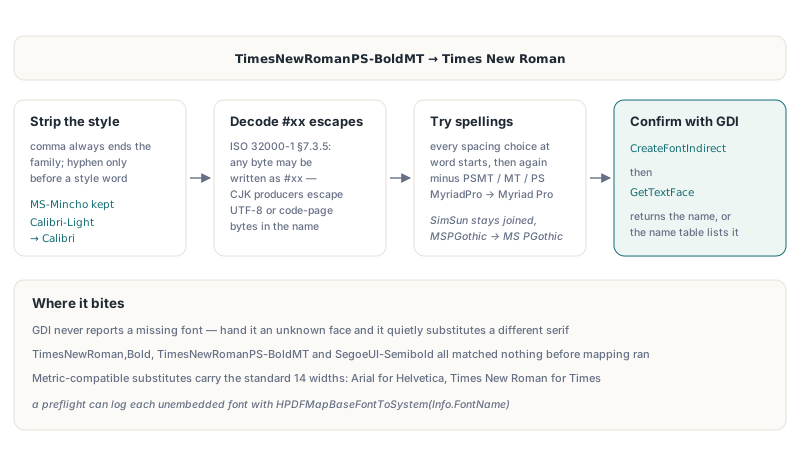
GDI nikdy nehlásí chybějící font: podstrčíte CreateFontIndirect název řezu, který nezná, a potichu vybere náhradu, často jiný serif bez bold váhy. Raný renderer předával PDF název téměř verbatim, takže TimesNewRoman,Bold, TimesNewRomanPS-BoldMT i SegoeUI-Semibold se netrefily do ničeho a vyšly v tom, co si GDI vybral. Názvy můžou být horší. ISO 32000-1 §7.3.5 dovolí názvu zapsat libovolný bajt jako #xx a CJK producery hláskují názvy fontů pravidelně jako escapované UTF-8 nebo bajty zastaralé kódové stránky; před v2.766.69 se samotné escape sekvence staly názvem řezu. HPDFMapBaseFontToSystem teď dekóduje nejdřív escape sekvence, vrací validní UTF-8 bajtovou sekvenci jako své znaky a ostatní vysoké bajty čte v systémové kódové stránce
Odříznutí stylu je místo, kde hryzkou heuristiky. Čárka vždycky rodinu ukončí (Arial,Bold dá Arial), ale spojovník jen tehdy, když slovo za ním je styl: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra nebo Condensed. Tahle pravidla nechají MS-Mincho v celku a z Calibri-Light udělají Calibri. HotPDF pak zkouší hláskování rodiny, následované hláskováními rodiny s odebranou příponou PSMT, MT či PS. Od v2.768.18 tato hláskování pokrývají každou volbu mezer na místech, kde může začít slovo: před verzálkou, za kterou je minuskulní písmeno (MyriadPro se stane Myriad Pro), na poslední verzálce běhu, po které následuje minuskulní písmeno (UIGothic), a za úvodním MS (MSPGothic), od plně rozestoupané podoby po název, jak je napsaný; za víc než čtyřmi takovými místy se zkouší jen plně rozestoupaná a slepená podoba. Mezery se nedají nasadit naslepo, protože Windows některá slova drží slepená: SimSun je nainstalovaný přesně pod tímto hláskováním, zatímco MicrosoftYaHei, MicrosoftJhengHei a MSPGothic patří k Microsoft YaHei, Microsoft JhengHei a MS PGothic. Před v2.768.18 dával mapper mezeru před každou vnitřní verzálku, takže MicrosoftYaHei se hledalo jako Microsoft Ya Hei a nikdy se nenašlo. Kandidát se počítá jako nainstalovaný, když CreateFontIndirect následované GetTextFace vrátí požadovaný název, nebo — od v2.768.18 — když tabulka name vybraného fontu uvádí jako rodinu, plnou či typografickou, v jakémkoli jazyce; odpověď se cachuje podle názvu, takže dokumenty s mnoha nenainstalovanými fonty už Windows neprobírají znovu pro každý název na každé stránce
Protože je mapovací funkce veřejná v unitu HPDFRenderFontMetrics, může preflight report ukázat, s jakou nainstalovanou rodinou se každý nevložený font vykreslí, pomocí výčtu fontů, který už THotPDF vystavuje pro načtené dokumenty:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Jak HotPDF měří fonty standard 14, které nemají /Widths?
HotPDF měří chybějící advancy na nainstalovaném fontu se stejnými metrikami, protože ISO 32000-1 §9.6.2.2 dovoluje fontům standard 14 vynechat /Widths a knihovna AFM tabulky nedoručuje. Arial nese metriky Helvetica, Times New Roman nese Times a Courier New nese Courier, takže HPDFMeasureBaseFontWidths vytvoří odpovídající řez na lfHeight = -1000 a zavolá GetCharWidth32W; v téhle výšce je výsledek už v jednotkách 1/1000 em, které PDF šířky používají. Renderer nejdřív převede každý kód na Unicode přes /Encoding, /BaseEncoding a /Differences, s defaultem StandardEncoding. SVG export a extrakce textu narazí na jednu past navíc: standardní Type 1 font bez jakéhokoli /Encoding vyrobil dekodér bez informace o kódování, SVG export si ho nikdy neregistroval a všechny naměřené šířky vyšly nazmar. Dodání implikovaného StandardEncoding to opravilo, pokud je označené jako předdefinované kódování; zavede-li se to do cesty CMap názvů, dekóduje se každý kód jako 0 a s ním řítí i každá šířka
Bold, italic a posun o jedničku v flagách deskriptoru fontu
Položka /Flags deskriptoru fontu čísluje své bity od 1, ne od 0, takže ForceBold je bit 19 ($40000) a Italic bit 7 ($40), podle ISO 32000-1, tabulka 123. Starý kód testoval $20000, což je bit 18, SmallCap. Chyba přežila od v2.345.0 do v2.766.53, protože /FontDescriptor je skoro vždy nepřímá reference a stavitel fontů četl jen přímé objekty, takže celá flags větev se nikdy nespustila a tutéž slepotu přehlížela /Widths 12 0 R a sazba textu vycházela na záložní advance 500 jednotek. Jakmile začalo v2.766.53 řešit nepřímé reference přes renderer, bit se musel opravit ve stejné změně, jinak by každý řez s small caps náhle vyšel bold:
const
  // ISO 32000-1 tabulka 123 čísluje pozice bitů od 1
  FD_ITALIC     = $00040;  // bit 7
  FD_SMALLCAP   = $20000;  // bit 18, ne váha
  FD_FORCEBOLD  = $40000;  // bit 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;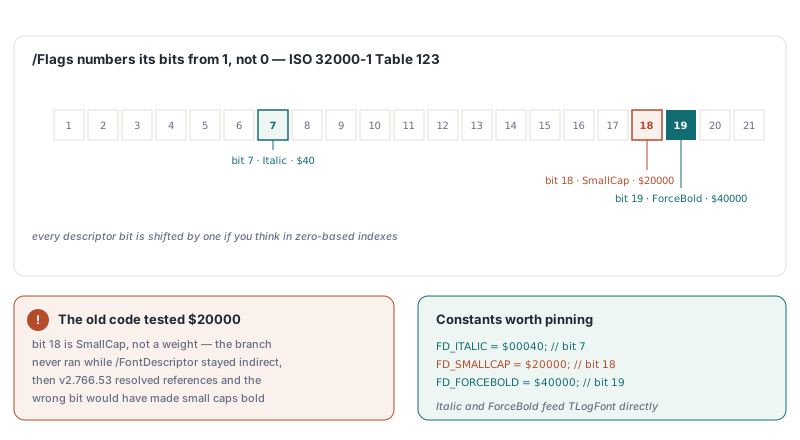
Proč dostávají CJK fonty s UCS2 CMap špatné šířky?
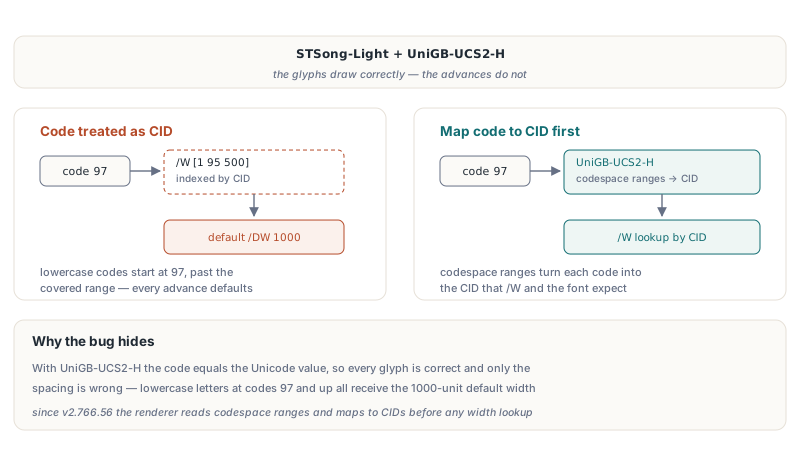
CJK text s předdefinovanou UCS2 CMap kreslí správné glyfy, ale špatné rozestupy, když renderer bere kód jako CID, protože /W je indexované podle CID, ne podle kódu znaku. Se STSong-Light a UniGB-UCS2-H se kód shodou okolností rovná Unicode hodnotě, takže GDI kreslí správné znaky a bug se schovává v advancech: minuskulní písmena dorazí jako kódy 97 a výš, minou položku /W jako [1 95 500] a všechny dostanou defaultní šířku /DW 1000. Od v2.766.56 čte renderer HotPDF kódy přes codespace rozsahy CMap (ISO 32000-1 §9.7.6.2) a mapuje je na CIDy, než začne hledat šířky. Používají se jen vestavěné tabulky UCS2 a UTF16 a vložené CMap streamy; identitní aproximace pro něco jako GBK-EUC-H by jen vypadala podporovaně a vyráběla špatný výstup, takže si renderer nic nepředstírá
Proč se znaky s diakritikou na čínském Windows mění v otazníky?
Jednobajtové kódy se nikdy nesmí dostat k ANSI („A“) funkcím GDI, protože GetGlyphOutlineA a GetGlyphIndicesA interpretují bajty v systémové kódové stránce, zatímco TextOutA používá znakovou sadu vybraného fontu. Na čínském systému se Arial bajt $A9 (znak copyrightu ve Windows-1252) stal GBK lead bajtem a vykreslil se jako „?“ — past, do níž rovnou vběhla cesta nehintovaných obrysů přidaná ve v2.766.83. v2.767.3 se zeptá realizovaného fontu na jeho znakovou sadu přes GetTextCharset, převede ji přes TranslateCharsetInfo na kódovou stránku, pustí bajt přes MultiByteToWideChar a volá W funkce; symbolové fonty místo toho použijí U+F000 plus kód. Kódování, která se neshodují s Windows-1252 — /Differences, StandardEncoding, MacRomanEncoding — se na Unicode mapují dřív, než je uvidí jakýkoli systémový font
Kde jsou meze kreslení systémovými fonty?
Vykreslování systémovými fonty je aproximace a komponenta HotPDF říká na rovinu, kde končí. Před v2.768.18 srovnávala instalační kontrola jen název, který vrátí GetTextFace, a na lokalizovaném Windows ta funkce hlásí název rodiny v systémovém jazyce, takže Microsoft YaHei na čínském Windows nebo Yu Mincho na japonském Windows se posoudilo jako chybějící a nakreslilo se v GDI náhradě; od v2.768.18 se řez, který se vrátí pod jiným názvem, hledá taky v tabulce name fontu a takové fonty se najdou. Metrická kompatibilita je garantovaná jen pro rodiny Helvetica, Times a Courier; Symbol se mapuje na Symbol a ZapfDingbats na Wingdings, což je záplatování, ne shoda. Preflight výše vidí taky jen fonty ve slovníku /Resources každé stránky, ne ty odkazované zevnitř form XObjects. Když se kód pořád nedá nakreslit, nahlásí ho tracking nevyřešených glyfů při kreslení, což je lepší signál než hledět na miniatury
Trvanlivá oprava sedí na straně tvorby. HotPDF samo píše s FontEmbedding defaultně True a dosazuje vložený Arial, i když kód zavolá SetFont s Helvetica, a vložený text jde přes renderer glyfů vložených fontů místo kteréhokoli z výše popsaných odhadů. Levná pojistka pro příchozí soubory je varovat před vykreslením, když mapovaná rodina není v seznamu screen fontů:
// VCL: Screen.Fonts vypisuje instalované názvy rodin (unit Forms)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
Kompletní komponentu, včetně vykreslování stránek, extrakce textu a subsettingu fontů na straně zápisu, najdete na stránce produktu HotPDF Delphi PDF component