Enkodér Reed-Solomon, který ukládá konstantní člen generátorového polynomu první a pak dělí vedoucím členem první, nepočítá opravu chyb vůbec. HotPDF přesně tohle dodal ve čtyřech 2D enkodérech barcode, QR, Data Matrix, PDF417 a Aztec, a každý symbol, který vyprodukovaly, nesl check blok, který žádný konformní scanner nedokázal použít
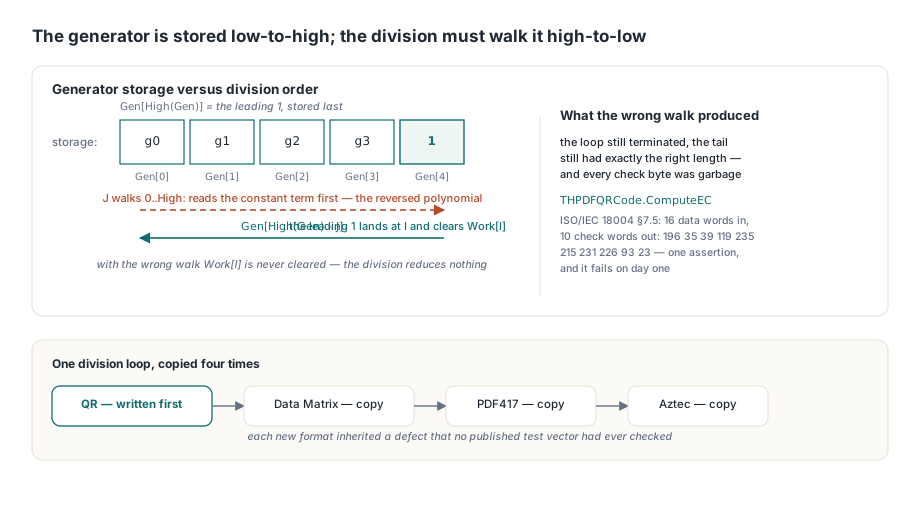
Zajímavá není aritmetická chybička. Je to šíření. Jeden enkodér byl napsán první, jeho dělící smyčka se zkopírovala do dalších tří a každý nový formát zdědil vadu, která nebyla nikdy ověřena proti jedinému publikovanému test vektoru. Symboly se pořád vykreslovaly, finder patterny seděly na správném místě, velikosti byly správné. Garbage byly jen ty bajty, které mají 2D barcode nechat přežít zašpinění
Jeden obrácený polynom, zkopírovaný do čtyř enkodérů
Kořenová příčina je nesoulad pořadí ukládání uvnitř smyčky syntetického dělení. Všechny čtyři enkodéry HotPDF staví generátorový polynom s koeficienty od nízkých k vysokým, takže Gen[0] drží konstantní člen a Gen[High(Gen)] monický vedoucí koeficient. Dělící smyčka indexovala Gen[J] dopředu při průchodu zprávou, což je aritmeticky totéž jako dělení obráceným polynomem. Byl tu i druhý důsledek, který první schoval: protože vedoucí koeficient nikdy nepřistál na pozici I, Work[I] se nikdy nevymazal, a dělení tak ve skutečnosti nic neredukovalo. Smyčka přesto skončila a přesto naplnila ocas polem přesně správné délky
// THPDFQRCode.ComputeEC v HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] je konstantní člen
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] je vedoucí 1, která maže Work[I]; chůze po Gen
  // dopředu místo toho dělí obráceným polynomem
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
Oprava je jediný indexový výraz Gen[High(Gen) - J]. Po něm THPDFQRCode.ComputeEC reprodukuje počítaný příklad z ISO/IEC 18004 §7.5: blok ve verzi 1-M byte-mode 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 dá deset check slov 196 35 39 119 235 215 231 226 93 23. To je jedna assertion a selhala by první den
Proč ztrácel payload i symbol Aztec?
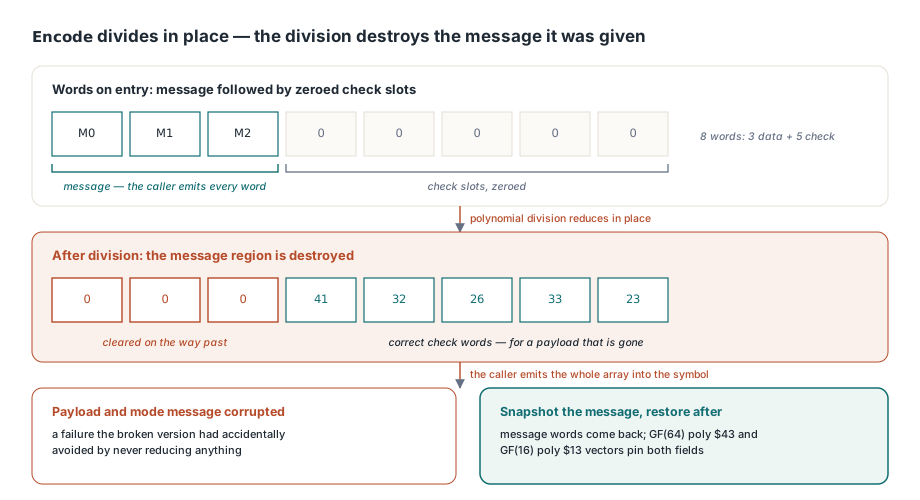
Aztec nesl těžší verzi téže chyby, protože TAztecGF.Encode dělí na místě. Rutina dostane Words se zprávou následovanou vynulovanými sloty check slov a volající emituje celé to pole do symbolu. Polynomiální dělení ničí dělence, jak ho redukuje, takže jakmile se smyčka opravila, aby skutečně redukovala, slova zprávy se cestou přepsala. Payload i mode message vyšly poškozené, selhání, kterému se rozbitá verze náhodou vyhnula tím, že nikdy nic neredukovala
// TAztecGF.Encode v HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// Dělení vymaže oblast zprávy, ale volající emituje celé
// pole do symbolu, takže data slova se musí vrátit
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
Aztec používá dvě různá tělesa a regresní fixture procvičuje obě. V GF(64), tělese šestibitového symbolu postaveném z primitivního polynomu $43, dají slova 12 45 3 s pěti check slovy 41 32 26 33 23, zatímco vedoucí tři zůstanou nedotčená. V GF(16), tělese mode message s primitivním polynomem $13, dají slova 5 9 hodnoty 11 15 6 8. Obě procházejí hookem HPDFAztecTestEncode proti ISO/IEC 24778
Proč potřebuje Data Matrix dvě opravy místo jedné?
THPDFDataMatrix.ComputeEC naskládalo na sdílenou chybu druhou, nezávislou: stavělo generátorový polynom s kořeny začínajícími na α^0, zatímco ISO/IEC 16022 Annex E specifikuje kořeny od α^1. Oprava jen indexu dělení dá pro standardní příklad check slova 146 107 90 179 128, která vypadají úplně stejně věrohodně jako ta správná a pořád jsou nečitelná. Než čísla sedla, musely pryč obě vady
// THPDFDataMatrix.ComputeEC v HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]: kořeny běží alpha^1..alpha^ECCount, ne od alpha^0
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
Referenční bod je dost malý, aby se vešel do komentáře. Řetězec '123456' se zakóduje na ASCII code slova 142 164 186, symbol 10x10 nese pět check slov a správný blok je 114 25 5 88 102. HPDFDataMatrixTestComputeEC vystavuje class funkci za bránou {$IFDEF HPDF_TESTING}, takže fixture asertuje těch pět hodnot bez instance enkodéru a bez vykreslení stránky. Samotné Galoisovo těleso, postavené funkcí InitDMTables nad primitivním polynomem $12D do tabulek DMExp a DMLog, bylo celou dobu správné, a přesně proto se chyba tak dobře schovávala
PDF417 dělí nad prvočíselným tělesem, kde záleží na znaménkách
PDF417 potřeboval čtyři změny místo jedné, protože GF(929) je prvočíselné těleso, ne binární rozšířené: sčítání není xor, odčítání není sčítání a znaménko každého faktoru generátoru je skutečná aritmetika, ne notace. Každý faktor musí být (x - 3^i), což v kódu znamená násobení číslem 929 - GF929Pow(3, I); redukční krok musí odčítat; kořeny běží od 3^1 podle ISO/IEC 15438 §5.5; a Factor se musí zachytit do lokální proměnné, než poběží vnitřní smyčka, protože průchod J = 0 zapisuje Work[I] a jinak by si změnil násobitel pod vlastníma nohama. HPDFPDF417TestComputeEC přibije opravený výsledek: code slova 5 453 178 121 239 se čtyřmi slovy opravy chyb dají 452 327 657 619
// THPDFPDF417.ComputeEC v HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // faktor je (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // latch: J = 0 přepisuje Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
Finder Data Matrix byl nainstalovaný naruby
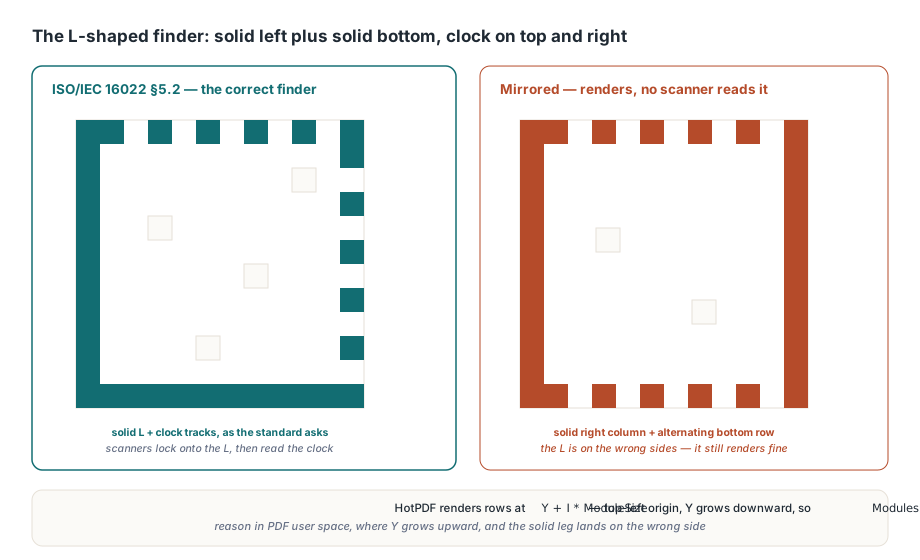
Správná check slova nezachrání symbol se zrcadleným finder patternem, a stejný release musel opravit i tohle. Kód umísťování kreslil plný levý sloupec, plný pravý sloupec a střídavé moduly podél horního a dolního řádku, zatímco ISO/IEC 16022 §5.2 chce plný levý sloupec plus plný dolní řádek, L-tvarovaný finder, se střídavou clock stopou podél horního řádku a pravého sloupce. To, co to tak snadno obrací naruby, je konvence souřadnic: HotPDF vykresluje řádky modulů na Y + I * ModuleSize, což je sémantika počátku vlevo nahoře, takže Modules[Size - 1, *] je dolní řádek vytištěného symbolu. Kdo uvažuje v PDF user space, kde Y roste nahoru, dá plnou nohu na špatnou stranu a na obrazovce nevidí nic podezřelého
Proč čtyři rozbité enkodéry roky procházely testy?
Protože testy asertovaly strukturu a vady byly v aritmetice. Stávající případy pro QR, Data Matrix a Aztec kontrolovaly finder moduly, timing patterny a rozměry symbolu, a všechno to bylo skutečně správné; žádný test nikdy neporovnal check slovo s publikovaným vektorem. Druhý důvod zobecňuje dál. HotPDF dodává vestavěný QR dekodér a použít ho k validaci enkodéru vypadá jako jasný round trip, jenže tento dekodér čte data code slova a nedělá žádnou korekci Reed-Solomon, takže přečetl přesně to, co enkodér zapsal, a ohlásil úspěch. Když enkodér a dekodér sdílejí předpoklad, round-trip test dokazuje, že se shodují, ne že má někdo z nich pravdu. Kód opravující chyby se musí validovat proti vektorům vytištěným ve standardu, nikdy ne proti vlastnímu dekodéru. Fixture THPDFBarcodeECCTests teď drží jeden test na formát, každý pojmenovaný podle toho, co přibíjí, a každý se k aritmetice dostane hookem kompilovaným jen pod {$IFDEF HPDF_TESTING}:
QRCheckWordsMatchISO18004Exampleasertuje deset check slov příkladu verze 1-M byte-modeDataMatrixCheckWordsMatchISO16022Exampleasertuje 114 25 5 88 102 pro code slova 142 164 186PDF417CheckWordsMatchGF929Referenceasertuje 452 327 657 619 nad GF(929) s kořeny 3^1 až 3^4AztecCheckWordsKeepMessageAndMatchReferenceasertuje check slova a to, že slova zprávy přežijí dělení na místě
Čtyři otázky chytí většinu této rodiny v každém enkodéru, který spravujete. Odpovídá pořadí ukládání vašeho generátoru pořadí indexů dělení, a umíte ukázat na řádek, který to dokazuje? Začínají kořeny tam, kde říká standard, α^1 pro Data Matrix a 3^1 pro PDF417? Obnovuje dělení na místě oblast zprávy? Porovnává aspoň jeden test check slova, ne počty modulů, s číslem vytištěným ve specifikaci? Důležitý je i rozsah, když se rozhodujete, co se stávajícími artefakty. Symboly vygenerované před v2.748.0 se vykreslují a v ideálních podmínkách se často načtou, protože čistý obrázek ke čtení nepotřebuje žádnou korekci; co ztratily, je tolerance poškození, kvůli které si tyhle formáty vůbec vybíráte. Dlouhověké štítky a archivované dokumenty s postiženými symboly stojí za to přegenerovat, ne jen namátkově zkontrolovat foťákem. Enkodéry žijí v podpoře barcode v HotPDF, vedle cesty QR dekódování a jejího zpracování orientace a vrstvy report výstupu, která umísťuje symboly na stránku; plný barcode API reference se dodává s HotPDF Delphi Component pro Delphi a C++Builder