Chyby kontroly rozsahu v PDF knihovnách pro Delphi si vysloužily pověst obtížně dohledatelných, protože nesledují žádný konzistentní vzor vstupu. Stejný dokument je na jednom počítači vyvolá a na jiném ne; stejná cesta kódu vyhodí výjimku u třístránkového souboru, ale u dvanáctistránkového proběhne čistě. Tato nekonzistence se téměř vždy dá vystopovat k jediné kořenové příčině: objekty stránek PDF nejsou uloženy v pořadí souboru. Pokud si knihovna sestavuje interní pole stránek sekvenčním procházením objektů místo průchodu stromem stránek deklarovaným v katalogu, vytvoří index, jehož platný rozsah neodpovídá tomu, co volající očekávají, a kontrola rozsahu tento nesoulad zachytí v tu nejhorší možnou chvíli
Jak funguje kontrola rozsahu v Delphi
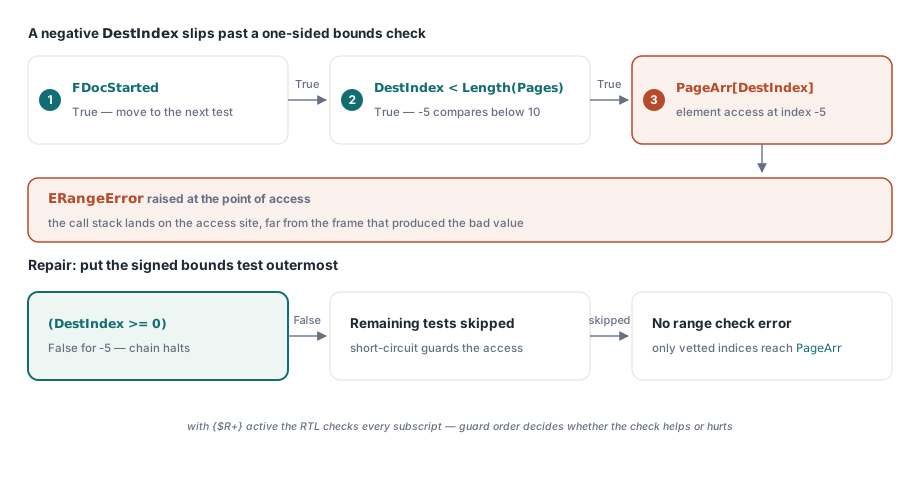
S aktivní direktivou kompilátoru {$R+} (výchozí v konfiguraci Debug) RTL Delphi za běhu ověřuje každý index pole, index do řetězce i přiřazení výčtového typu. Přístup mimo meze vyvolá ERangeError, místo aby tiše četl sousední paměť. Toto chování je cenné: odhaluje latentní chyby brzy, místo aby jim dovolilo poškodit datovou strukturu, která selže až o sto řádků dál. Frustrující je, že výjimka se vyhodí v místě přístupu, nikoli tam, kde byl index chybně vypočítán. Když zásobník volání ukazuje hluboko vnořenou metodu v PDF unitě, skutečná chyba je obvykle o několik rámců zpět
Složené booleovské podmínky to zhoršují. Delphi vyhodnocuje výrazy s and zleva doprava se zkrácenou sémantikou, ale zkrácení přeskočí vyhodnocení jen tehdy, když je levá strana False. Výraz jako:
if FDocStarted and (DestIndex < Length(PageArr)) and
   (PageArr[DestIndex].PageObj <> nil) then
vypadá bezpečně, ale proti indexu mimo rozsah chrání jen tehdy, když FDocStarted je True a DestIndex je nezáporný. Kontrola DestIndex < Length(PageArr) nedělá nic, když je DestIndex záporný, protože porovnání záporného celého čísla s nezápornou délkou vrátí ve znaménkové aritmetice True a následný přístup do pole stejně vyvolá chybu rozsahu. Správnou opravou je přesunout kontrolu mezí na nejvzdálenější vnější pozici:
if (DestIndex >= 0) and (DestIndex < Length(PageArr)) then
begin
  if FDocStarted and (PageArr[DestIndex].PageObj <> nil) then
    Result := PageArr[DestIndex].PageObj
  else
    Result := nil;
end
else
  raise ERangeError.CreateFmt(
    'Page index %d is out of range (0..%d)',
    [DestIndex, Length(PageArr) - 1]);
Toto je mechanická oprava. Zastaví pád. Nevysvětluje, proč DestIndex vůbec dostal hodnotu mimo platný rozsah
Skutečná příčina: pořadí objektů versus pořadí stránek
ISO 32000-1 §7.7.3 definuje strom stránek jako strom uzlů Pages, jejichž pole Kids uvádějí objekty stránek v pořadí zobrazení. Soubor tyto objekty ukládá na libovolných offsetech, které si zapisovač zrovna zvolil; objekt číslo 20 může v bajtovém proudu fyzicky předcházet objektu číslo 3. Knihovna, která sestavuje seznam stránek iterací tabulky křížových odkazů v pořadí čísel objektů místo sledování řetězce Kids, vytvoří posloupnost, která se rozchází s tím, co uživatel očekává. U dokumentů, kde generátor náhodou zapsal stránky v pořadí, všechno funguje. U dokumentů, kde ne, vytváří rozpor mezi číslováním stránek v knihovně a číslováním stránek u volajícího indexy, které padají mimo PageArr
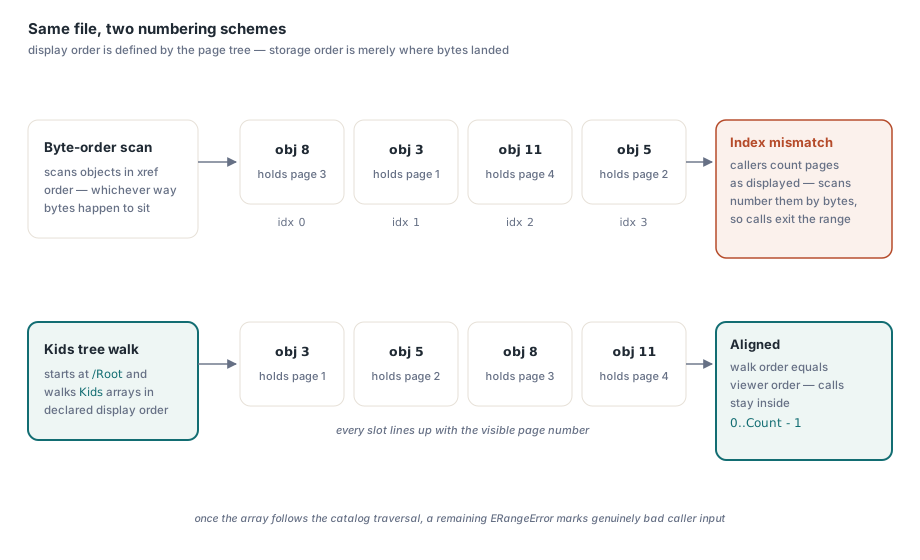
Správný přístup je začít od katalogu, vyhodnotit nepřímý odkaz /Pages a rekurzivně projít pole Kids. U plochého dokumentu bez mezilehlých uzlů Pages je průchod přímočarý:
procedure BuildPageIndexFromTree(
  const KidsArray: THPDFArray;
  var PageArr: TPageObjArray);
var
  i, Idx: Integer;
  Child: THPDFObject;
  ChildType: string;
begin
  for i := 0 to KidsArray.Count - 1 do
  begin
    Child := KidsArray.GetIndirectObject(i);
    if Child = nil then
      Continue;
    ChildType := Child.GetNameValue('/Type');
    if ChildType = 'Page' then
    begin
      Idx := Length(PageArr);
      SetLength(PageArr, Idx + 1);
      PageArr[Idx].PageObj := Child;
    end
    else if ChildType = 'Pages' then
    begin
      // mezilehlý uzel: rekurzivně projít jeho Kids
      BuildPageIndexFromTree(Child.GetArray('/Kids'), PageArr);
    end;
  end;
end;
Po jeho proběhnutí je PageArr[0] první stránkou, kterou by prohlížeč zobrazil, bez ohledu na to, kde daný objekt v bajtovém proudu leží. Indexy předávané volajícími, kteří předpokládají pořadí zobrazení, se nyní mapují správně a chyby rozsahu přestanou
Natvrdo zakódovaná obejití problém násobí
V kódových základnách, kde kořenová příčina nikdy nebyla identifikována, se běžně nacházejí heuristické záplaty: prohodit první a poslední stránku, když je celkový počet roven 3, otočit index u dokumentů od konkrétního generátoru, aplikovat posun, když číslo prvního objektu překročí práh. Každá z těchto záplat sedí přesně na sadu testovacích souborů, které byly po ruce v době jejího napsání. Přidejte jiný zdroj PDF a jedna ze záplat se spustí v nesprávnou chvíli a vytvoří index, který je nyní chybný dvojnásob: chybný proto, že byl vypočítán z pole v nesprávném pořadí, a znovu chybný proto, že navrch bylo aplikováno nepoužitelné mapování. Kontrola rozsahu to zachytí někde dál po proudu a trasování zásobníku neukazuje nikam užitečně
Jedinou produktivní cestou je odstranit každé heuristické mapování a nahradit sestavení pole stránek řádným průchodem stromem. Jakmile jsou indexy správné už z konstrukce, žádné záplaty nejsou potřeba a kontrola rozsahu se stává přínosem, nikoli překážkou
Pokud udržujete knihovnu, která tento vzor vykazuje, dočasně zapněte kontrolu rozsahu v sestavení Release a spusťte ji proti různorodému korpusu PDF: dokumentům vytvořeným Wordem, LaTeXem, firmwarem skenerů, utilitami pro rozdělování PDF na PDF. Soubory, které vyvolají výjimky, jsou ty, jejichž pořadí objektů stránek se rozchází s pořadím průchodu, které váš kód předpokládá. Každý z nich je datový bod, ne samostatná chyba
Pro nový kód, který volá PDF knihovnu pro Delphi, zní praktická rada: považujte počet stránek hlášený knihovnou za směrodatný a nikdy nepředávejte index odvozený aritmetikou z externích dat, aniž byste nejprve ověřili, že spadá do 0..PageCount - 1. Komponenta HotPDF pro Delphi zpřístupňuje vyhodnocený počet stránek přes THotPDF.PageCount po BeginDoc nebo po načtení dokumentu; tato hodnota vždy odráží průchod stromem stránek a lze ji bezpečně použít jako horní mez pro jakoukoli aritmetiku indexů