Slovník LZW enkodéru je vždy o jeden záznam napřed před dekodérem, který bude číst jeho výstup, takže obě strany nemohou sdílet jedinou prahovou hodnotu šířky kódu. PDFlibPas dává TPLLZWEncoder a TPDFLZWDecompressor oddělené prahové hodnoty odvozené ze stejného příznaku EarlyChange a ten náskok o jeden záznam je celý důvod, proč příznak vůbec existuje
Téměř každá ručně psaná implementace LZW to pokazí na stejném místě. Nejdřív napíšete dekodér, protože ten potřebujete k otevírání souborů. Funguje. Pak napíšete enkodér, zrcadlíte logiku dekodéru řádek po řádku, protože LZW je symetrické, spustíte round-trip test a projde. Vydáte to. Za šest měsíců zákazník otevře váš výstup v prohlížeči, který není váš, a od nějakého místa uprostřed streamu dál je to odpad. Zrcadlení byl ten bug: obě poloviny LZW nejsou symetrické a předstírat opak vyrábí streamy, které umí číst jen váš vlastní kód
Proč potřebuje enkodér jinou prahovou hodnotu než dekodér?
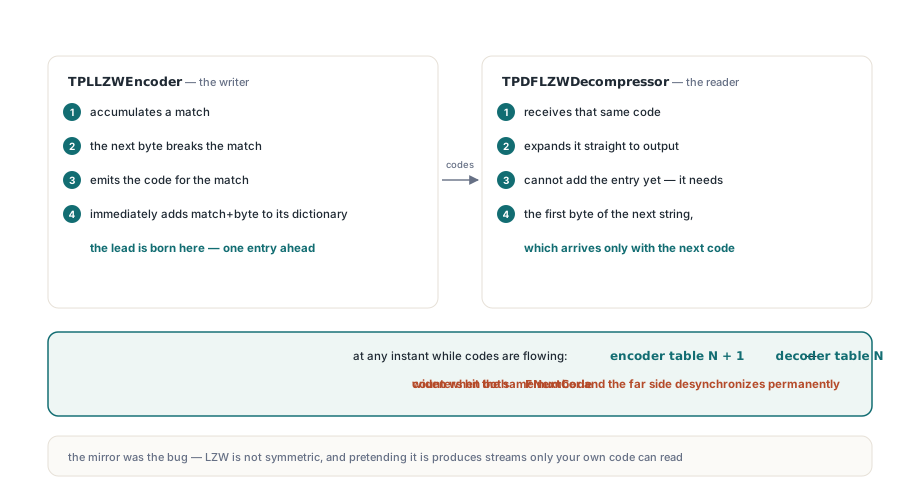
Protože enkodér se každý záznam slovníku naučí o krok dřív, než ho může dekodér. To není designová volba v PDFlibPas; je to vlastní tomu, jak LZW funguje, a každá správná implementace to musí někde kompenzovat. Projděte si smyčku a uvidíte, odkud náskok pochází. Enkodér hromadí shodu, zjistí, že ji další bajt láme, vyšle kód pro shodu a okamžitě přidá do svého slovníku shodu plus bajt. Dekodér přijme stejný kód a rozbalí ho, ale odpovídající záznam ještě přidat nemůže, protože nový záznam potřebuje první bajt dalšího řetězce, který dorazí až s dalším kódem. Takže v každém okamžiku, kdy tečou kódy, drží tabulka enkodéru o jeden záznam víc než tabulka dekodéru. Pokud obě strany rozšíří kód z 9 na 10 bitů, když jejich vlastní FNextCode narazí na stejné číslo, rozšíří se o jeden kód od sebe a bitová čtečka na druhé straně se trvale desynchronizuje. V TPDFLZWDecompressor.ResetDictionary se prahová hodnota dekodéru spočítá jednou a uloží do FChangeCode:
// TPDFLZWDecompressor.ResetDictionary: dekodérová strana prahové hodnoty
FCodeSize := FInitialCodeSize;                 // 9 pro PDF LZWDecode
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // rozšířit, když FNextCode dosáhne 511
else
  FChangeCode := FBitMask + 1;                 // rozšířit, když FNextCode dosáhne 512
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
Dekódovací smyčka rozšiřuje hned poté, co připojí záznam, testuje (FNextCode = FChangeCode) and (FCodeSize < 12) a pro novou šířku přepočítá jak FBitMask, tak FChangeCode. Devět bitů se přepne na 511 nebo 512, deset bitů na 1023 nebo 1024, jedenáct bitů na 2047 nebo 2048 a dvanáct bitů je strop, kde se slovník musí vyprázdnit ClearCode místo rozšiřování. Enkodér nemůže žádné z těchto čísel použít. Jeho GrowCodeSize přičítá jedničku, aby kompenzoval náskok, takže s nastaveným EarlyChange rozšiřuje na 512, zatímco dekodér na 511:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 při 9 bitech
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 při 9 bitech
  // Dekodér přidá svůj poslední čekající záznam, než přečte EOI.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;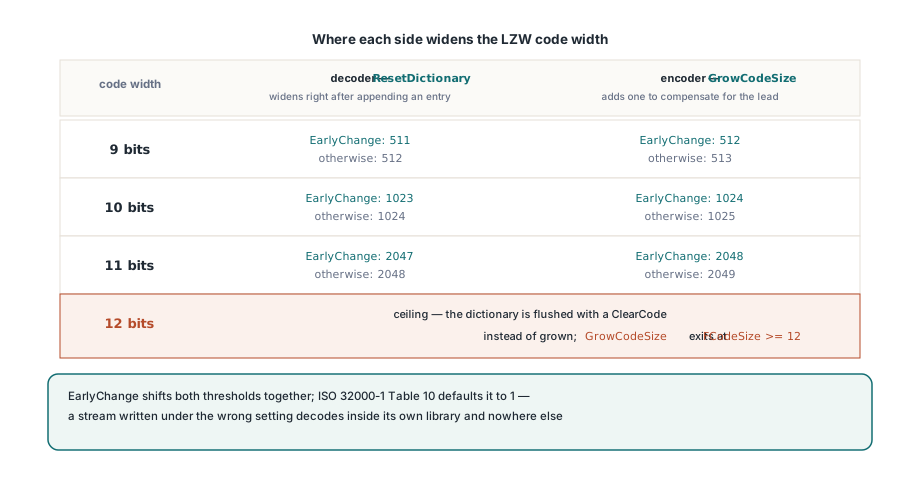
Na posledním datovém kódu se obě strany konečně potkají
Konec streamu je jediné místo, kde enkodér musí přestat vést a myslet jako dekodér, k čemuž slouží parametr FinalDataCode u GrowCodeSize. Vyšlete kód EOI na špatné šířce a všechno před ním je stále naprosto platné, takže se vada skrývá za tisíci správných bajtů. Sekvence vypadá takhle. Enkodér vyšle svůj poslední datový kód a na rozdíl od všech dřívějších iterací už po něm do svého slovníku nic nepřidává, protože nezbyl žádný další bajt, kterým by shodu rozšířil. Dekodér dělá opak: přijme tento poslední kód a teprve teď může dokončit záznam, který držel od předchozího. V posledním kroku se dekodér dotáhne, náskok se zhroutí na nulu a šířka, kterou použije ke čtení EOI, je určena záznamem, který enkodér nikdy nevytvořil. Dec(ChangeCode) je enkodér, který přesně na jedno volání předstírá, že je dekodérem:
// TPLLZWEncoder.Compress, konec streamu
EmitCode(CurCode);      // poslední datový kód, na aktuální šířce
GrowCodeSize(True);     // může rozšířit pomocí snížené prahové hodnoty
EmitCode(FEOICode);     // EOI na šířce, kterou dekodér skutečně přečte
FlushBits;
FlushOutput;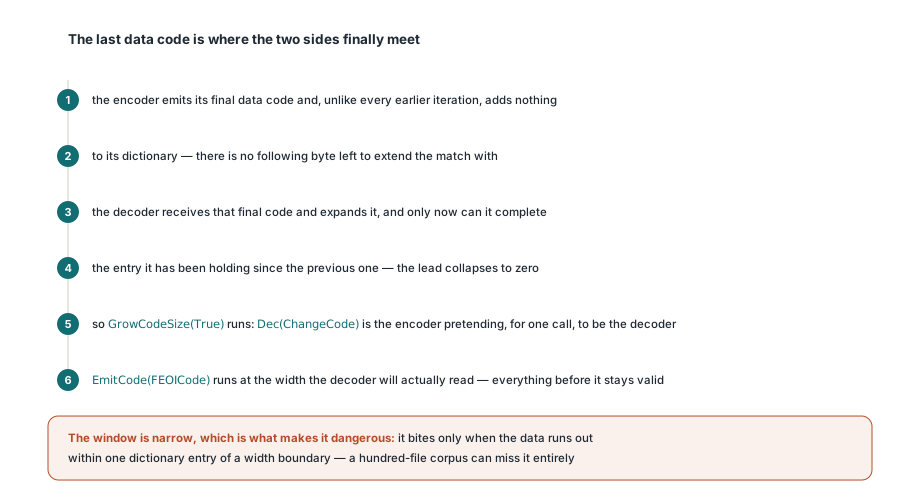
Okno, ve kterém na tom záleží, je úzké, a právě to ho dělá nebezpečným. Kouše jen když data náhodou dojdou do jednoho záznamu slovníku od hranice šířky, takže korpus sta testovacích souborů to může úplně minout, zatímco jeden zákaznický soubor na to narazí pokaždé. Hraniční případy v Compress je třeba řídit záměrně: připravte vstupy, jejichž slovník skončí na 510, 511 a 512 záznamech, a pak přečtěte šířku bitu vyslaného EOI ze streamu ručně, místo abyste ji odvozovali z úspěšného dekódování
Proč může prošlý round-trip test stále skrývat rozbitý stream?
Protože dvě implementace, které dělají stejnou chybu, si spolu rozumějí. Pokud váš enkodér i dekodér rozšiřují oba o jeden kód příliš brzy nebo oba o jeden kód příliš pozdě, zůstávají v kroku, round trip reprodukuje vstup bajt po bajtu a sada testů je zelená, zatímco stream, který jste vyrobili, neumí číst nic jiného. To je ta nejcennější věc, kterou si z celého cvičení odnést: u LZW nemá sebepřítomnost jako důkaz žádnou hodnotu. Takže vlastní round-trip nemůže být primárním testem a PDFlibPas validuje cestu LZW místo toho třemi jinými způsoby. Ručně postavené kódové streamy s očekávaným bitovým vzorem zapsaným ručně, takže tvrzení se týká bajtů, ne výsledku jejich dekódování. Obousměrná interoperabilita proti nezávislým implementacím, kdy se streamy vyrobené tímto enkodérem dekódují jinde a streamy vyrobené jinde dekóduje TPDFLZWDecompressor. A diferenciální dekódování, kdy se stejné bajty čtou dvakrát s EarlyChange nastaveným oběma směry, takže stream, který se pod špatným nastavením dekóduje čistě, vám řekne, že se hranice šířky nikdy netestovaly:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // záměrně špatné pravidlo pro PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A musí odpovídat zdroji; B odpovídat NESMÍ. Pokud B také odpovídá,
// byl vstup příliš krátký na překročení hranice šířky kódu.
Skutečné pokrytí dávají externí vstupy. Aktuální testovací materiál překračuje šířky 9, 10, 11 a 12 bitů a v jediném streamu vynutí 34 resetů slovníku, což je jediný realistický způsob, jak dokázat, že cesta ClearCode na stropu 4095 vůbec funguje. Pokud vaše fixture nikdy nepřesáhnou pár kilobajtů, žádný z toho kódu se nikdy nespustil. A když oprava změní to, co váš enkodér produkuje, berte starý výstup jako rozbitý, ne jako kompatibilní základ hodný zachování; stream, který špatně míchá šířky kódů, není legacy formát, je to bug, který se náhodou dostal na disk
PDF říká 1, TIFF říká záleží
PDFlibPas nastavuje EarlyChange na True u TPLLZWEncoder i TPDFLZWDecompressor, protože ISO 32000-1 Tabulka 10 definuje EarlyChange jako dekódovací parametr LZWDecode s výchozí hodnotou 1, což znamená, že délka kódu roste o jeden kód dřív. To je specifikováno v ISO 32000-1 sekci 7.4.4.2 vedle parametrů predictoru a PDF, které chce jiné chování, musí říct /EarlyChange 0 výslovně ve svém slovníku /DecodeParms. TIFF je důvod, proč je příznak vlastnost a ne konstanta: TIFF 6.0 sekce 13 popisuje kompresi LZW bez stejného jednoznačného tvrzení a enkodéry ve volné přírodě se na tom historicky rozcházejí, což je velmi pravděpodobně důvod, proč specifikace PDF vůbec cítila potřebu parametr pojmenovat. Na pipeline TIFF do PDF proto není nastavení něco, co byste mohli natvrdo zadrátovat na kterémkoli konci. Cokoli nakonec potřebovala strana TIFF, musí se výslovně přenést do PDF /DecodeParms, jinak převedete soubor, který se otevíral v pohodě, na soubor, který se neotevře. Stejná péče platí pro FillOrder, kde foTop a foBottom vybírají, ze kterého konce bajtu bitová čtečka plní, a pro horizontální rozdílování TIFF Predictor 2, které TPDFLZWParms nese přes Predictor, Colors, BitsPerComponent a Columns. Naše poznámky o zpevnění vestavěného TIFF dekodéru pro BigTIFF a dlaždicové rozvržení pokrývají zbytek té cesty
Dvě menší pasti, které stojí za pojmenování
Obě se snadno zapojí špatně, když máte objekty enkodéru a dekodéru otevřené vedle sebe a předpokládáte, že symetrie platí i tady:
InitialCodeSizeneznamená u obou tříd totéž.TPLLZWEncoder.InitialCodeSizeje šířka kořenového symbolu, validovaná na 2 až 8, přičemžInitDictionaryodvozujeFClearCodejako1 shl FInitialCodeSizea nastavujeFCodeSizenaFInitialCodeSize + 1.TPDFLZWDecompressor.InitialCodeSizeje první šířka kódu, validovaná na 2 až 9, přičemžResetDictionaryodvozujeFClearCodejako1 shl (FCodeSize - 1). Pro obyčejná 8bitová PDF data jsou výchozí hodnoty 8 a 9 a nikdy si toho nevšimnete; nastavíte-li obě ručně na stejné číslo, postavili jste neshodný pár- Dekódování nedůvěryhodného LZW je problém bezpečnosti paměti dřív, než je problémem správnosti, protože indexy slovníku přicházejí přímo ze souboru.
TPDFLZWDecompressorodmítá každý kód nad 4095 nebo na úrovniFNextCodea výš, odmítá přidávat záznamy přes 4095, kontroluje zbývající vstup v bitech před každýmGetNextCodea vystavujeSawExplicitEOI, aby volající rozeznal řádně ukončený stream od toho, kterému prostě došly bajty. Zkrácený stream není částečný úspěch. Širší přehled v zpevnění Pascal PDF parseru proti škodlivým souborům pokrývá třídu vad, které tyto zábrany uzavírají
Co si z toho odnesete
LZW vypadá symetricky a není. Slovník enkodéru vede o jeden záznam přes tělo streamu a na posledním kódu náskok mizí, takže správná implementace nese dvě prahové hodnoty plus jeden speciální případ a příznak EarlyChange posouvá obě prahové hodnoty společně. Posunete kteroukoli z nich o jediný kód a vyrobíte výstup, který je platný přesně do chvíle, kdy není, bez chyby a bez výjimky kdekoli, jen nějaký prohlížeč vykresluje šum. Upřímná hranice je, že nic z toho nelze testovat zevnitř: nic ve vaší vlastní sadě nedokáže rozlišit správný stream od trvale špatného, takže interoperabilní kontrola není volitelný bonusový průchod, je to jediný skutečný důkaz, který kdy dostanete. Obě třídy jsou součástí PDF Library for Delphi, která se stará i o okolní strukturální práci popsanou v našich poznámkách o object streamech a křížových referenčních streamech, pro Delphi a C++Builder napříč verzemi kompilátoru, které knihovna podporuje