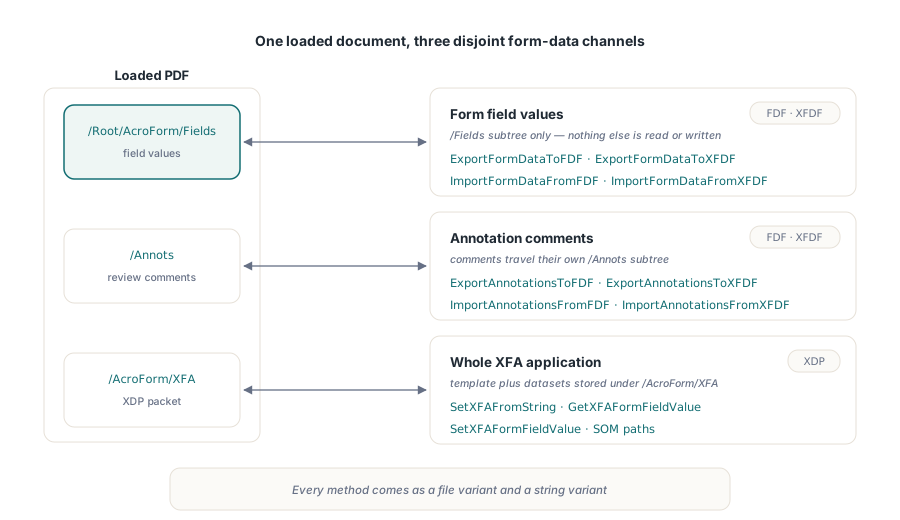
losLab PDF Library přenáší data formulářů do a z PDF třemi různými způsoby: FDF a XFDF pro hodnoty polí AcroForm, tytéž dva formáty pro komentáře anotací a celý balíček XFA XDP zapsaný přímo do formuláře. ExportFormDataToXFDF, ImportFormDataFromXFDF, ImportAnnotationsFromFDF, ExportAnnotationsToXFDF a SetXFAFromString představují vstupní body, přičemž každý z nich má variantu pro soubory a variantu pro řetězce
Důvodem pro existenci tolika metod je, že data formuláře PDF nejsou jednotná věc. Vyplněný AcroForm obsahuje hodnoty polí, může také nést komentáře k recenzi a starší XFA formulář vkládá celý XML popis aplikace, který nemá s žádným z předchozích nic společného. losLab PDF Library záměrně udržuje tyto tři záležitosti v oddělených API, protože jejich sloučení by si vynutilo nesprávný datový model u nejméně dvou z nich. Rozhodnutí, kterou rodinu metod potřebujete, je první designovou volbou a obvykle je vyřešeno ve chvíli, kdy zjistíte, co přijímací systém na druhé straně skutečně konzumuje
Jaký je rozdíl mezi daty formulářů FDF, XFDF a XFA?
FDF a XFDF přenášejí stejné informace ve dvou různých syntaxích a XFA je samostatný svět. FDF je miniaturní dokument v syntaxi PDF (ISO 32000-2 §12.7.8): pole /Fields se slovníky << /T (jméno) /V (hodnota) >>, kde jsou řetězce escapovány přesně tak, jak se escapují doslovné řetězce uvnitř PDF. XFDF is the XML form of the same data (ISO 19444), a <fields> tree that Acrobat and most form back ends read and write natively. XFA není ani jedno z toho: je to šablona XML Forms Architecture plus její data, uložená jako XML Data Package (XDP), na který PDF odkazuje z /AcroForm/XFA. Zvolte FDF nebo XFDF, pokud provádíte výměnu hodnot polí, a po XFA sáhněte pouze v případě, že udržujete dokument, který byl jako formulář XFA vytvořen od samého počátku
V rámci FDF a XFDF kreslí losLab PDF Library druhou dělicí čáru: hodnoty polí versus komentáře anotací. Rodina formulářových dat (ExportFormDataToFDF, ImportFormDataFromFDF, ExportFormDataToXFDF, ImportFormDataFromXFDF) čte a zapisuje podstrom /Fields a ničeho jiného se nedotýká. Rodina anotací (ExportAnnotationsToFDF, ImportAnnotationsFromFDF, ExportAnnotationsToXFDF, ImportAnnotationsFromXFDF) namísto toho čte a zapisuje podstrom /Annots, což je to, co Acrobat označuje jako Export komentářů. Tyto dvě rodiny se nikdy nepřekrývají, takže export hodnot polí nezahrne zatoulané poznámky z recenzí a import komentářů nenaruší hodnoty, které už uživatel zadal. To, co prvek (widget) dělá, když je na něj kliknuto nebo když je přepočítán, je opět třetí záležitost, kterou pokrývá doprovodná poznámka o interaktivních akcích formuláře a JavaScriptu
Jak naplnit PDF formulář z FDF nebo XFDF v Delphi?
Načtěte dokument, zavolejte jednu metodu importu a uložte. ImportFormDataFromXFDF a ImportFormDataFromFDF analyzují příchozí data formuláře, spárují každou položku s polem AcroForm podle jeho plně kvalifikovaného názvu, nastaví hodnotu a vrátí počet skutečně aktualizovaných polí. Obě metody aktualizují pouze pole, která v cílovém PDF již existují; ani jedna nevytváří pole pro název, který formulář nedefinuje, což brání tomu, aby zatoulaný nebo škodlivý datový soubor potichu zvětšil váš formulář
var
  Lib: TPDFlib;
  FieldsSet: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('application-blank.pdf', '');
    // XFDF vygenerované systémem správy případů, na disku již v UTF-8
    FieldsSet := Lib.ImportFormDataFromXFDF('applicant-1042.xfdf');
    if FieldsSet > 0 then
      Lib.SaveToFile('application-filled.pdf');
  finally
    Lib.Free;
  end;
end;
Dva detaily rozhodují o tom, zda netriviální data přežijí cestu. Prvním je escapování: FDF ukládá hodnoty jako doslovné řetězce PDF, takže hodnota obsahující závorku, zpětné lomítko nebo netisknutelný bajt dorazí zabalená v osmičkovém escapování definovaném v ISO 32000-2 §7.3.4.2, a losLab PDF Library toto escapování při importu invertuje, takže závorky a lomítka se vrátí jako doslovné znaky, které uživatel zadal. Druhým je kódování: metody založené na souborech zapisují a čtou XFDF a FDF v UTF-8, což je to, co deklarace XFDF slibuje a co jakákoli ne-ASCII hodnota pole (jméno s diakritikou, symbol měny, CJK adresa) potřebuje k tomu, aby prošla obousměrným přenosem bez poškození. Pokud XFDF vytváříte sami, deklarujte UTF-8 a zapisujte UTF-8, a import bude s vámi souhlasit
Hierarchická pole, výběry s více hodnotami a formátovaný text
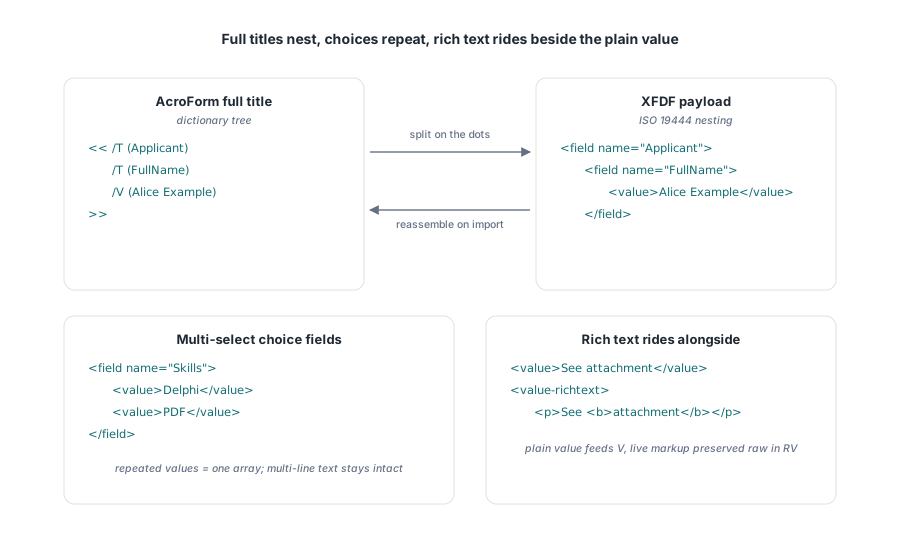
Hierarchické názvy polí jsou prvním místem, kde naivní exportér selže. AcroForm addresses a nested field with a dotted full title such as Applicant.FullName, but XFDF does not put that dotted string in a single name attribute; ISO 19444 nests it, as <field name="Applicant"><field name="FullName">. losLab PDF Library při exportu rozdělí tečkovaný název do vnořených prvků <field> a při importu vnořené prvky znovu sestaví do plného názvu, takže oba směry zůstávají symetrické. Při exportu také přeskakuje nekoncová rodičovská pole, protože rodičovský uzel v AcroForm nese pouze úroveň pojmenování a nemá žádnou vlastní hodnotu; jeho emise by vyprodukovala prázdné <value></value>, které neodpovídá skutečnému formuláři. Seznamy s vícenásobným výběrem jsou druhou pastí: pole výběru může obsahovat několik vybraných hodnot najednou, což XFDF vyjadřuje jako opakované prvky <value> a FDF jako pole /V, a losLab PDF Library pole rozdělí na více hodnot pouze tehdy, když se skutečně jedná o výběr s vícenásobným výběrem, takže běžné víceřádkové textové pole si zachová konce řádků namísto toho, aby se roztříštilo na falešné hodnoty
Formátovaný text (rich text) je třetí a je to to, v čem lidé chybují nejčastěji. Pole s formátováním ukládá své značky v položce RV jako podstrom XHTML a XFDF jej nese v <value-richtext>. losLab PDF Library zapisuje tento podstrom jako živý XML fragment namísto jeho escapování, takže navazující nástroj čte skutečný formátovaný text namísto řetězce viditelných značek; při importu zachovává surový podstrom RV a přesto aplikuje prostou hodnotu <value> na V. Tam, kde pole nabízí obojí, vyhrává prostá hodnota pro V a formátovaný text se veze vedle v RV, což je pravidlo interoperability, které brání tomu, aby import formátovaného textu potichu přepsal hodnotu, kterou již nastavil jiný nástroj. Pokud váš formátovaný text existuje za účelem zprostředkování struktury dokumentu asistivním technologiím, zacházejte s ním stejným způsobem, jakým byste zacházeli s pořadím čtení popsaným v poznámce o tagovaném PDF a struktuře přístupnosti
var
  Lib: TPDFlib;
const
  XFDF =
    '<?xml version="1.0" encoding="UTF-8"?>' +
    '<xfdf xmlns="http://ns.adobe.com/xfdf/" xml:space="preserve">' +
    '<fields>' +
    '  <field name="Applicant">' +
    '    <field name="FullName"><value>Alice Example</value></field>' +
    '  </field>' +
    '  <field name="Skills">' +
    '    <value>Delphi</value><value>PDF</value>' +
    '  </field>' +
    '  <field name="Notes">' +
    '    <value>See attachment</value>' +
    '    <value-richtext><body><p>See <b>attachment</b></p></body></value-richtext>' +
    '  </field>' +
    '</fields></xfdf>';
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('intake.pdf', '');
    // Applicant.FullName se znovu sestaví; Skills naplní pole /V + /I;
    // Notes získá V z <value> a RV z <value-richtext>
    Lib.ImportFormDataFromXFDFString(XFDF);
    Lib.SaveToFile('intake-filled.pdf');
  finally
    Lib.Free;
  end;
end;
Jak přenášet komentáře anotací oběma směry jako FDF nebo XFDF?
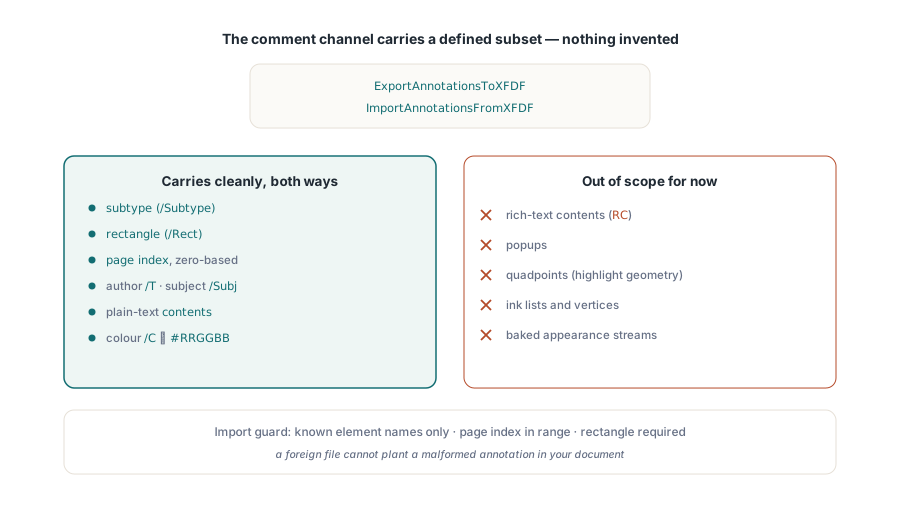
Komentáře putují v rodině anotací a podporovaná podmnožina je záměrně malá. ExportAnnotationsToXFDF a ImportAnnotationsFromXFDF spolu se svými protějšky FDF přenášejí značky textového stylu u polí, která se skutečně čistě přenášejí oběma směry: podtyp anotace, její obdélník, její index stránky od 0, autor v T, předmět v Subj, prostý obsah Contents a barva, která mapuje trojici PDF /C DeviceRGB na atribut XFDF #RRGGBB a zpět. Import přijímá pouze známé názvy prvků a přeskakuje jakoukoli položku, jejíž stránka je mimo rozsah nebo jejíž obdélník chybí, takže ručně upravené nebo cizí XFDF nemůže do dokumentu vložit poškozenou anotaci. To, co tato podmnožina dosud nepřenáší, stojí za to uvést na rovinu: formátovaný text obsahu (RC), vyskakovací okna (popups), quadpoints, seznamy inkoustů (ink lists), vrcholy a vykreslené toky vzhledu (appearance streams) jsou v současné době mimo rozsah, takže geometrie zvýraznění a vlastní vzhledy razítek tuto cestu nepřežijí. Chcete-li potvrdit, co skutečně dorazilo, projděte anotace stránek nebo širší strom prvků popsaný v vyhledávání textu a enumeraci prvků stránek
var
  Src, Dest: TPDFlib;
  Xfdf: WideString;
begin
  Src := TPDFlib.Create;
  Dest := TPDFlib.Create;
  try
    Src.LoadFromFile('reviewed.pdf', '');
    Xfdf := Src.ExportAnnotationsToXFDFString;   // pouze podmnožina <annots>

    Dest.LoadFromFile('clean-copy.pdf', '');     // stránky se musí shodovat podle indexu
    Dest.ImportAnnotationsFromXFDFString(Xfdf);
    Dest.SaveToFile('clean-copy-commented.pdf');
  finally
    Dest.Free;
    Src.Free;
  end;
end;
Zápis celého balíčku XFA XDP pomocí SetXFAFromString
XFA je odlehlá hodnota a SetXFAFromString je způsob, jak zapsat celou věc najednou. Metoda přijímá kompletní XML Data Package, dokument <xdp:xdp> se šablonou a datovými balíčky, a ukládá jej jako stream odkazovaný z /AcroForm/XFA. losLab PDF Library vytvoří kontejner AcroForm na požádání, když jej dokument nemá, takže nemusíte přidávat zbytečné pole jen proto, aby mělo XFA na čem viset, a zahodí jakýkoli analyzovaný stav XFA, který uchovávala, takže pozdější čtení odráží balíček, který jste právě zapsali, a nikoli zastaralou mezipaměť. Vzhledem k tomu, že balíček XFA is XML and not necessarily UTF-8, the library detects a UTF-16 byte-order mark and decodes the packet correctly before parsing, which matters for packets produced by tools that default to UTF-16
Jakmile je balíček na svém místě, GetXFAFormFieldValue a SetXFAFormFieldValue adresují jednotlivá pole prostřednictvím jejich cesty Scripting Object Model (SOM). losLab PDF Library přijímá standardní kořeny SOM i holé relativní cesty, takže form1.FullName, $data.form1.FullName a xfa.datasets.data.form1.FullName se všechny rozliší na stejný datový uzel a strana šablony přijímá $template a xfa.template stejným způsobem. Tato tolerance je důležitá, když jsou cesty SOM generovány jiným systémem, který vždy generuje plně kvalifikovaný formulář
var
  Lib: TPDFlib;
const
  Xdp =
    '<?xml version="1.0" encoding="UTF-8"?>' +
    '<xdp:xdp xmlns:xdp="http://ns.adobe.com/xdp/">' +
    '  <template xmlns="http://www.xfa.org/schema/xfa-template/3.3/">' +
    '    <subform name="form1">' +
    '      <field name="FullName"><ui><textEdit/></ui></field>' +
    '    </subform>' +
    '  </template>' +
    '  <xfa:datasets xmlns:xfa="http://www.xfa.org/schema/xfa-data/1.0/">' +
    '    <xfa:data><form1><FullName>Alice Example</FullName></form1></xfa:data>' +
    '  </xfa:datasets>' +
    '</xdp:xdp>';
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetXFAFromString(Xdp, 0);      // vytvoří kontejner AcroForm, pokud žádný neexistuje
    // přečte zpět přes data DOM s cestou SOM
    if Lib.GetXFAFormFieldValue('form1.FullName') = 'Alice Example' then
      Lib.SetXFAFormFieldValue('form1.FullName', 'Bob Example');
    Lib.SaveToFile('xfa-packet.pdf');
  finally
    Lib.Free;
  end;
end;
Upřímným shrnutím je, že hodnoty polí plně procházejí obousměrným přenosem přes FDF a XFDF, a to včetně hierarchie, vícenásobného výběru a formátovaného textu; komentáře anotací procházejí jako definovaná podmnožina textových značek s jasnými mezerami; a XFA se zapisuje a čte jako celý balíček s přístupem SOM k jednotlivým polím navrch. Přizpůsobte formát příjemci, u všeho, co vytváříte ručně, deklarujte UTF-8 a pamatujte, že metody importu se dotýkají pouze polí a anotací, které již do dokumentu pasují. Zde popsané metody pro data formulářů, anotace a XFA jsou součástí knihovny losLab PDF Library pro Delphi a C++Builder, jejíž referenční příručka obsahuje úplný seznam parametrů pro každý vstupní bod exportu a importu