Импортираш FDF във форма и стойностите на полетата се връщат тихо сбъркани: bullet пристига като dagger, ellipsis като em dash. PDFium Component проследи цялото това семейство симптоми до един-единствен ред в своята таблица за PDFDocEncoding — блокът със специалните символи в Annex D.2 на ISO 32000-1 започва от $80, а не от $7F
Защо FDF импортът връща съседния символ?
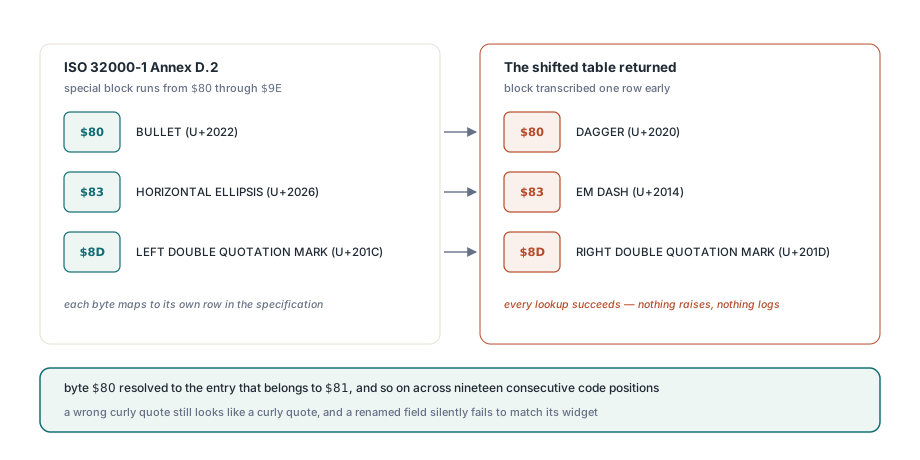
Защото таблица за кодиране, изместена с една позиция, пак изглежда напълно валидна и всяко търсене в нея успява. Блокът, който Annex D.2 отрежда на $80 до $9E, беше преписан с един ред по-рано, така че байт $80 се резолвваше към записа, който принадлежи на $81, байт $81 — към записа за $82, и така през деветнайсет поредни кодови позиции. Нищо не гърмеше, нищо не се логваше и нито едно поле не беше отхвърлено — TPdf.ImportFDF връщаше същия брой полета като винаги
Щетите бяха еднакви навсякъде и тихи. Байт със стойност $80, който Annex D.2 дефинира като BULLET (U+2022), се връщаше като DAGGER (U+2020). Байт $83, HORIZONTAL ELLIPSIS (U+2026), се връщаше като EM DASH (U+2014). Байт $8D, LEFT DOUBLE QUOTATION MARK (U+201C), се връщаше като RIGHT DOUBLE QUOTATION MARK (U+201D) — случаят, който никой не забелязва, защото сбърканата извита кавичка пак си прилича на извита кавичка в поле на форма. Имената на полетата ги сполетя същата участ като стойностите, което е по-лошо: име, което вече не съвпада с widget-а в документа, мълчаливо не се прилага
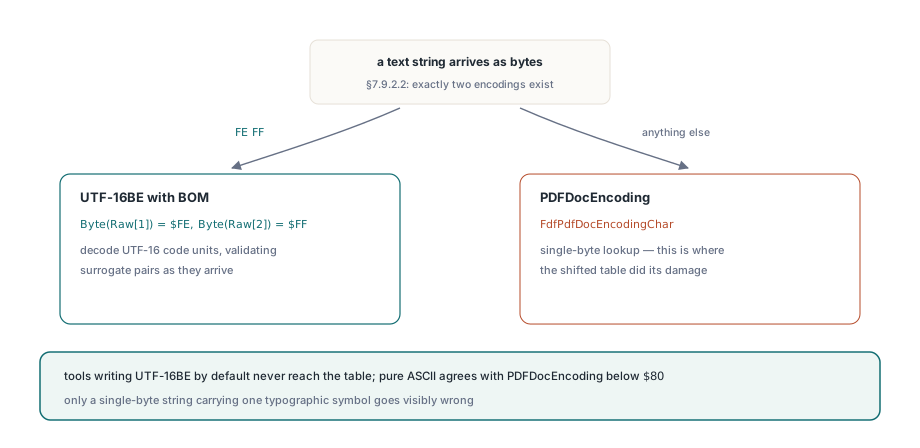
Текстовите низове в PDF носят две различни кодировки
ISO 32000-1 §7.9.2.2 дефинира типа text string като една от точно две кодировки, избрана чрез инспекция на първите два байта, а не чрез някакъв запис в речника. Низ, който започва с byte order mark FE FF, е UTF-16BE; всичко останало е PDFDocEncoding. Този единствен разклон решава кой от два напълно различни декодера ще се изпълни, и PDFium Component го прилага вътре в FDF парсера, преди да е докоснал дори един символ
// FDF text string: UTF-16, когато BOM е наличен, иначе PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... декодиране на UTF-16 code units с валидация на surrogate двойките
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
Ето защо бъгът се кри толкова дълго от обикновеното тестване. Всеки FDF, произведен от инструмент, който по подразбиране пише UTF-16BE, изобщо не стига до FdfPdfDocEncodingChar, така че изместената таблица остава в латентно състояние. Само еднобайтовите низове — точно това, което много FDF генератори излъчват за обикновени латински имена на полета, защото са по-къси — минават по клона, където таблицата има значение. Чисто ASCII имената на полета пак се декодират правилно, защото под $80 PDFDocEncoding и ASCII съвпадат. Трябва ти еднобайтов низ, съдържащ един типографски символ, преди нещо да се сбърка видимо
Поправената таблица и двата котва, които я закрепват
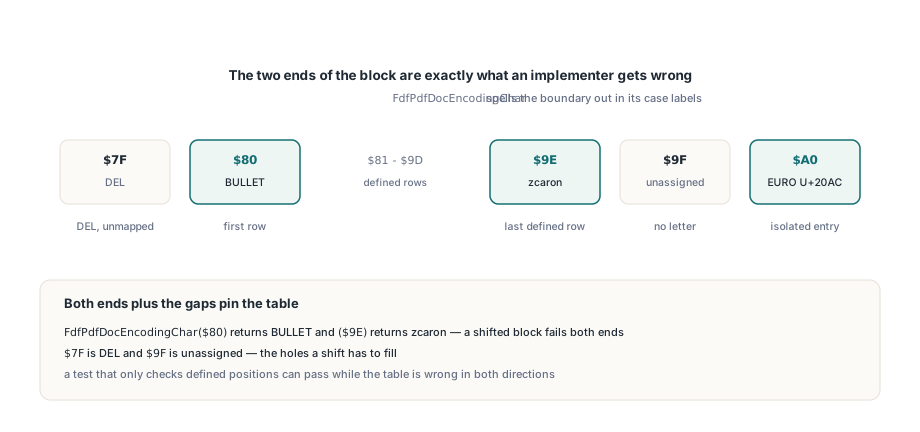
PDFium Component вече изписва границата в самия FdfPdfDocEncodingChar, защото двата края на блока са точно това, с което имплементаторът се обърква. $7F е DEL и изобщо няма значение в PDFDocEncoding; блокът отваря на $80 с BULLET и стига до $9E със zcaron; $9F е неприсвоен; а знакът Euro стои сам на $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Annex D.2. Блокът върви от $80, не от $7F: $7F е DEL и
    // няма значение в PDFDocEncoding, а Euro стои на $A0, което
    // иначе default клонът би върнал като no-break space
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, първи ред на блока
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 до $9D
    $9E: Result := WideChar($017E);   // zcaron, последният дефиниран ред
    $9F: Result := WideChar($FFFD);   // неприсвоен в Annex D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Погледни какво направи отместването с тези два края, защото точно там off-by-one престава да е козметичен. zcaron стоеше на $9E в спецификацията, но на $9D в изместената таблица, така че документен байт със стойност $9E падаше след последния ред, който някой беше преписал, и отиваше право към identity fallback-а, връщайки C1 control символ вместо буква. А $A0, Euro, изобщо не беше вписан в таблицата — identity клонът го връщаше като U+00A0 NO-BREAK SPACE, символ, който преживява всяка следваща валидация, не се отпечатва и никога не съвпада с името на полето, което търсиш
Как тестваш преписвана таблица за кодиране?
Тествай първия ред, последния ред и празнините — не извадка от средата. Това е частта от поправката, която си струва да пренесеш върху всяка друга таблица, която преписваш от спецификация, защото spot check в средата на блока е точно тестът, който отместеният цял блок преживява. Проверката, че $8D дава лява двойна кавичка, не доказва нищо, когато $8C също дава нещо правдоподобно; проверката, че $80 дава BULLET и $9E дава zcaron, закрепва двата края, а отместен блок не може да удовлетвори и двете едновременно
procedure CheckPdfDocEncodingAnchors;
begin
  // Двата края на специалния блок от Annex D.2: отместване на целия блок ги чупи
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Кодови позиции, които спецификацията оставя недефинирани, не трябва да декодират до буква
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // Изолираният запис над блока, лесен за цялостно пропускане
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
Недефинираните позиции заслужават собствени assertions, вместо да се прескачат като безинтересни. Off-by-one трябва да сложи нещо някъде, и мястото, където го слага, почти винаги е кодова позиция, която спецификацията е оставила празна — $7F отпред, $9F отзад. Тест, който проверява само дефинираните позиции, може да мине, докато таблицата е сбъркана в двете посоки; тест, който закрепва дупките, хваща отместването още при първото пускане
Какво струва това в round-trip workflow с форми
FDF импорт, който тихо пренаписва по един символ на знак, е по-лош от такъв, който се проваля, защото провалът изплува по-надолу по веригата и изглежда като нещо друго. Имената на полетата са острият ръб тук. TPdf.ImportFDF съпоставя входящите имена с widget-ите в отворения документ, и име, което се е декодирало с един сбъркан символ, просто не съвпада — полето остава празно, върнатата стойност пак брои полето като разпарсено, а докладът, който излиза от pipeline-а, е с една стойност по-малко и нищо в лога не обяснява защо. Всеки, който строи export-and-reimport цикъл от вида, описан в експортирането и импортирането на XFDF form данни и анотации с PDFium Component, трябва да round-trip-не име на поле, съдържащо типографски символ, а не само чист ASCII, преди да се довери на цикъла
Струва си също да сме честни за границите на поправката. Таблицата вече съвпада с Annex D.2 за всичките 256 байтови стойности, което кара еднобайтовите FDF низове да се декодират правилно, но самата PDFDocEncoding покрива латински репертоар и нищо повече — всичко извън него трябва да пристигне като UTF-16BE с BOM, което е точно това, което §7.9.2.2 иска. А UTF-16 низът си има отделни опасности на страната на Delphi, защото code point отвъд U+FFFF се нуждае от surrogate двойка, а не от един WideChar — проблемът, разгледан в защо emoji и CJK символите чупят WideChar в Delphi. По-широкият извод се обобщава отвъд таблиците за кодиране: PDF парсер може да отхвърли нещо, което трябва да приеме, и това откриваш веднага, или да приеме нещо и тихо да го сбърка, което откриваш в production. Капаните с name token-и, описани в безопасното парсване на PDF речници, са във втората категория, а също и таблица, отместена с един ред — code path-ът успява, върнатата стойност изглежда разумна, и само тест, написан срещу спецификацията, а не срещу имплементацията, казва другото
ImportFDF, ExportFDF и ImportXFDF на TPdf, заедно с FDF и XFDF парсерите зад тях, са част от стандартния PDFium Component за Delphi и C++Builder