PDFium Component версия 3.117.0 свързва таблица, прекъсната през граница между страници, когато или и двата фрагмента докосват ръбовете на страницата, или няма основен текст под първия фрагмент и над втория, като колонтитулите се игнорират. ExtractDocumentTables прилага този content-aware тест като алтернатива на по-стария тест по полета на страницата, отказва следващо-страничен фрагмент, чийто първи ред е единична клетка-подзаглавие с пълна ширина, и запазва единичен ред, прелил на следващата страница, като част от неговата continuation верига
Статията за откриване и извличане на таблици представи continuation като четири строги порти и третира „докосва ръба на страницата“ като един от тях. Това описание беше вярно за изданието, което покриваше, и също беше грешно за повечето таблици, които хората действително подават на компонента. Тази статия е корекцията: кои документи тестът по полета не може да обработи, какво го замени и двата странични случая, които поправката завлачи със себе си
Защо тестът по полета се проваля на Word експорти?
Тестът по полета се проваля, защото текстов процесор спира подреждането на редове на долното поле, не на ръба на хартията. С подразбиращия се ContinuationMargin от 36 пункта, оригиналното правило изискваше долният ръб на по-ранния фрагмент да лежи в рамките на 36 пункта от дъното на страницата, а горният ръб на по-късния — в рамките на 36 пункта от върха. Документ, експортиран от Word с подразбиращите се полета от един инч, поставя последния ред поне 72 пункта над дъното на страницата, още по-нависоко, ако има footer, така че условието никога не пасваше. Всяка дълга таблица в такъв документ се връщаше като независими фрагменти с ContinuationGroup нула, а caller-ът се връщаше на ръчно залепване. Тестът все още има смисъл за онова, около което е проектиран: доклади, генерирани от layout engine-и, които пълнят страница до фиксиран content бокс и започват следващата страница наравно с върха. Не е лошо правило, а непълно, затова версия 3.117.0 го запази и добави втори път, вместо да го замени
Какво проверява вместо това content-aware тестът?
Content-aware тестът проверява дали нещо друго освен таблицата заема пространството между двата фрагмента, ползвайки word боксовете на всяка страница, а не геометрията на страницата. Докато ExtractDocumentTables обхожда документа, той записва, на страница, най-ниския долен ръб на всяка дума, чийто връх лежи над footer лентата, и най-високия горен ръб на всяка дума, чийто долен ръб лежи под header лентата. И двете ленти са ContinuationMargin пункта дълбоки, така че същата опция вече върши двойна работа — като slack на ръба на страницата и като височина на зоните на движещите се header и footer. Двойка фрагменти пасва, когато долният ръб на по-ранния е на или под най-ниския основен текст на неговата страница, а горният ръб на по-късния е на или над най-високия основен текст на следващата страница, всичко в рамките на AlignmentTolerance. С прости думи: таблицата беше последното нещо на страница N и първото на страница N+1, а номер на страница или заглавие на документ в лентовата зона не брои. Това изключение не е произволно. ISO 32000-1 §14.8.2.2 класифицира движещите се header и footer като pagination артефакти — съдържание, съществуващо заради прекъсването на страницата, а не въпреки него — и същата идея, която позволява на tagged reader да ги прескача, е тази, която позволява на таблица да продължи след тях. Статията за marked content покрива как tagged файлове декларират тези артефакти изрично; тук класификацията се извежда от позицията, защото повечето експортирани таблици изобщо не носят тагове
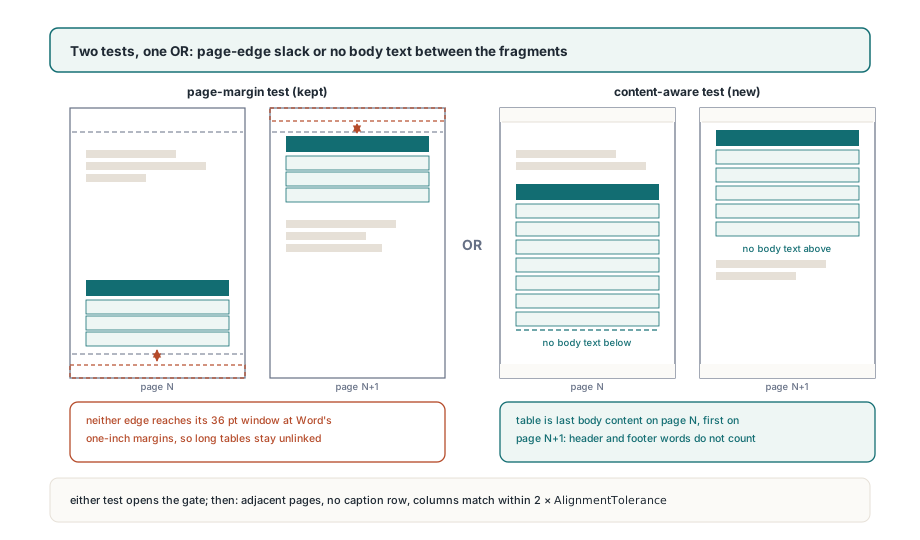
Двата теста се съчетават с OR. Доклад от layout engine, чиито таблици вървят до ръба на хартията, пасва на първия; Word експорт, чиито таблици спират на полето, пасва на втория; документ, който прави и двете, пасва два пъти. Само след като единият успее, тръгват останалите порти, и те тръгват в фиксиран ред: номерата на страниците трябва да са съседни, по-късният фрагмент не бива да се отваря с ред-подзаглавие, а колоночните граници трябва да съвпадат в рамките на два пъти AlignmentTolerance, което е 6 пункта при подразбиращите се. Изброяването е TPdfTableContinuation със стойности ptcNone, ptcStart, ptcMiddle и ptcEnd. Фрагмент, маркиран ptcEnd и после свързан нататък към още една страница, се повишава до ptcMiddle, така че три-странична таблица чете start, middle, end в ред на страниците. Груповите номера започват от 1, а 0 означава несвързано, и ToJson излъчва същата информация като членовете continuation и continuationGroup — формата, която да предпочитате, ако downstream услуга върши залепването
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectContinuations := True;     // по подразбиране; показано за яснота
    Options.ContinuationMargin := 54;        // двуредов footer, ~50 pt дълбок

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d (%d rows)',
          [Tables[I].PageNumber, Tables[I].RowCount]));
      end;
  finally
    Pdf.Free;
  end;
end;
Как един ред-подзаглавие спира две таблици да се слеят?
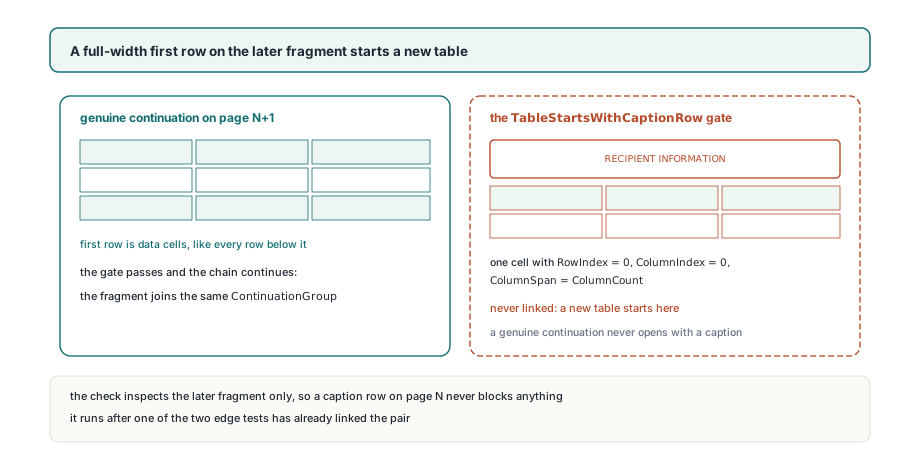
Следващо-страничен фрагмент, чийто първи ред е една клетка, разпъната върху всички колони, се третира като нова таблица, никога като остатъка от предишната. Това правило съществува, защото content-aware тестът, сам по себе си, свързва твърде ревниво. Случаят, който го изласка, беше форма от типа на стенограма: таблица свършва близо до дъното на страница 1, втора таблица с идентични колоночни ширини започва близо до върха на страница 2, нищо освен footer-ът седи между тях, а колоните съвпадат до точка. Под теста по полета двете никога не се срещнаха, защото нито една не докосна ръб; под content теста те се свързаха веднага, а форма със секции стана една несвързана мрежа. Това, което ги разделя, е видимо в клетъчната структура. Втората таблица се отваря със заглавие на секция като „RECIPIENT INFORMATION“, разположено като една слета клетка с пълна ширина, а истинско continuation никога не прави това, защото заглавието принадлежи на таблицата, вече започнала на предишната страница. TableStartsWithCaptionRow кодира точно това: фрагментът има поне две колони и съдържа клетка с RowIndex = 0, ColumnIndex = 0 и ColumnSpan = ColumnCount. Проверката върви само на по-късния фрагмент, така че таблица, чийто собствен ред-подзаглавие седи на първата ѝ страница, не се засяга; заглавието е на страница N, а само фрагментът на страница N+1 се инспектира
Сравнението на колони, което следва, TablesHaveMatchingColumns, е по-строго от „същия брой колони“. То възстановява граничните позиции на всеки фрагмент от клетъчните правоъгълници, интерполира граници, скрити от слети клетки, и отхвърля двойката, когато която и да е граница се отмести с повече от толеранса. Две четири-коколонни таблици с различни пропорции следователно остават разделени, дори всичко останало да се подравни
Какво става с единичен ред, прелял на следващата страница?
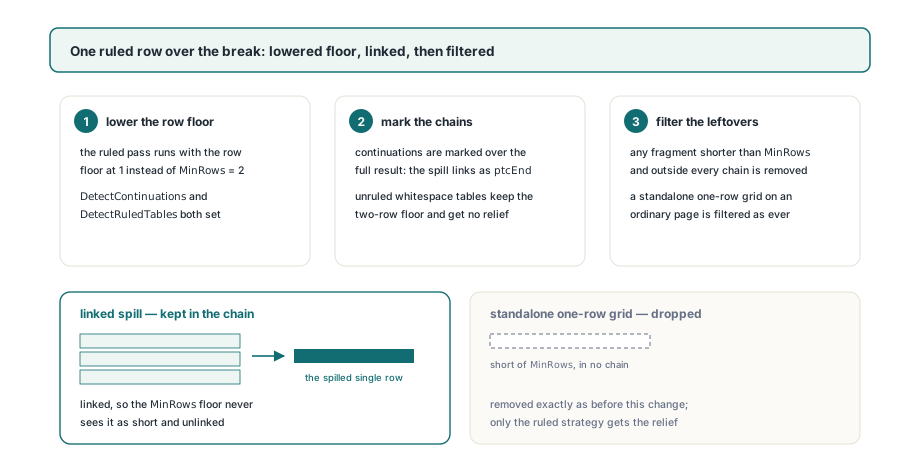
Линирана мрежа, която пренася един ред на следващата страница, вече се открива и свързва, стига да попадне в continuation верига; сама по себе си тя се изхвърля. Подразбиращият се MinRows от 2 съществува, за да не се докладва случайна двойка линии като таблица, но последен ред, изтласкан през прекъсването, е истински ред, който твърд под от 2 тихо изпускаше, а останалата част от таблицата изглеждаше пълна, когато не беше. Сканирането на ниво документ го обработва в три стъпки. Когато DetectContinuations и DetectRuledTables са зададени и двете, per-page проходът пуска ruled детектора с редовия под временно смален до 1, което е причината ExtractTables вече приема MinRows 1 за ruled мрежи, докато whitespace откриването пази вътрешен под от 2. Continuations се маркират върху пълния резултат. После всяка таблица, по-къса от MinRows на caller-а и нечаст от нито една верига, се премахва. Единично-редовият фрагмент оцелява само защото е свързан, а едно-редова мрежа в средата на иначе обикновена страница се филтрира точно както преди
// Възстанови всяка верига като един CSV, изпускайки повторените header редове
// върху continuation фрагментите
procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R: Integer;
  Lines: TStringList;
  Csv: TStringList;
begin
  Csv := TStringList.Create;
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      if Tables[I].Continuation in [ptcNone, ptcStart] then
        Csv.Clear;
      Lines.Text := string(Tables[I].ToCsv);
      if (Tables[I].Continuation in [ptcMiddle, ptcEnd]) and
         (Lines.Count > 1) and (Tables[I].RowCount > 1) then
        Lines.Delete(0);            // header, повторен от текстовия процесор
      for R := 0 to Lines.Count - 1 do
        Csv.Add(Lines[R]);
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Csv.SaveToFile(Format('%s\page%d-group%d.csv',
          [Folder, Tables[I].PageNumber, Tables[I].ContinuationGroup]));
    end;
  finally
    Lines.Free;
    Csv.Free;
  end;
end;
Два детайла в тази рутина са умишлени. Единично-редовият прелив никога не се обелва, защото guard-ът върху RowCount го пази, а текстов процесор, който повтаря header реда на всяка страница, произвежда фрагмент, чиято първа линия е пак header-ът, така че изпускането на нулевата линия на middle и end фрагменти е вярно за този случай и погрешно за генератор, който не повтаря header-и. Проверете един документ, преди да пуснете рутината на свобода из папка
Къде правилата все още спират
Content-aware тестът е толкова добър, колкото текстовият слой, който чете. На сканирана страница без никакъв текст записаните крайности на основния текст се връщат към границите на страницата, условието „нищо между“ се удовлетворява вакуумно, и остават само портите на реда-подзаглавие и на колоните; ruled мрежа на такава страница все още се намира като празен скелет, така че веригата може да се свърже правилно, но нищо за околния текст всъщност не е проверено. Добавете текстов слой първо, ако това има значение. Footer-и, рендерирани като изображения, а не като текст, са невидими за лентовата логика и безвредни по същата причина
Лентите са едно число. Footer, по-дълбок от ContinuationMargin, оставя долните си линии вътре в зоната на основния текст, което кара по-ранния фрагмент да изглежда последван от текст и блокира връзката; вдигнете опцията до истинската дълбочина на лентата, както прави първият пример. Вдигнете я твърде далеч и кратък закриващ параграф близо до дъното на страницата се изплъзва в лентата и се игнорира, което свързва таблица с каквото и да е след нея. Правилото за подзаглавието има огледално-обратно проваливане: генератор, който записва слет банер „continued“ като първи ред на всеки continuation фрагмент, ще види тези фрагменти отказани като нови таблици, а единственото средство днес е сами да залепите по ContinuationGroup, без да разхлабвате нищо, защото правилото няма ключ
Whitespace-откритите таблици не получават нито едно от едно-редовите облекчения. Whitespace стратегията се нуждае от два подравнени реда, за да види таблица изобщо, така че нелинирана таблица, която прелива един ред, все още се докладва с този ред по-къса. Когато го удариете, word боксовете зад структурирани текстови блокове и ред на четене ви дават суровите позиции да го възстановите. Върху примерния набор, задвижвал тази работа — тринадесет експорта от текстови процесори и браузъри — петте документа с истински много-странични таблици всички се свързаха в единични вериги, а формата-стенограма, която преди се сливаше, остана разделена, което е летвата, спрямо която се мери изданието, не обещание за всяко подреждане
Маркирането на continuation, правилото за подзаглавие и единично-редовият проход всички живеят в пътя на ниво документ, споделен от build-овете за Delphi, C++Builder и Lazarus; пълното API за извличане на таблици е описано на страницата на PDFium Component за Delphi