Симптомът се появи в помощна програма за копиране на страници, изградена върху HotPDF Delphi Component: искането за страница 1 от документ с три страници постоянно връщаше страница 2. Проверката на логиката за индексиране не откри нищо нередно. Извикването използваше логически индекс, базиран на 0, аритметиката беше правилна, граничните условия бяха наред. И въпреки това, всеки път излизаше грешната страница
Бъгът изобщо не беше в кода за копиране. Той се криеше в това как HotPDF изграждаше своя вътрешен масив от страници при зареждане на файла
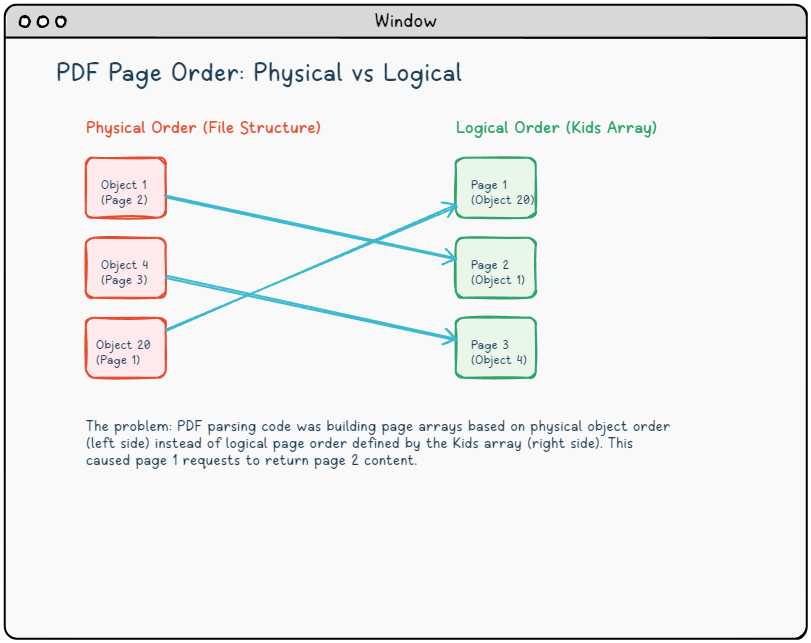
Две подредби, един източник на объркване
PDF файлът е колекция от непреки обекти (indirect objects), всеки от които е идентифициран с номер на обект. Структурата на файла не налага никакво задължение тези номера да отразяват реда на четене. Обект 1 може да съдържа страница 2; обект 20 може да съдържа страница 1. Това, което всъщност дефинира реда на четене, е дървото на страниците (page tree): йерархия от речници /Pages, чиито масиви /Kids изброяват препратки към страници в последователността, в която програмата за преглед трябва да ги покаже (ISO 32000-1 §7.7.3)
Документът, предизвикващ бъга, имаше следната структура на дървото на страниците:
{ Корен на дървото Pages, обект 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { logical page 1 }
         1 0 R    { logical page 2 }
         4 0 R]   { logical page 3 }
>>
endobj
Случи се така, че файлът изброяваше обект 1 и обект 4 преди обект 20 в потока от байтове. Всеки парсер, който итерира през непреките обекти в реда на файла и ги записва в PageArr, когато намери речници от тип страница, би завършил с обект 1 на индекс 0, обект 4 на индекс 1 и обект 20 на индекс 2. Логическа страница 1 се намира на PageArr[2]. Искането за индекс на страница 0 извлича логическа страница 2 вместо това
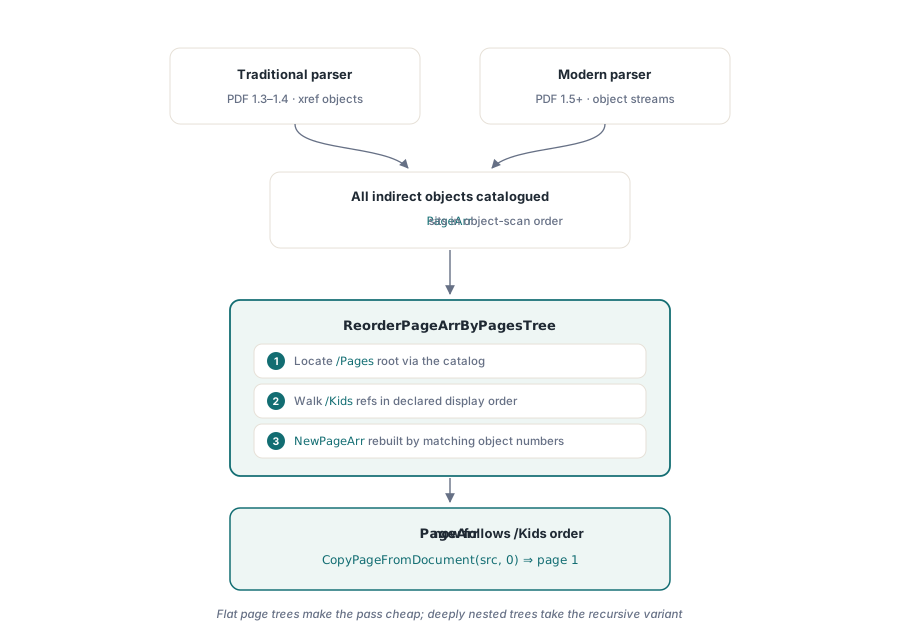
Това е точно това, което правеха и двата вътрешни пътя за синтактичен анализ на HotPDF. Традиционният път, използван за PDF 1.3/1.4 файлове, и модерният път, използван за документи с потоци от обекти (object-stream documents, PDF 1.5+), изграждаха PageArr чрез обхождане на непреките обекти във физическия ред на файла, вместо да следват веригата /Kids
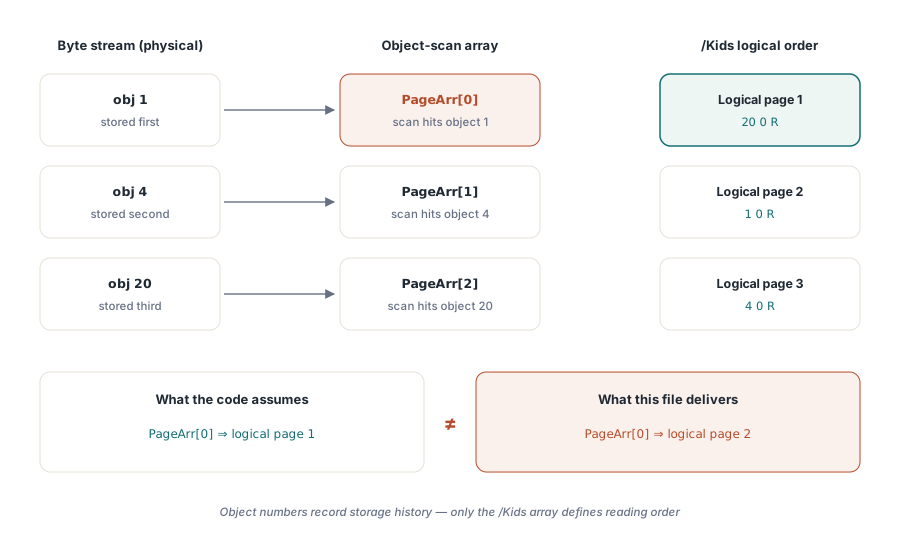
Потвърждаване на хипотезата
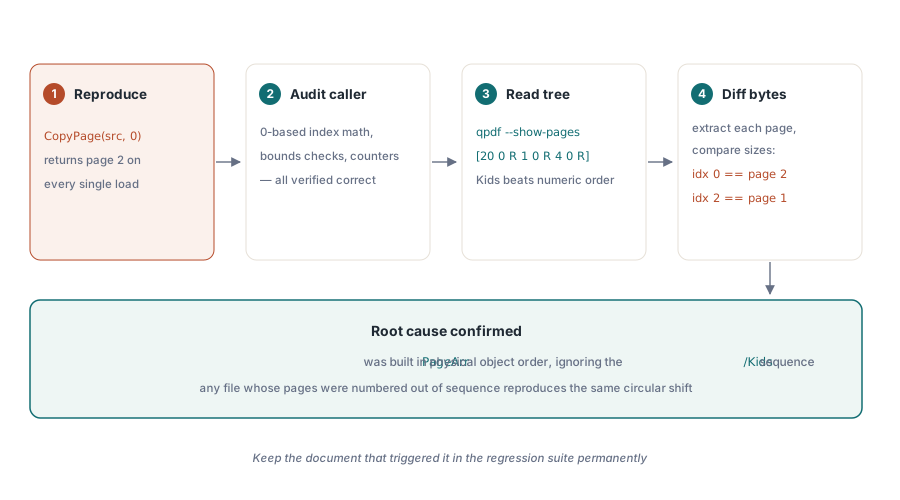
Преди да се докосне каквато и да е поправка, несъответствието трябваше да бъде доказано, а не предполагаемо. Инструментът за команден ред qpdf прави това лесно:
{ shell }
qpdf --show-pages input.pdf
{ Изходът показва реда на Kids: 20 0 R, после 1 0 R, после 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Показва речника Pages с /Kids в реда на четене }
Извличането на всяка страница поотделно и проверката на размерите на файловете потвърдиха картографирането: това, което PageArr[0] произвеждаше, беше съдържанието, принадлежащо на логическа страница 2, а PageArr[2] съдържаше логическа страница 1. Кръговото отместване (circular shift) беше неоспоримото доказателство. Това обясняваше и защо проблемът се появяваше в множество различни документи-източници: всеки PDF, при който обектите на страници случайно имаха по-ниски номера на обекти от по-ранна логическа страница, би го предизвикал
Има проста причина PDF файловете да се оказват в това състояние. Инкременталните записвания (incremental saves) добавят актуализирани обекти с нови номера на обекти, оставяйки старите слотове в таблицата с кръстосани препратки (cross-reference table) да сочат към нищото. Редакторите, които добавят заглавна страница, я вмъкват с висок номер на обект, независимо от нейната позиция в масива Kids. Някои генератори просто записват страниците в ред, удобен за стрийминг на съдържание, а не в логическата последователност на страниците. PDF форматът не изисква от тях да правят другояче
Поправката: следвайте масива Kids
Правилният подход е да изградите PageArr чрез обхождане на веригата /Kids от корена на каталога, а не чрез сканиране на непреки обекти. След като и двата пътя за синтактичен анализ завършат първоначалното си преминаване, стъпка на последваща обработка (post-processing step) разрешава логическия ред:
procedure THotPDF.ReorderPageArrByPagesTree;
var
  PagesObj  : THPDFDictionaryObject;
  KidsArray : THPDFArrayObject;
  NewPageArr: array of THPDFDictArrItem;
  I, J, PageIndex, KidsIndex: Integer;
  RefObj    : THPDFLink;
  PageObjNum: Integer;
  Found     : Boolean;
begin
  { Намерете кореновия речник /Pages чрез FRootIndex }
  PagesObj := FindPagesRootFromCatalog;
  if PagesObj = nil then Exit;

  KidsIndex := PagesObj.FindValue('Kids');
  if KidsIndex < 0 then Exit;
  KidsArray := THPDFArrayObject(PagesObj.GetIndexedItem(KidsIndex));

  SetLength(NewPageArr, KidsArray.Items.Count);
  PageIndex := 0;

  for I := 0 to KidsArray.Items.Count - 1 do
  begin
    RefObj     := THPDFLink(KidsArray.GetIndexedItem(I));
    PageObjNum := RefObj.Value.ObjectNumber;

    Found := False;
    for J := 0 to Length(PageArr) - 1 do
    begin
      if PageArr[J].PageLink.ObjectNumber = PageObjNum then
      begin
        NewPageArr[PageIndex] := PageArr[J];
        Inc(PageIndex);
        Found := True;
        Break;
      end;
    end;
    { Kids, които не са страници (междинни възли /Pages), не дават съвпадение; пропуснете }
  end;

  if PageIndex > 0 then
  begin
    SetLength(PageArr, PageIndex);
    for I := 0 to PageIndex - 1 do
      PageArr[I] := NewPageArr[I];
  end;
end;
Извикването влиза в края на всеки път за синтактичен анализ, след като всички обекти са били каталогизирани, но преди да бъде обслужена каквато и да е операция със страница:
{ Traditional path }
ListExtDictionary(THPDFDictionaryObject(IndirectObjects.Items[I]), FPageslink);
ReorderPageArrByPagesTree;
Break;

{ Modern path (object streams) }
if TryParseModernPDF then
begin
  Result := ModernPageCount;
  ReorderPageArrByPagesTree;
  Exit;
end;
Стъпката на пренареждане е O(n * m), където n е броят на Kids и m е текущата дължина на PageArr, но за всеки документ с плоско дърво на страниците (всички листа са на дълбочина 1, което покрива огромното мнозинство от реалните PDF файлове) и двете са с еднаква стойност и цената е незначителна. Дълбоко вложените дървета на страници изискват рекурсивно обхождане, а не показания тук подход на едно ниво; производствената имплементация обработва този случай отделно
Използване на CopyPageFromDocument след поправката
С въведеното ReorderPageArrByPagesTree логическите индекси на страниците работят според очакванията. Методът от по-високо ниво CopyPageFromDocument взема логически индекс, базиран на 0, и копира правилната страница в целевия документ:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Копирайте логическа страница 0 (първата страница, която вижда потребителят) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
CopyPageFromDocument вътрешно заявява реда на дървото на страниците, вместо да разчита на суровия индекс PageArr, така че се държи правилно дори срещу документи, където физическият и логическият ред се разминават. За групови операции InsertPagesFromDocument приема масив от логически индекси и ги копира на едно преминаване
Какво разкрива това за PDF синтактичния анализ
PDF спецификацията е изрична: логическият ред на страниците се дефинира от масива /Kids на дървото на страниците, а не от номера на обекти или отмествания в байтове (ISO 32000-1 §7.7.3.2). Всеки парсер, който използва различна подредба като пряк път, ще даде правилни резултати при по-голямата част от документите, които вижда, защото повечето генератори записват страниците в естествения ред и присвояват последователни номера на обектите. Бъгът се крие, докато някой не зареди PDF, който е бил редактиран инкрементално, реорганизиран от друг инструмент или генериран от софтуер, който е избрал различно оформление
Тестването само срещу самостоятелно генерирани PDF файлове напълно пропуска този клас проблеми. Следователно поправката за регресия в реда на страниците се нуждае от корпус от документи от разнообразни източници: инкрементални записвания, сканирани документи с вмъкнати заглавни страници, PDF файлове, произведени от инструменти, които линеаризират или оптимизират графа на обектите по различен начин. Документ, който е предизвикал първоначалния бъг, трябва да остане в пакета за регресионно тестване (regression suite) за постоянно
Страницата на HotPDF Delphi Component обхваща пълния API за операции със страници, включително CopyPageFromDocument, InsertPagesFromDocument и MovePage