HotXLS Delphi Excel Component запазва OpenDocument data pilot таблиците през един ODS цикъл отваряне-и-запис, като улавя <table:data-pilot-tables> поддървото на content.xml дословно при отваряне и го възпроизвежда при запис — от v2.382.0 нататък. От v2.382.1 фрагментът носи и всяка XML namespace връзка, декларирана от неговите ancestor-и, така че записаната pivot дефиниция остава well formed за всеки consumer, не само за HotXLS
Бъгът, който наложи и двете промени, излезе от строг corpus пробег. Примерът official-pivot.ods, записан от development build на LibreOffice 6.1, държи една pivot с име DataPilot1, която чете Sheet1.A2:E30 и каца резултата си в Sheet1.G6:J18. Отворете я с HotXLS, запишете я непроменена, пребройте елементите <table:data-pilot-table> в изхода: едно навътре, нула навън, еднакво на Win32 и Win64. Нищо в теста не пипна pivot-а. Първият кръг проби беше само сравнявал клетъчни константи и беше минал; структурната assertion беше тази, която изласка загубата — напомняне, че „стойностите съвпадат“ е слаба дефиниция за round-trip faithfulност
Защо ODS pivot таблица изчезва след запис от библиотеката?
ODS pivot таблица изчезва, защото HotXLS няма in-memory модел за OpenDocument data pilot таблици, а ODS writer-ът изгражда content.xml изцяло от модела. Writer-ът сглобява automatic styles, по един <table:table> на worksheet, <table:content-validations>, <table:named-expressions> и <table:database-ranges>, всяко генерирано от обекти, които работната книга действително държи. Pivot дефиниция — ODF 1.3 Part 3 §9.6, контейнер <table:data-pilot-tables> с по един <table:data-pilot-table> на pivot, носещ своя table:source-cell-range, своите table:data-pilot-field деца, своя table:target-range-address и table:buttons — няма обект, в който да живее, така че регенерираната част просто я пропуска
Контрастът с XLSX е умишлен. HotXLS парсва SpreadsheetML pivot cache-овете и pivot таблиците в истински модел, който можете да изградите, разширите с calculated fields и освежите от Delphi, така че те оцеляват при запис, защото се пренаписват, не се копират. ODS pivot-ите са много по-рядка заявка, а моделирането на ODF data pilot речника само заради round-trip би било много код, който никой не редактира. Прагматичният отговор е същият, който HotXLS вече прилага за непознати extLst блокове в XLSX: пазете това, което не моделирате, байт-по-байт, ако можете, event-по-event, ако не можете
Какво обърка първото Pos-базирано улавяне?
Улавянето във v2.382.0 отряза pivot дефиницията от content.xml като обикновен string, и в среза липсваха namespace декларациите, които го правеха смислен. Имплементацията беше толкова кратка, колкото звучи — декодирай частта в WideString, намери отварящия таг с Pos, намери затварящия таг след него, копирай интервала в FRawOdsDataPilotTablesXml върху работната книга:
// HotXLS v2.382.0 -- заменен една версия по-късно
function OdsCaptureDataPilotTablesXml(Stream: TStream): WideString;
const
  OpenTag: WideString = '<table:data-pilot-tables';
  CloseTag: WideString = '</table:data-pilot-tables>';
var
  Text: WideString;
  StartPos, ClosePos: Integer;
begin
  Result := '';
  Text := LoadPartAsWideString(Stream);   // целия content.xml в паметта
  StartPos := Pos(OpenTag, Text);
  if StartPos = 0 then Exit;
  ClosePos := Pos(CloseTag, Copy(Text, StartPos, MaxInt));
  if ClosePos = 0 then Exit;
  Result := Copy(Text, StartPos, ClosePos + Length(CloseTag) - 1);
end;
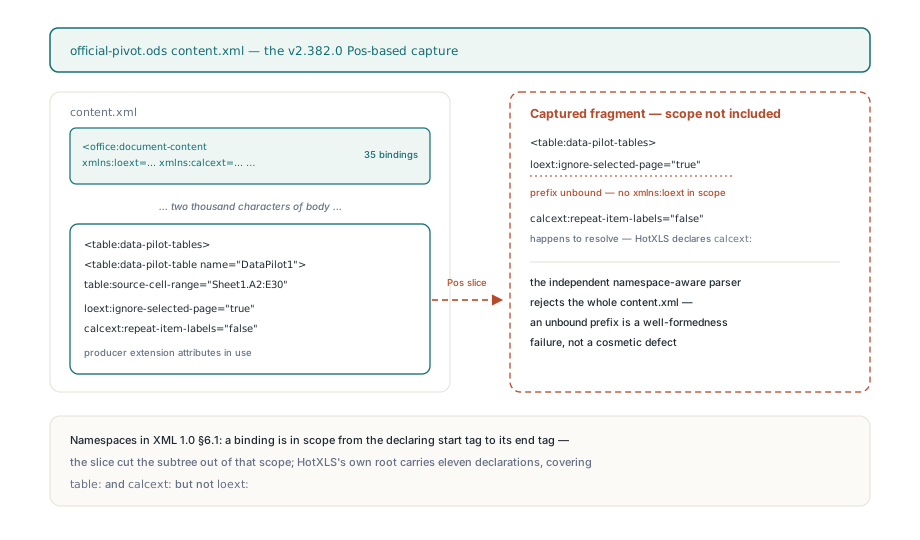
Count assertion-ът посини, и поправката излезе. Хвана я втора, по-строга проверка, добавена същия ден: всяка XML част на записания пакет се подава на независим namespace-aware парсер извън HotXLS, и този парсер отхвърли новия content.xml с грешка unbound prefix. Pivot-ът от LibreOffice носи producer extension атрибути — loext:ignore-selected-page="true" на page поле, calcext:repeat-item-labels="false" на всяко ниво — а отрязаният string съдържаше тези атрибути, но не и декларациите xmlns:loext и xmlns:calcext, които ги връзваха. Тези декларации седяха на корена <office:document-content> на source файла — трийсет и пет на брой, на две хиляди знака разстояние от pivot-а
W3C Namespaces in XML 1.0 §6.1 дефинира правилото, което превръща това в тежък провал, а не козметичен: namespace декларация е in scope от началния таг на елемента, на който се появява, до неговия затварящ таг, и всяко име с префикс вътре в този scope се разрешава срещу нея. Отрежете поддърво от документа и сте го отрязали от scope-а. HotXLS записва собствения си корен <office:document-content> с единадесет декларации — office, table, text, style, number, fo, draw, svg, xlink, calcext, tableooo — така че calcext: случайно се разреши, table: случайно се разреши, а loext: — не. Namespace-aware парсер третира необвързан префикс като нарушение на well-formedness, което означава, че цялата част е нечетима, а не само един атрибут
Как HotXLS пренася ancestor xmlns връзки върху фрагмента?
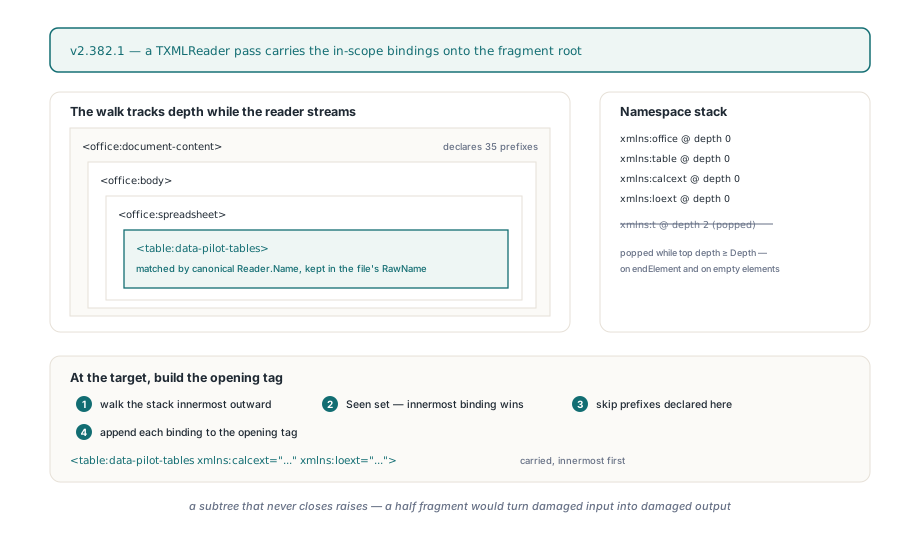
HotXLS v2.382.1 замени string среза с проход по content.xml чрез собствения му streaming TXMLReader, поддържайки стек от namespace връзки, етикетирани с дълбочината, на която всяка е декларирана, и копирайки все още действащите връзки върху коренния елемент на фрагмента в момента, в който целта е достигната. Reader-ът върви с включено PreserveWhitespaceText, така че текстовите възли се връщат точно както са записани, а възстановените тагове ползват TXMLReader.RawName и TXMLReader.Attribute[I].RawName — правописа на префикса от файла — вместо каноничните имена, които reader-ът нормално подава на частните парсери. Ето ядрото на цикъла:
// Namespaces: TStringList от 'xmlns:p=uri' с деклариращата дълбочина в Objects[]
while Reader.Read do
begin
  if CaptureDepth >= 0 then
    XlsxAppendRawXmlReaderNode(Result, Reader);   // елемент, текст, CDATA, коментар
  if Reader.NodeType = xmlntElement then
  begin
    for I := 0 to Reader.AttributeCount - 1 do
    begin
      AttrName := Reader.Attribute[I].RawName;
      if (AttrName = 'xmlns') or (Pos(WideString('xmlns:'), AttrName) = 1) then
        Namespaces.AddObject(String(AttrName) + '=' + String(Reader.Attribute[I].Value),
          TObject(NativeInt(Depth)));
    end;
    if (CaptureDepth < 0) and (Reader.Name = 'table:data-pilot-tables') then
    begin
      Opening := XlsxRawXmlReaderOpenTag(Reader);   // обелвай завършващото '>' или '/>' първо
      ...
      // Пренеси ефективните ancestor връзки върху корена на фрагмента.
      for I := Namespaces.Count - 1 downto 0 do
      begin
        AttrName := WideString(Namespaces.Names[I]);
        if Seen.IndexOf(String(AttrName)) >= 0 then Continue;   // най-вътрешната връзка печели
        Seen.Add(String(AttrName));
        if not Reader.HasAttribute(AttrName) then               // вече декларирано тук? пропускай
          Opening := Opening + ' ' + AttrName + '="' +
            XlsxEscapeAttr(WideString(Namespaces.ValueFromIndex[I])) + '"';
      end;
      ...
      CaptureDepth := Depth;
    end;
    if not Reader.IsEmptyElement then Inc(Depth);
  end
  else if Reader.NodeType = xmlntEndElement then
  begin
    Dec(Depth);
    if Depth = CaptureDepth then Exit;                           // поддървото се затвори
  end;
  if (Reader.NodeType = xmlntEndElement) or
     ((Reader.NodeType = xmlntElement) and Reader.IsEmptyElement) then
    while (Namespaces.Count > 0) and
          (NativeInt(Namespaces.Objects[Namespaces.Count - 1]) >= Depth) do
      Namespaces.Delete(Namespaces.Count - 1);                   // напусни scope-а
end;
if CaptureDepth >= 0 then
  raise Exception.Create('OpenDocument pivot definition ended inside an element');
Три детайла в този цикъл носят коректността. Обхождането на стека от най-вътрешната връзка навън и запомнянето на всеки префикс в Seen имплементира shadowing: ако по-близък ancestor пререгильтерира xmlns:table, по-близката стойност печели — точно както §6.1 изисква. Прескачането на префикси, които елементът вече декларира сам, избягва излъчването на същия атрибут два пъти, което би било друга well-formedness грешка. А pop правилото светва на end тагове и на празни елементи, защото <x/> никога не произвежда събитие EndElement — същият самозатварящ се капан, на който се научи XLSX extLst улавянето. Съпоставянето на целта по Reader.Name, а не по RawName, е по-тиха печалба: reader-ът канонизира ODF table namespace URI-то до префикса table, така че producer, който го изпише t:data-pilot-tables, пак съвпада, докато излъченият фрагмент запазва каквото и да е изписване на префикса producer-ът е ползвал
Цикълът освен това отказва да гадае. Ако частта свърши, докато улавянето е още отворено — отрязан или повреден content.xml — OdsCaptureDataPilotTablesXml вдига exception, вместо да върне половин фрагмент, защото половин фрагмент щеше да бъде записан обратно при запис и щеше да превърне повреден вход в повреден изход с името на библиотеката върху него
Къде каца фрагментът в записания content.xml?
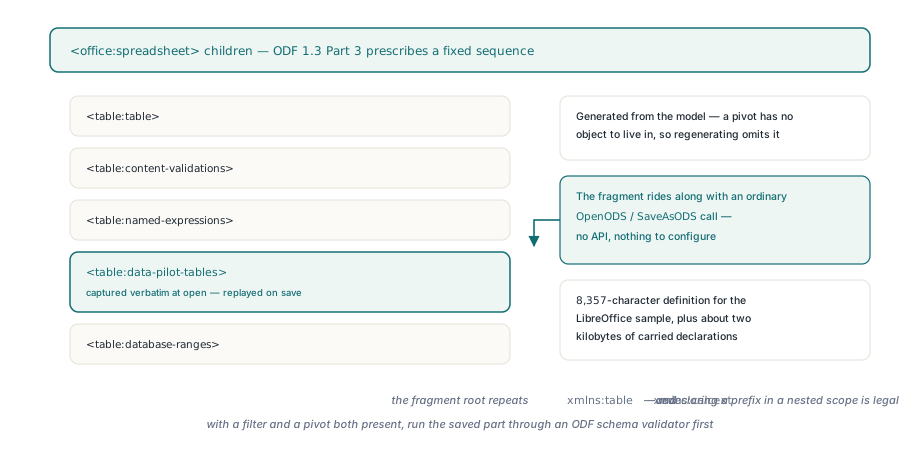
HotXLS записва уловения фрагмент в <office:spreadsheet> веднага след генерирания от него <table:named-expressions> и пред <table:database-ranges>. Content моделът на <office:spreadsheet> в ODF 1.3 Part 3 предписва фиксирана последователност за тези последващи деца, така че дословен блок не може просто да се долепи там, където writer-ът случайно се намира; той трябва да бъде пуснат в конкретен слот. От страната на caller-а няма API и няма какво да се конфигурира; дефиницията пътува заедно с обикновено отваряне и запис:
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.OpenODS('official-pivot.ods') <> 1 then
      raise Exception.Create('open failed');
    Book.Sheets[0].Cells[2, 5].Value := 1250.0;   // редакция вътре в source диапазона на pivot-а
    Book.SaveAsODS('official-pivot-out.ods');
    // content.xml в изхода все още носи DataPilot1 със своя
    // source диапазон, полета, target диапазон, бутони и loext:/calcext: атрибути
  finally
    Book.Free;
  end;
end;
Излишъкът е умишлен и си заслужава да се знае. Коренът на фрагмента вече повтаря xmlns:table и xmlns:calcext, макар коренът на записания документ да ги декларира също; Namespaces in XML позволява пререгистриране на префикс във вложен scope, така че дубликатите са безвредни. За LibreOffice примера пренесеният набор са всичките трийсет и пет root декларации — около два килобайта върху 8 357-знаковата дефиниция — защото улавянето не анализира кои префикси поддървото действително ползва. Сканиране на ползвани префикси би ги съкратило и може да дойде по-късно; първо коректност, после компактност
Правило за отрязване на поддърва от XML за дословен replay
Общият урок е, че поддърво е самоцялостно само след като сте го направили такова, а namespace scope е първото нещо, което се чупи, когато забравите. Чеклистът, който HotXLS вече прилага за всяко улавяне от типа „пазете това, което не моделираме“:
- Обхождайте документа с истински reader и следете връзките in scope. String търсене с
Posизобщо не вижда scope, и освен това се засича на вложени елементи със същото име, на съвпадащ string в коментар илиCDATAсекция и на атрибути стойности, които случайно съдържат текста на тага - Копирайте ефективните връзки върху корена на фрагмента, най-вътрешните първо, веднъж на префикс, пропускайки каквото коренът вече декларира
- Пазете суровото изписване на префикса в излъчените тагове; съпоставяйте целта по разрешен namespace, не по буквален префикс
- Запазвайте whitespace текстовите възли и помнете, че празен елемент затваря собствения си scope без end-tag събитие
- Валидирайте записаната част с парсер, който не е библиотеката под тест. Библиотеката ще препрочете собствения си изход с удоволствие през същия снизходителен code path, който го е записал
Последната точка е тази, която действително намери HXLS-003 втория път. Acceptance проверката на v2.382.0 беше регулярен израз, броящ начални тагове data-pilot-table в записания content.xml, а регулярен израз вижда таг, не документ — той е сляп дали префиксите на този таг са обвързани. Строгият corpus runner, добавен във v2.382.1, парсва всяка XML и .rels част на записания пакет с namespace-aware парсер и после сравнява pivot дървото — таг, сортирани атрибути, текст, деца, рекурсивно — с оригинала. Това сравнение е namespace-разширено, така че преименуван префикс пак минава, а необвързан не може
Къде свършва дословната гаранция
Дословният replay запазва дефиниция; той не я разбира, а границите следват от това. HotXLS не излага API за четене, редактиране или освежаване на ODS pivot, така че FRawOdsDataPilotTablesXml е вътрешно поле и единственото наблюдаемо поведение е, че дефиницията оцелява. Фрагментът се ресериализира от reader събития, не се копира като байтове: кавитирането на атрибути и самозатварящите се форми се нормализират, докато текст и whitespace се пазят. Уловеният XML се излъчва само от ODS content writer-а, така че работна книга, отворена от .ods и записана като .xlsx, губи pivot-а, а работна книга, отворена от .xlsx, няма какво да възпроизведе в .ods запис — асиметриите на ODS импорт и export пътищата важат тук както навсякъде. И защото дефиницията е непрозрачна, тя не може да следва вашите редакции: преименувайте Sheet1 или преместете source данните в HotXLS, а записаният pivot все още сочи към Sheet1.A2:E30, оставяйки на consumer-а да докладва счупен диапазон при следващото му refresh. Едно предупреждение за подредба също принадлежи тук: HotXLS излъчва AutoFilter диапазони като <table:database-ranges> след pivot фрагмента, а corpus примерът не носи database диапазон, така че работна книга и с филтър, и с pivot трябва да се прекарате през ODF schema валидатор, преди да разчитате на относителния ред на тези два елемента
Тествайте с файловете на собствения си producer, не само с corpus примера. Namespace пренасянето се справя с всеки префикс, който producer декларира на ancestor, но документ, който декларира префикс върху самия pivot елемент, или който ползва default namespace за table речника, упражнява skip и shadowing клоните, които LibreOffice примерът не упражнява. И двете са имплементирани; нито едното няма пример в corpus-а още, и точно това разграничение е нещото, което changelog запис има тенденцията да замъгля
Дословното data pilot улавяне във v2.382.0 и namespace-scope поправката във v2.382.1 се доставят в текущия HotXLS Delphi Excel Component, чиято продуктова страница изброява пълното ODS, XLSX и XLS read-write покритие за Delphi и C++Builder