HotXLS Delphi Component оценява =1<2<3 като FALSE — същият отговор, който дава Excel 16, защото от v2.384.3 нататък formula parser-ът му сгъва операторите за сравнение отляво надясно: 1<2 става TRUE, а TRUE<3 е FALSE, защото boolean е над всяко число. Същият release прави празен операнд равен едновременно на 0 и на "" и позволява на SUMIF да разтегне едноклетъчен sum range до формата на criteria range-а. Всяко от тези неща изглежда дреболия, докато работна книга, сметната в Delphi, не се размине със същата книга, отворена в Excel
Разминаването обикновено започва с формула, написана по интуиция. Някой пише =0<B2<100, за да провери, че количество е в диапазона, Excel тихо отговаря FALSE за всеки ред и листът заминава с вградения бъг. Едно calculation engine няма право да оправя замисъла на потребителя; работата му е да извади стойността, която би извадил Excel, така че кешираният резултат, който HotXLS записва във файла, да съвпада с онова, което Excel показва след recalculation. Преди v2.384.3 HotXLS отговаряше TRUE за тази проверка на диапазона на всеки ред — грешно в обратната посока — и отчет, генериран на сървър, се разминаваше със същия отчет, отворен на desktop
Защо =1<2<3 връща FALSE в Excel?
Excel връща FALSE, защото чете верига от сравнения като (1<2)<3, а вътрешното TRUE после губи надпревата по типова рангова класация срещу числото 3. Старият HotXLS parser четеше същия текст като 1<(2<3): TXLSSyntax.Parse_expr в lxFormula.pas парсваше един операнд, виждаше token за сравнение и се рекурсираше в Parse_expr за дясната страна, което прави оператора right-associative. Това дава 1<TRUE, а числото е под boolean-а, така че резултатът беше TRUE. Грешката е симетрична: =3>2>1 е TRUE в Excel и беше FALSE в HotXLS, а =1=1=TRUE е TRUE в Excel и беше FALSE преди fix-а. Регресионният тест CalculateFormula_ComparisonChainsFoldLeftToRight закача седем такива формули към стойностите, които Excel 16 връща, и пуска всяка през двете engine архитектури — класическия TXLSWorkbook и XLSX-нативния TXLSXWorkbook — чрез метода Calculate, описан в прегледа на formula engine-а на HotXLS
const
  Formulas: array [0..6] of string = ('=1<2<3', '=3>2>1', '=(1<2)<3',
    '=1<(2<3)', '=1=1=TRUE', '=3>2>1=TRUE', '=1<2<3=FALSE');
  // Какво връща Excel 16:  FALSE, TRUE, FALSE, TRUE, TRUE, TRUE, TRUE
var
  Classic: IXLSWorkbook;
  Xlsx: TXLSXWorkbook;
  i: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Xlsx := TXLSXWorkbook.Create;
  try
    // TXLSXWorkbook.Calculate оценява спрямо активния лист и
    // връща Null, когато работната книга изобщо няма лист
    Xlsx.Sheets.Add('Data');
    for i := 0 to High(Formulas) do
      Writeln(Formulas[i], '  classic=', VarToStr(Classic.Calculate(Formulas[i])),
        '  xlsx=', VarToStr(Xlsx.Calculate(Formulas[i])));
  finally
    Xlsx.Free;
  end;
end;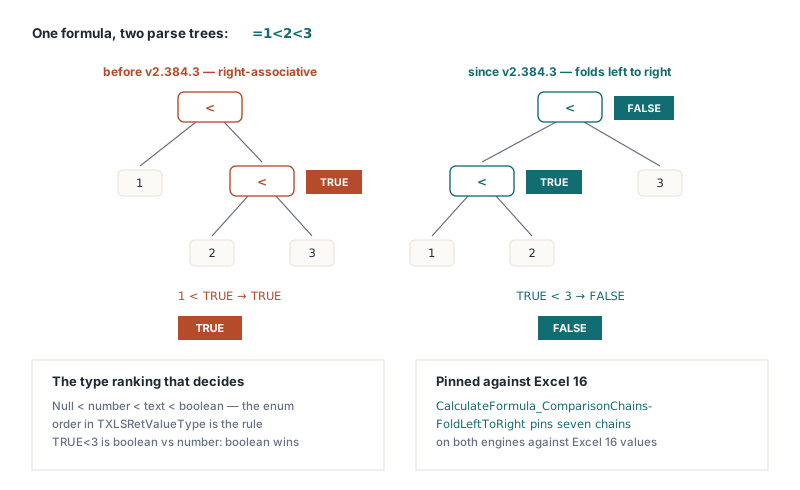
Fix-ът превръща Parse_expr в цикъл със същата форма, каквато Parse_expr1 вече ползва за +, - и &. Той парсва първия операнд с Parse_expr1 и, докато следващият token е някой от =, <>, <, >, <= или >=, създава възел за сравнение, закача натрупания ляв резултат като първи наследник, парсва следващия операнд с Parse_expr1 вместо с Parse_expr и прави новия възел ляв резултат за следващия рунд. Две подробности лесно се объркват при превръщането на рекурсията в итерация и двете са в бележките на поддръжниците: натрупаният възел трябва да се предаде (lChild := Item; Item := nil) точно в този ред, а error пътят трябва да Exit-ва след освобождаване на полусградения възел, вместо да изпада от цикъла и да върне висящо дърво
Как HotXLS подрежда числа, текст и boolean-и при сравнение?
HotXLS подрежда смесените типове както Excel: всяко число е по-малко от всяка текстова стойност, а всяка текстова стойност е по-малка от всеки boolean. TXLSCalculator.CompareVariants в lxCalc.pas класифицира двата операнда с GetRetValueType в изброяването TXLSRetValueType = (xlVariantValue, xlNumberValue, xlStringValue, xlBooleanValue) и когато двата класа се различават, просто сравнява ординалите им, така че редът на декларация на този enum е правилото за различни типове. Вътре в един клас сравнението е естественото, с една екстра за текст в Excel стил: двата string-а минават първо през lxUpperCase, така че ="abc"="ABC" е TRUE. Именно тази класация е причината резултатът от веригата да не може да се изведе без нея. TRUE<3 не е коерция на TRUE към 1, а boolean, сравнен с число, и boolean-ът печели. Датите са serial numbers за engine-а (varDate се класифицира като xlNumberValue), така че дата винаги е под всеки текст, включително текст, който случайно прилича на дата
На какво се равнява празна клетка при сравнение?
Празна клетка, ползвана като операнд за сравнение, се равнява на 0, когато другата страна е число, на "", когато другата страна е текст, и от v2.384.53 на FALSE, когато другата страна е логическа стойност, така че при празна A1 =A1=0, =A1="" и =A1=FALSE са всички TRUE. TXLSCalculator.CompareVarValues, който обслужва всичките шест оператора за сравнение, замества празното преди да извика CompareVariants: ако точно един операнд е Null, той става WideString(''), когато партньорът му е string, False, когато партньорът му е boolean, и 0 в останалите случаи. Две празни и продължават да се равняват една на друга без заместване. Аритметичният път винаги е превръщал празното в 0 — затова =A1+1 даваше 1 — но CompareVariants държеше Null като собствен най-нисък ранг, под всяко число, а операторите за сравнение ползваха този ранг директно
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;
  Sh.Range['B1', 'B1'].Value := 5;      // A1 е оставена празна нарочно

  Writeln(VarToStr(Wb.Calculate('=A1=0')));    // True
  Writeln(VarToStr(Wb.Calculate('=A1=""')));   // True
  Writeln(VarToStr(Wb.Calculate('=A1<B1')));   // True: празното се сравнява като 0
  Writeln(VarToStr(Wb.Calculate('=A1<0')));    // False; True преди v2.384.3
end;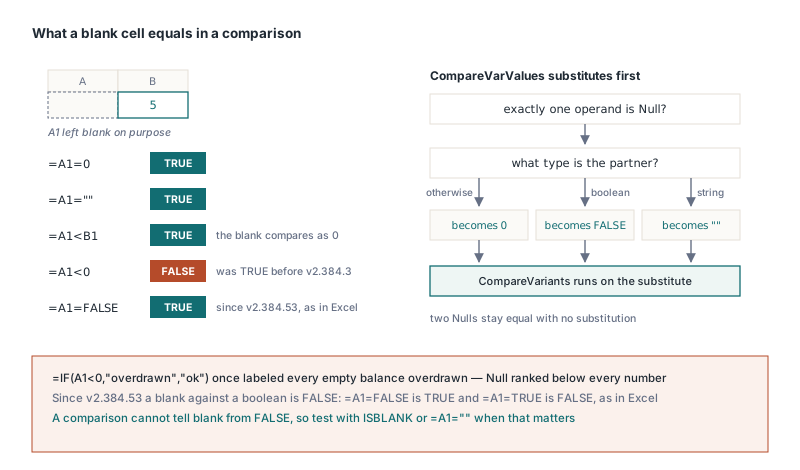
Последният ред е този, който боли на практика. При стария ранг празното беше по-малко от всяко число, включително отрицателните, така че =IF(A1<0,"overdrawn","ok") залепяше етикета overdrawn на всяка празна клетка с баланс, а =A1=0 беше FALSE за клетка, която всеки потребител би описал като нула. Една граница остана след v2.384.3: заместването избираше само между 0 и празния string, така че празно, сравнено с boolean, ставаше 0, което е под TRUE и под FALSE, и =A1=FALSE на празна A1 излизаше FALSE. От HotXLS 2.384.53 празно, сравнено с логическа стойност, се третира като FALSE и в двата engine-а, XLS и XLSX, както прави Excel: при празна A1 =A1=FALSE и =A1<TRUE връщат TRUE, а =A1=TRUE връща FALSE. Това също означава, че сравнението не може да разграничи празно от FALSE — нито в Excel, нито в HotXLS; когато листът има нужда от това разграничение, тествайте с ISBLANK или =A1=""
Защо SUMIF с едноклетъчен sum range връщаше 0?
SUMIF връщаше 0, защото HotXLS склейваше итерацията към по-малкия от двата диапазона, докато Excel пази формата на criteria range-а и ползва sum range-а само за горната му лява клетка. =SUMIF(A1:A10,">5",B1) значи следователно B1:B10 в Excel — удобство, на което разчитат много ръчно направени шаблони. Споделеният worker TXLSCalculator.GetValueItemRange2 свиваше броя редове и колони до тези на value range-а, което свеждаше примера до единствена проверка на A1 срещу B1. v2.384.3 маха склейването: цикълът вече минава през criteria range-а и чете всяка стойност на същото отместване от горния ляв ъгъл на sum range-а. Понеже CalcSumIF и CalcAverageIF викат този worker, AVERAGEIF получава същото разтягане, а sum range, по-голям от criteria range-а, се отрязва до формата на критерия по същата причина. Аргументът за критерий в средата е от value клас, а двата външни са от reference клас — разграничението, разгледано в статията за implicit intersection и класовете на аргументите
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Sales');
    for Row := 1 to 10 do
    begin
      Sheet.Cells[Row, 1].Value := Row;          // criteria колона: 1..10
      Sheet.Cells[Row, 2].Value := Row * 100;    // суми: 100..1000
    end;
    Sheet.Cells[1, 4].Formula := '=SUMIF(A1:A10,">5",B1)';     // едноклетъчен sum range
    Sheet.Cells[2, 4].Formula := '=SUMIF(A1:A10,">5",B1:B10)'; // изричен sum range
    if Book.Recalculate = lxOk then
      // И D1, и D2 са 4000 (600+700+800+900+1000); D1 беше 0 преди v2.384.3
      Writeln(VarToStr(Sheet.Cells[1, 4].Value), ' ', VarToStr(Sheet.Cells[2, 4].Value));
  finally
    Book.Free;
  end;
end;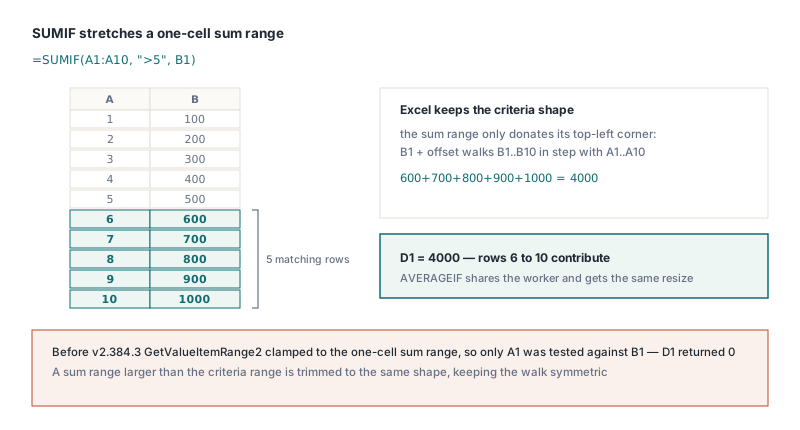
INDIRECT и YEARFRAC: две по-тихи корекции
INDIRECT вече отчита втория си аргумент, а текст след валидна референция е грешка вместо да се игнорира. При a1 FALSE текстът се парсва като абсолютен R1C1, така че =INDIRECT("R2C3",FALSE) чете C2; старият код игнорираше флага, четеше "R2" като колона R, ред 2 и тихо връщаше грешната клетка. Флагът се разпределя по variant типа си (boolean, число или текст), защото директната конверсия на string variant към Double вдига exception. Относителен R1C1 текст като R[1]C[1] връща #REF!, тъй като INDIRECT няма произход от формула-клетка, спрямо който да го разреши, а A1 текст със символи в края, "B2 junk", също връща #REF!. YEARFRAC с basis 0 вече прилага NASD правилата за последния ден на февруари, които DAYS360 вече беше имплементирал: когато и двете дати са последния ден на февруари, крайният ден става 30, а после начало на последния ден на февруари също става 30. От 2024-02-29 до 2025-02-28 броят вече е 360 дни — дроб точно 1, докато предишният Days360US броеше 359
Какво гарантират тези fix-ове и какъв беше урокът?
Поведението на верижните сравнения е гарантирано от тест, който сравнява и двата engine-а със стойности, измерени в Excel 16, а този тест съществува, защото първото описание на fix-а беше грешно. Release бележката на v2.384.3 първоначално казваше, че ляво-дясното сгъване прави =1<2<3 TRUE — точно това, което произвеждаше старият right-associative parser, и обратното на онова, което връщат и Excel, и новият код. Никой не беше изчислил примера; написан беше от интуицията, че „1 е по-малко от 2, което е по-малко от 3“. Бележката беше коригирана, а тестът със седем формули беше добавен в последвал commit, и правилото, излязло оттам, важи за всеки, който документира семантиката на електронни таблици: пуснете примера в Excel, преди да запишете очакваната стойност. Заместването на празния операнд и разтягането на SUMIF следват същото поведение на Excel, включително случая празно-срещу-boolean от v2.384.53 нататък, а условните агрегати, които трябва и да прескачат филтрирани или скрити редове, следват отделните правила в статията за SUBTOTAL и AGGREGATE и скритите редове
HotXLS е нативен spreadsheet компонент за Delphi и C++Builder, който чете, преизчислява и записва XLS, XLSX, ODS и CSV без инсталиран Excel, а правилата за сравнение, празното и SUMIF, описани тук, живеят в calculation engine-а, който споделят двете workbook архитектури. Пълният списък с функции и лицензионните опции са на продуктовата страница на HotXLS Delphi spreadsheet компонента