Когато PDF не вгражда шрифт, HotPDF компонентата рендира този текст с инсталиран Windows шрифт, избран от HPDFMapBaseFontToSystem: тя декодира името /BaseFont, отрязва стиловата част, пробва няколко изписвания, докато GDI потвърди, че семейството е инсталирано, мери липсващите ширини на стандартните 14 от метрично съвместими шрифтове и превръща еднобайтовите кодове в Unicode преди чертане. Всяка от тези стъпки съществува, защото наивната версия се проваляше на реални файлове. Page renderer-ът RenderLoadedPageToBitmap се справя добре с вградени програми; това е историята на шрифтовете, които изобщо не са във файла
Защо GDI тихо рисува грешния шрифт за невграден шрифт?
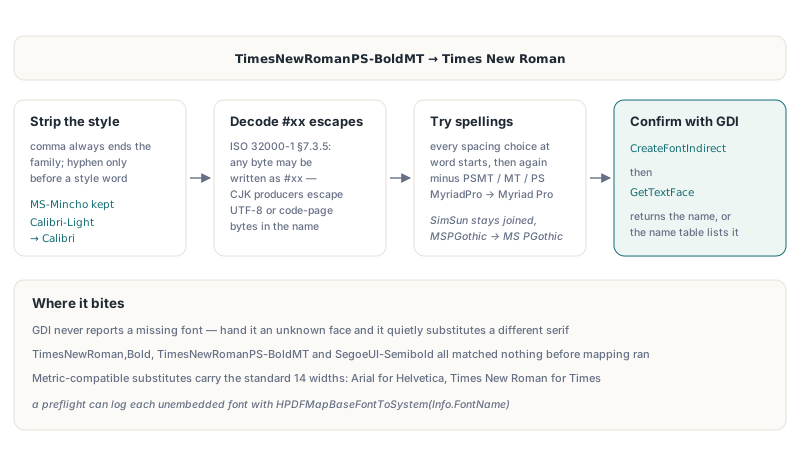
GDI никога не докладва липсващ шрифт: подайте на CreateFontIndirect име на шрифт, което не познава, и той тихо избере заместител — често друг serif без bold тежест. Ранният renderer подаваше PDF името почти дословно, така че TimesNewRoman,Bold, TimesNewRomanPS-BoldMT и SegoeUI-Semibold всички не съвпадаха с нищо и излизаха в каквото GDI беше избрало. Имена могат да са и по-лоши. ISO 32000-1 §7.3.5 позволява име да запише всеки байт като #xx, а CJK производители редовно изписват имена на шрифтове като екраниран UTF-8 или байтове от legacy code page; преди v2.766.69 самите екранирания ставаха името на шрифта. HPDFMapBaseFontToSystem вече декодира първо екраниранията, връща валидна UTF-8 байтова последователност като своите символи и чете всички други високи байтове в системния code page
Отрязването на стила е мястото, където хевристиката хапе. Запетая винаги приключва семейството (Arial,Bold дава Arial), но тире — само когато думата след него е стил: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra или Condensed. Това правило пази MS-Mincho цял, докато превръща Calibri-Light в Calibri. HotPDF после пробва изписвания на семейството, следвани от изписвания на семейството с махнат суфикс PSMT, MT или PS. От v2.768.18 тези изписвания покриват всеки избор на интервали на местата, където дума може да започне: пред главна буква, следвана от малка (MyriadPro става Myriad Pro), на последната главна на пасаж, следван от малка буква (UIGothic), и след водещо MS (MSPGothic), от напълно разредената форма до името, както е записано; след четири такива места се пробват само напълно разреденото и слепеното име. Разредяване не може да се прилага сляпо, защото Windows държи някои думи слепени: SimSun е инсталиран точно с тази изписка, докато MicrosoftYaHei, MicrosoftJhengHei и MSPGothic принадлежат на Microsoft YaHei, Microsoft JhengHei и MS PGothic. Преди v2.768.18 mapper-ът слагаше интервал пред всяка вътрешна главна буква, така че MicrosoftYaHei се търсеше като Microsoft Ya Hei и никога не се намираше. Кандидат се брои за инсталиран, когато CreateFontIndirect, последвано от GetTextFace, върне поисканото име, или — от v2.768.18 — когато name таблицата на избрания шрифт го изброява като семейство, пълно или типографско име на семейство на всеки език; отговорът се кешира на име, така че документи с много неинсталирани шрифтове вече не сондат Windows за всяко име на всяка страница
Понеже мапващата функция е публична в юнита HPDFRenderFontMetrics, preflight доклад може да покаже с кое инсталирано семейство ще се рендерира всеки невграден шрифт, ползвайки изброяването на шрифтове, което THotPDF вече излага за заредени документи:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Как HotPDF мери стандартните 14 шрифта, които нямат /Widths?
HotPDF мери липсващите advance-и на инсталирания шрифт със същите метрики, защото ISO 32000-1 §9.6.2.2 позволява на стандартните 14 шрифта да пропускат /Widths, а библиотеката не доставя AFM таблици. Arial носи метриките на Helvetica, Times New Roman носи Times, а Courier New носи Courier, така че HPDFMeasureBaseFontWidths създава съответното лице при lfHeight = -1000 и вика GetCharWidth32W; на тази височина резултатът вече е в 1/1000 em единиците, които PDF ширините ползват. Renderer-ът първо превръща всеки код в Unicode чрез /Encoding, /BaseEncoding и /Differences, с подразбиране StandardEncoding. SVG експортът и извличането на текст удрят още един капан: стандартен Type 1 шрифт без никакъв /Encoding произвеждаше декодер без информация за кодировка, SVG експортът никога не го регистрираше и всяка мерена ширина отиваше напразно. Поддането на подразбиращото се StandardEncoding го оправи, при условие че е маркирано като предварително дефинирана кодировка; маршрутизирането му по CMap-имения път декодира всеки код като 0 и всяка ширина тръгва след него
Bold, italic и отместване с едно във флаговете на font descriptor
Записът /Flags на font descriptor номерира битовете си от 1, не от 0, така че ForceBold е бит 19 ($40000), а Italic е бит 7 ($40), по ISO 32000-1 Table 123. Старият код тестваше $20000, което е бит 18, SmallCap. Грешката оцеля от v2.345.0 до v2.766.53, защото /FontDescriptor е почти винаги indirect референция, а font строителят четеше само директни обекти, така че целият клон с флагове изобщо не се пускаше, а същата слепота игнорираше /Widths 12 0 R и подреждаше текст с fallback advance от 500 единици. Щом v2.766.53 започна да разрешава indirect референции през renderer-а, битът трябваше да се поправи в същата промяна, иначе всяко лице с малки главни букви изведнъж щеше да се рендерира bold:
const
  // ISO 32000-1 Table 123 брои бит позиции от 1
  FD_ITALIC     = $00040;  // бит 7
  FD_SMALLCAP   = $20000;  // бит 18, не е тежест
  FD_FORCEBOLD  = $40000;  // бит 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;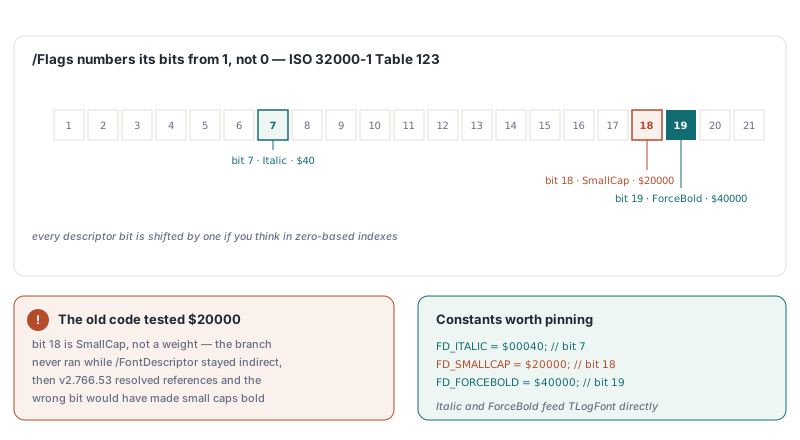
Защо CJK шрифтове с UCS2 CMap получават грешните ширини?
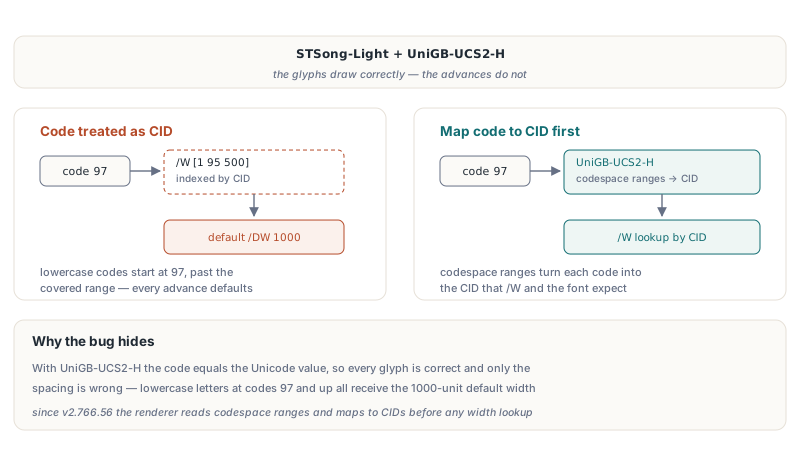
CJK текст с предварително дефиниран UCS2 CMap рисува правилните глифи, но грешните разстояния, когато renderer третира кода като CID, защото /W е индексиран по CID, не по символен код. С STSong-Light и UniGB-UCS2-H кодът случайно съвпада със стойността Unicode, така че GDI рисува правилните знаци и бъгът се крие в advance-ите: малки букви пристигат като кодове 97 и нагоре, падат извън запис /W като [1 95 500] и всички получават подразбиращата се ширина /DW от 1000. От v2.766.56 HotPDF renderer-ът чете кодовете през codespace диапазоните на CMap (ISO 32000-1 §9.7.6.2) и ги мапва към CIDs, преди да търси ширини. Ползват се само вградените UCS2 и UTF16 таблици и вградени CMap stream-ове; identity приближение за нещо като GBK-EUC-H би изглеждало поддържано, докато произвежда грешен изход, така че renderer-ът не се преструва
Защо ударените знаци се превръщат във въпросителни на китайски Windows?
Еднобайтови кодове никога не бива да стигат до ANSI („A") GDI функциите, защото GetGlyphOutlineA и GetGlyphIndicesA интерпретират байтовете в системния code page, докато TextOutA ползва знаковия набор на избрания шрифт. На китайска система Arial байт $A9 (знакът за авторско право в Windows-1252) ставаше GBK водещ байт и се рендерираше като „?", капан, в който пътят с нехинтираните очертания, добавен в v2.766.83, влезе право. v2.767.3 пита реализирания шрифт за неговия знаков набор с GetTextCharset, превръща го в code page чрез TranslateCharsetInfo, прокарва байта през MultiByteToWideChar и вика W функциите; symbol шрифтове ползват U+F000 плюс кода вместо това. Кодировки, които не съвпадат с Windows-1252 — /Differences, StandardEncoding, MacRomanEncoding — се мапват към Unicode, преди някой системен шрифт да ги е видял
Какви са границите на чертането със системни шрифтове?
Рендирането със системни шрифтове е приближение и HotPDF компонентата е честна за това къде спира. Преди v2.768.18 инсталационната проверка сравняваше само името, което GetTextFace връща, а на локализиран Windows тази функция докладва името на семейството на системния език, така че Microsoft YaHei на китайски Windows или Yu Mincho на японски Windows се отсъждаха за липсващи и се чертаеха в GDI заместител; от v2.768.18 лице, върнало се под друго име, също се търси в name таблицата на шрифта и такива шрифтове се намират. Метричната съвместимост е гарантирана само за семействата Helvetica, Times и Courier; Symbol се мапва към Symbol, а ZapfDingbats към Wingdings, което е междинна кръпка, а не съвпадение. Preflight-ът по-горе вижда също само шрифтове в /Resources речника на всяка страница, не тези, сочени отвътре от form XObjects. Когато код пак не може да се нарисува, тракингът на нерешени глифи по време на чертане го докладва, което е по-добър сигнал от гледане на миниатюри с око
Трайната поправка е от страната на авторството. Самият HotPDF пише с FontEmbedding True по подразбиране, замествайки вграден Arial дори когато код вика SetFont с Helvetica, а вграденият текст минава през glyph renderer-а за вградени шрифтове вместо през някое от отгатванията по-горе. Евтина предпазна мярка за входящи файлове е да предупреждавате преди рендиране, когато мапнато семейство го няма в списъка на екранните шрифтове:
// VCL: Screen.Fonts изброява инсталирани имена на семейства (Forms unit)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
За пълната компонента — включително рендиране на страници, извличане на текст и font subsetting на страната на записа — вижте продуктовата страница HotPDF Delphi PDF компонента