Когато HotPDF Delphi Component зарежда PDF 1.5 файл с LoadFromFile, той не парсва обектите, опаковани в /Type /ObjStm контейнери. Записва къде живее всеки компресиран член и го парсва едва когато някое нещо го поиска. Именно този мързелив инвариант пази времето за зареждане пропорционално на това, което наистина пипате, и е и причината пълното пренаписване да трябва да свърши една допълнителна работа, преди някой байт да излезе: да разшири всеки член, който още не е парснат, защото пренаписването предстои да изхвърли контейнерите, в които тези членове живеят
Симптомът, който мотивира тази бележка, е лесен за описание и неприятен за дебъгване. Заредете файл, чиито шрифтове, цветови пространства и structure tree седят в object stream-ове, пуснете го през генериращата двойка BeginDoc и EndDoc, и изходът се отваря без оплаквания. Броят страници е верен, текстът се вижда на страниците, които проверявате наум. После колега отваря страница 40 и телесният текст се рендира в заместен шрифт, или командата Extract Text връща боклук там, където някога беше ActualText замяна. Нищо не крашна. Writer-ът просто е сериализирал обект, който никога не е бил зареждан, а незареден обект се сериализира като нищо
Какво всъщност пази LoadFromFile за компресиран обект?
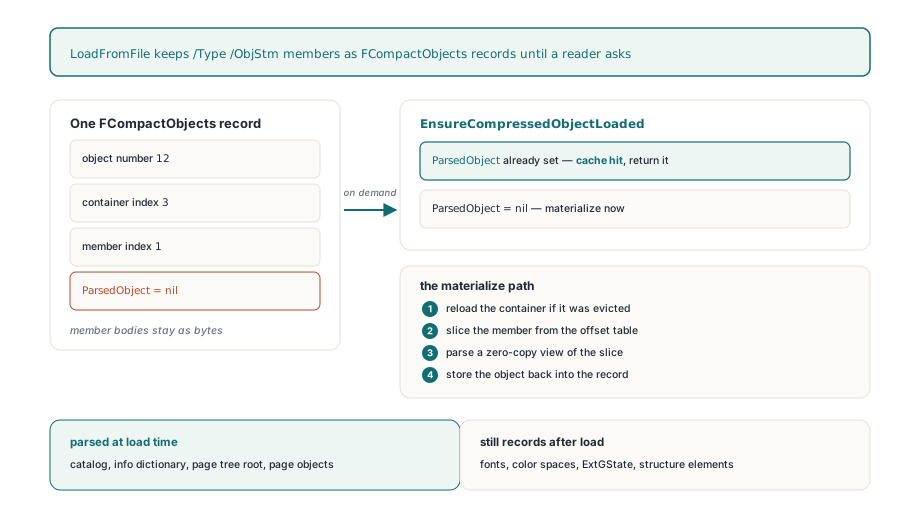
За всеки тип-2 cross-reference запис LoadFromFile пази малък запис в FCompactObjects: номера на обекта, индекса на съдържащия stream в контейнерната таблица, позицията на члена вътре в този stream и ParsedObject пойнтер, който започва като nil. Самият контейнер е локализиран, декриптиран, ако документът е криптиран, и раздут (inflate), но телата на членовете остават като байтове. ISO 32000-1 §7.5.7 дефинира оформлението на контейнера, което прави това възможно: хедър от двойки номер-на-обект и отместване, после телата на членовете, слепени след /First, така че всеки отделен член може да бъде изрязан, без да се пипат съседите му
EnsureCompressedObjectLoaded е единственият път, който превръща запис в обект. Намира записа по номера на обекта, и ако ParsedObject вече е зададен, връща кеширания обект и брои cache hit. Иначе презарежда контейнера, ако е бил изхвърлен, изчислява байтовия диапазон на члена от offset таблицата, подава на парсера zero-copy изглед на този отрязък и записва резултата обратно в записа. Оттам нататък обектът е indirect, носи истинския си номер на обект и е регистриран в обектния индекс на документа като всеки обект, парснат от тялото на файла. Каталогът, info речникът, коренът на page tree и page обектите минават през този път при зареждане, защото навигацията се нуждае от тях. Шрифтове, цветови пространства, ExtGState речници и structure елементи — не, и те остават като записи, докато ги пипне рендиране на страница или пренаписване
Можете да наблюдавате това отвън. GetLoadedObjectStreamCacheInfo докладва колко контейнера съществуват, колко члена са индексирани и колко от тях са парснати дотук:
var
  Pdf: THotPDF;
  Info: THPDFObjectStreamCacheInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('tagged-report.pdf');
    if Pdf.GetLoadedObjectStreamCacheInfo(Info) then
      Writeln(Format('%d containers, %d members indexed, %d parsed so far',
        [Info.ContainerCount, Info.IndexedObjectCount,
         Info.MaterializedObjectCount]));
  finally
    Pdf.Free;
  end;
end;
Върху файл, тежък на структура, третото число е малка част от второто веднага след зареждане. Тази разлика е целият смисъл на мързеливото зареждане, и е също точно множеството от обекти, за които едно пълно пренаписване трябва да се върне
Защо пълното пренаписване губи шрифтове, които инкременталният запис пази?
Пълното пренаписване изхвърля /ObjStm и /XRef контейнерите на изходния файл и пре-сериализира обектната графа от нулата, така че всеки член, чийто ParsedObject все още е nil, няма останало представяне в изхода. Инкременталната актуализация никога няма този проблем, защото добавя нови обекти след оригиналните байтове и оставя старите контейнери на място, за да ги адресира предишната cross-reference секция. Разликата не е в това как двата режима третират шрифтовете. Тя е в това дали оригиналните контейнери оцеляват, за да бъдат прочетени от следващия viewer
Поправката живее в SaveToStream, сериализатора, който EndDoc задвижва дали сте задали FileName или OutputStream. Преди да се диспечне към кой да е writer клон, той обхожда FCompactObjects и вика EnsureCompressedObjectLoaded върху всеки запис. Ако един член не може да бъде зареден, записът вдига изключение вместо да продължи, защото пренаписване, което тихо изпуска шрифтов речник, е по-лошо от едно, което спира. Разширяването трябва да седи на това ниво, над класическия, пакетирания и линеаризирания клон, и над кастренето на презаредени структурни stream-ове в линеаризирания маршрут. По-ранна версия разширяваше членовете само вътре в SaveLoadedDocument, което покриваше речника на зареден документ и пропускаше изцяло речника на генерацията. LoadFromFile, следван от BeginDoc, редакции на страници и EndDoc, отиваше направо при writer-а с всеки нетрогнат член все още непарснат
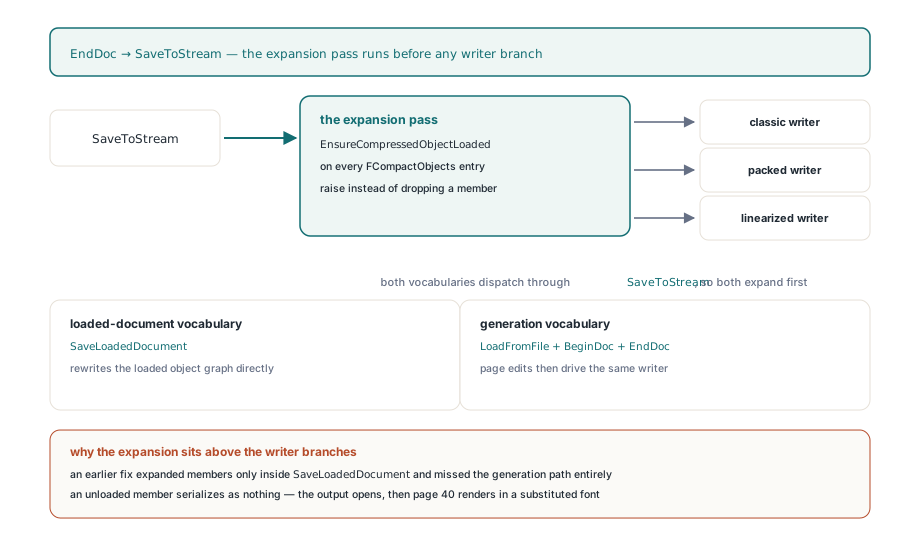
// И двата начина за пренаписване вече разширяват compact членовете преди writer.
// Път на зареден документ:
Pdf.LoadFromFile('quarterly.pdf');
Pdf.SaveLoadedDocument('quarterly-rewritten.pdf');

// Generation път върху зареден файл:
Pdf.LoadFromFile('quarterly.pdf');
Pdf.FileName := 'quarterly-stamped.pdf';
Pdf.BeginDoc;
Pdf.CurrentPage.SetFont('Arial', [], 9);
Pdf.CurrentPage.TextOut(40, 20, 0, 'Reviewed 2026-09-11');
Pdf.EndDoc;   // SaveToStream материализира всеки FCompactObjects запис първо
Кешираните членове пазят каквото сте им направили. Обект, който е бил парснат, редактиран и маркиран dirty преди записа, се връща от кеша с редакциите си, а член, който сте изтрили, пази състоянието си на изтрит през повтарящи се записвания. Разширяващият проход е идемпотентен по конструкция: той само запълва nil слотове
Защо пикселните проверки на три страници пропускат случая ActualText
Structure елементите са мястото, където този бъг се крие най-дълго. ActualText запис върху marked-content последователност, дефиниран в ISO 32000-1 §14.9.4, замества глифовете за извличане и достъпност, но не влияе на рендирането. Ако structure елементът живее в object stream и пренаписването го загуби, страницата все още се рисува коректно, първата, средната и последната страница се сравняват пиксел по пиксел с източника, а регресията се показва чак когато някой пусне извличане на текст или screen reader. Тест за пренаписване, който само рендира страници, не е тест за пренаписване на тагнат PDF. Дифнете и извлечения текст, и structure tree-то
Как празна потребителска парола променя зареждането?
Празна потребителска парола все още означава, че файлът е криптиран, а object stream-овете в такъв файл са шифротекст, докато file ключът бъде възстановен. ISO 32000-1 §7.6.3.4 Алгоритъм 2 извежда този ключ от паролата, /O записа, /P и първия идентификатор на документа, а HotPDF трябва да го изпълни върху празния стринг, преди тип-2 проходът да може да раздуха един-единствен контейнер. Затова BeginDoc върху зареден криптиран документ вика DecryptLoadedDocument с празна парола преди всичко друго: обектната графа трябва да бъде аутентикирана и декриптирана, преди пренаписването да започне, без значение дали извикващият възнамерява да защити изхода. Изходното криптиране е отделно решение, водено от настройките за защита на извикващия, а BeginDoc възвръща тези настройки след decrypt прохода, така че криптиран вход не се превръща тихо в криптиран изход
Политиката за контейнери се чете от /Encrypt речника, преди да бъде пробвана каквато и да е парола. За /V 1 и 2 всеки stream е криптиран с file ключа. За crypt филтри HotPDF resolve-ва /StmF през /CF: Identity филтър или /CFM на None означава plaintext контейнери, докато V2 и AESV2 означават криптирани. Отговорът отива в FReloadObjectStreamsEncrypted, и има значение за един конкретен случай. Когато контейнерите са plaintext, но стринговете не са, членовете носят криптирани стрингове, които трябва да се декриптират поотделно, затова MaterializeMembersOfPlaintextObjectStreams разширява всеки compact член преди per-object decrypt прохода. Тя не прави нищо, когато политиката още не е известна, и нищо, когато самите контейнери са били криптирани, защото членовете на криптиран контейнер вече са декриптирани с него и никога не бива да се декриптират втори път
Какво става, когато контейнер не може да бъде декриптиран?
Контейнер, който провали декрипцията, отива в карантина, не е фатален. Тип-2 проходът записва THPDFObjStmQuarantineInfo запис в FObjStmQuarantine с номера на обекта на контейнера, THPDFObjStmQuarantineReason, диагностичен стринг и списъка с номера на member обекти, които cross-reference-ът беше насочил към него. osqrDecryptFailed се вдига за четири различни ситуации: нито един crypt филтър не може да бъде resolve-нат, AES-256 или AES-GCM декриптът е хвърлил, legacy RC4 или AES-128 декриптът е хвърлил, или изобщо не съществува използваем file ключ. Независими контейнери продължават да се зареждат, така че документ с един повреден контейнер все още се отваря и все още рендира всяка страница, която не зависи от него
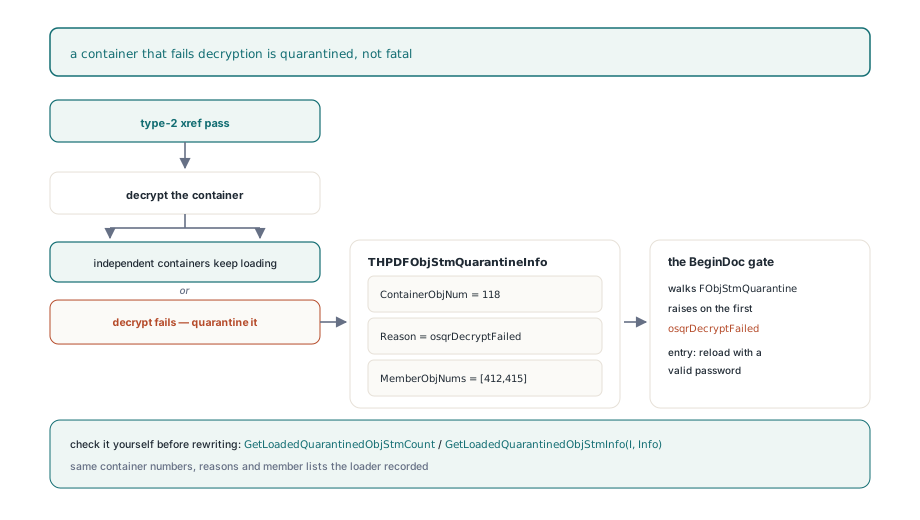
Карантинният списък оцелява през parser fallback. Ако първичното зареждане на cross-reference провали и HotPDF възстанови обектната таблица чрез сканиране на файла, encrypted флагът от първия опит може да не оцелее през възстановяването, но карантинните записи оцеляват. Затова BeginDoc проверява карантинния списък, а не encrypted флага: върху зареден документ той обхожда FObjStmQuarantine и вдига изключение на първия osqrDecryptFailed запис, назовавайки контейнера и искайки презареждане с валидна парола. Пренаписване, което е минало отвъд тази точка, щеше да запише членовете, които контейнерът е трябвало да държи, като празни обекти и да докладва успех. Можете да пуснете същата проверка сами, по-рано и със собствена политика, през публичните accessors:
var
  Info: THPDFObjStmQuarantineInfo;
  I: Integer;
begin
  Pdf.LoadFromFile('vendor-form.pdf');   // празна потребителска парола
  for I := 0 to Pdf.GetLoadedQuarantinedObjStmCount - 1 do
    if Pdf.GetLoadedQuarantinedObjStmInfo(I, Info) and
       (Info.Reason = osqrDecryptFailed) then
      raise Exception.CreateFmt(
        'Object stream %d is unreadable (%s); %d members unresolved',
        [Info.ContainerObjNum, String(Info.Diagnostic),
         Length(Info.MemberObjNums)]);
  // отсега нататък пренаписването е безопасно
end;
Другите причини за карантина покриват некриптографските провали: контейнер, който не е stream, липсващ речник, невалидно /N или /First, размер на stream извън приемания диапазон, провал на декомпресия, /First, сочещ отвъд данните, или тяло на член, което се е декодирало, но не е парснало. Тези си струва да се логват при ingest, защото всяка назовава точните членове, които ще ви липсват надолу по веригата
Защо пренаписването се нуждае от оригиналния числов токен?
HotPDF пази всеки числов обект като Single, а Single не може да възпроизведе изходния текст на реално число. ISO 32000-1 §7.3.3 позволява на writer да излъчи 0.750000, .75 или 0.75 за една и съща стойност, и нито една от тях оцелява непокътната през обръщане през 24-битово бинарно представяне и generic форматиране. По-лошото: стойност като 0.7 изобщо не е представима в Single; тя парсва до най-близкия float, а преформатирането на този float може да произведе 0.69999999 или закръглен съсед в зависимост от цифровия цикъл. Върху цвят за запълване или /CA transparency константа това е разлика от една стъпка в 8-битов канал — достатъчно да провали пикселно сравнение с източника и, върху границите на градиент, достатъчно да се види
THPDFNumericObject.RememberSourceToken решава това за непроменения случай. Парсерът го вика със суровия токен веднага след задаването на Value; методът приема само токени от цифри, най-много една десетична точка и опционален водещ знак, и пази токена заедно със стойността, на която е отговарял, в FSourceValue. Свойството SourceToken връща съхранения текст само докато Value все още е равно на FSourceValue. Сменете ли числото, токенът се изпарява, така че променена стойност винаги минава през съществуващия форматиращ път и никога не излъчва остарял текст. SaveNumericObject проверява SourceToken първо и го записва дословно, когато го има, после пада към integer, color-space reference и дробните клонове само за числа, създадени или редактирани в паметта
Инвариантът е малък и си струва да се каже ясно: число, което не сте пипнали, се записва с байтовете, с които е било прочетено, а число, което сте пипнали, се записва от собствения форматиращ механизъм на HotPDF. Compact членовете се възползват от това по същия начин като телесните обекти, тъй като EnsureCompressedObjectLoaded пуска същия парсер върху отрязъка на члена. Самото форматиране на числа и неговата независимост от process locale-а са покрити в статията за locale-независимо форматиране на PDF числа в HotPDF
Тестване на път за пренаписване срещу object stream-ове
Три проверки хващат всеки описан по-горе провал, и нито една не изисква Acrobat. Първо, сравнете IndexedObjectCount с MaterializedObjectCount след записа; при пълно пренаписване те трябва да са равни, а всяка разлика е член, който е изпуснат. Второ, извлечете текст и изброете structure tree-то и на двата файла, не само ги рендирайте, така че загубен ActualText или загубен structure елемент да се покаже като diff. Трето, заредете изхода с чиста инстанция и асертирайте, че GetLoadedQuarantinedObjStmCount е нула, което доказва и че writer-ът не е произвел контейнер, който четецът не може да отвори. Crypt филтър комбинациите, решаващи FReloadObjectStreamsEncrypted, са подредени в статията за политиките StmF, StrF и EFF. Writer страната на тази история — как да излъчвате object stream-ове и кога да предпочитате инкрементална актуализация пред пренаписване — е в ръководството за object stream-ове и инкрементални актуализации
Мързеливото зареждане на членове, разширяващият проход преди writer, decrypt карантината и запазването на source токен всички се доставят в HotPDF Delphi Component за Delphi и C++Builder. Продуктовата страница линква API справката, ако искате да проследите GetLoadedObjectStreamCacheInfo и карантинните accessors срещу собствения си ingest pipeline