HotPDF преобразува HTML в PDF страници чрез THPDFHTMLImporter.RenderHTML5 — версиониран профил за paged-media с истински DOM, истински CSS каскад, таблици, разделяне на страници и незадължително генериране на AcroForm от контролите на HTML формуляри. Работи изцяло в процеса: без браузърен енджин, без Chromium, без външен конвертор, и по подразбиране без никакъв достъп до файлове или мрежа
Причината да съществува отделна входна точка, вместо подобрен RenderHTML, е съвместимостта. По-старият метод рендира фактури и писма в продукционни приложения от години, а либерален DOM с пълен каскад променя изхода на документи, които са били настроени спрямо старото поведение. Затова старият метод запазва точната си семантика, а всичко ново живее зад RenderHTML5, чиято версия на профила се докладва от HTML5ProfileVersion, а поддържаните етапи се изброяват от HTML5ProfileMilestones
Какво всъщност добавя HTML5 профилът?
На практика имат значение четири възможности. Структурен DOM, в който html и body са контейнери, а не текстови възли. CSS каскад с коректен приоритет. Оформление на таблици. И изрично управление на разделянето на страници, което е самото значение на „paged media“: HTML е проектиран за скролируем изглед, а превръщането му в страници изисква решение къде е позволено съдържанието да се разделя
Точката за контейнерите звучи като детайл от имплементацията, а всъщност е разликата между работещо и неработещо решение. Ако кореновите елементи се третират като текстови контейнери, целият DOM се срутва в един текстов блок по време на анализа, и всяко правило от стиловия лист, всяко разделяне на страница, таблица и подстъпало на формуляр след това се прилага върху нищо. Всеки HTML рендерер, който произвежда една недиференцирана стена от текст от структуриран документ, е допуснал точно тази грешка
Редът на каскада, изяснен подробно
Приоритетът на CSS не е едно единствено сортиране. HotPDF прилага нормални декларации от съвпадащи правила по ред на специфичност, а след това по ред на изходния код, след това прилага нормалните вградени (inline) декларации отгоре, после декларациите с !important от съвпадащи правила, и накрая вградените декларации с !important. Четири прохода, в този ред
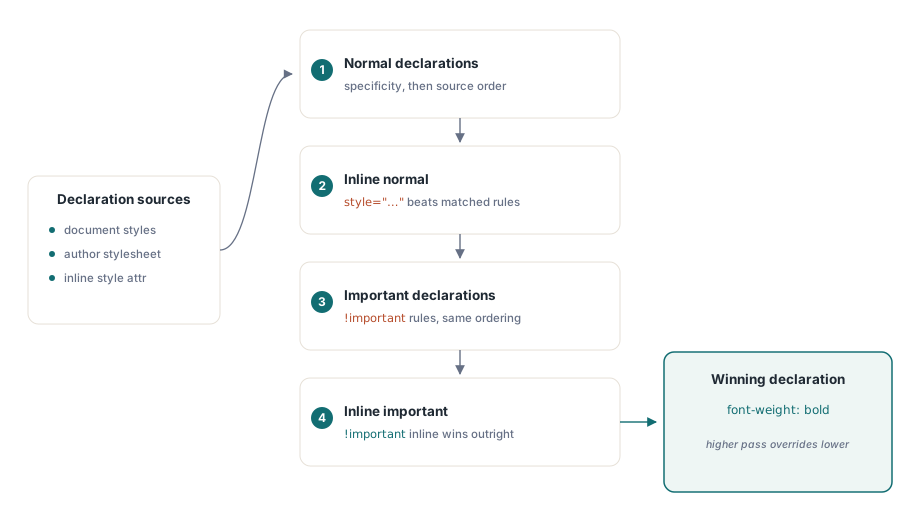
Реализации, които свеждат това до „последният печели“, се справят правилно с честите случаи и грешно с интересните, което е по-лошо от еднакво грешния резултат, защото грешката се проявява само в шаблони, използващи !important, за да заменят базов стилов лист — точно шаблоните, писани от хора, които очакват каскадът да работи:
uses
  HPDFDoc, HPDFHTMLImport;

var
  Pdf: THotPDF;
  Importer: THPDFHTMLImporter;
  Html, Css: WideString;
begin
  Pdf := THotPDF.Create(nil);
  Importer := THPDFHTMLImporter.Create(Pdf);
  try
    Pdf.FileName := 'statement.pdf';
    Pdf.BeginDoc;

    Importer.Margin := 56;              // точки
    Importer.BaseFontName := 'Arial';
    Importer.BaseFontSize := 10;
    Importer.CreateAcroForms := False;  // рендира контролите, не създава полета

    Css := '@page { margin: 56pt } ' +
           'table { border-collapse: collapse } ' +
           'tr.total { page-break-inside: avoid; font-weight: bold }';
    Html := LoadTemplate('statement.html');

    if not Importer.RenderHTML5(Html, Css) then
      raise Exception.Create('nothing was emitted - check the markup');

    Pdf.EndDoc;

    Writeln(Format('profile=%d nodes=%d rules=%d layout ops=%d',
      [Importer.Statistics.ProfileVersion,
       Importer.Statistics.ParsedNodeCount,
       Importer.Statistics.CSSRuleCount,
       Importer.Statistics.LayoutOperationCount]));
  finally
    Importer.Free;
    Pdf.Free;
  end;
end;
Вторият аргумент е авторски стилов лист, приложен успоредно с онова, което носи самият документ, което е чистият начин да наложите фирмени правила като полета на страницата и контрол на „вдовиците“, без да редактирате всеки шаблон
Защо импортерът никога не извлича нищо?
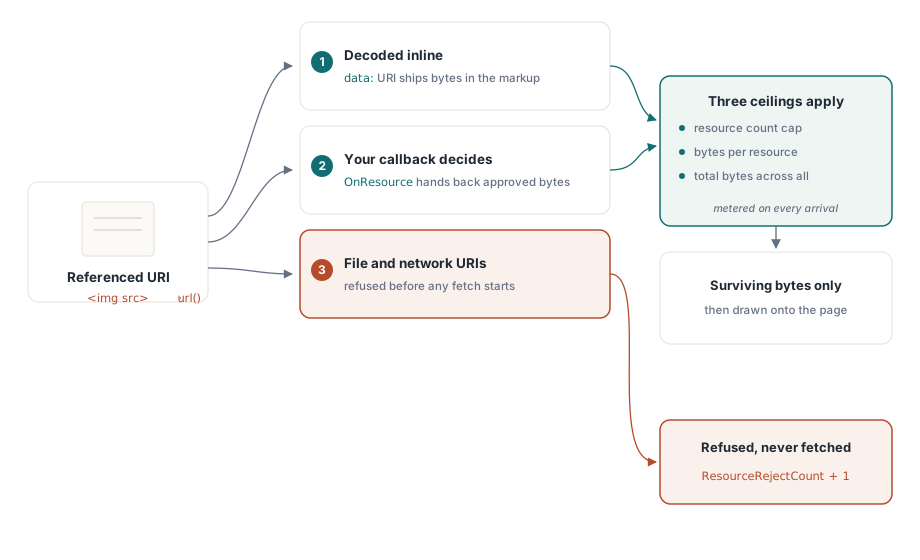
Конвертор от HTML в PDF, който разрешава външни препратки, е двигател за подправяне на заявки от страна на сървъра (SSRF), облечен в костюм на генератор на документи. Насочете го към подадена от потребител разметка и той с готовност ще извлече http://169.254.169.254/ или URL адрес на файл от вашия приложен сървър и ще вгради резултата в PDF, който някой изтегля
Затова HotPDF по подразбиране не чете нито файлове, нито мрежа. Изображенията и другите ресурси пристигат по точно два начина: като data: URI вътре в разметката, или чрез обратното извикване OnResource, където вашият код решава какво означава даден URI и подава байтовете:
procedure TReportForm.SupplyResource(Sender: TObject;
  const URI: WideString; ResourceKind: THPDFHTMLResourceKind;
  var Data: TBytes; var ContentType: string; var Handled: boolean);
begin
  Handled := False;
  // Обслужвайте само от директория с активи в бял списък. Никога не
  // подавайте URI към HTTP клиент и никога не го съединявайте с път
  // без предварителна проверка
  if StartsText('asset:', URI) then
  begin
    Data := LoadAssetBytes(Copy(URI, 7, MaxInt));
    ContentType := 'image/png';
    Handled := Length(Data) > 0;
  end;
end;
Всеки ресурс, който все пак пристигне, продължава да се брои спрямо три отделни тавана: колко ресурса, колко байта всеки, и колко байта общо. Обратно извикване, което добросъвестно връща каквото е поискано, не може да бъде подмамено да изчерпи паметта от документ, който препраща един и същ 50-мегабайтов файл двеста пъти
Четири бюджета, един режим на отказ
Възлите на парсера, CSS правилата, операциите по оформление и ресурсите се следят независимо, защото се провалят независимо. Един документ може да е малък и патологично скъп за оформяне; друг може да е плитък, но със стилов лист, проектиран да взриви съпоставянето на селектори. Изчерпването на който и да е от тях предизвиква EHPDFHTMLImportBudget — специален клас изключение, така че изчерпването на бюджет може да се улови отделно от неправилно оформен вход
Статистиката се нулира в началото на всяко извикване на RenderHTML5, така че числата описват един импорт, а не жизнения цикъл на обекта на импортера. В услуга, която рендира ненадеждни шаблони, логвайте ParsedNodeCount, LayoutOperationCount и ResourceRejectCount за всеки документ: нарастващ брой отхвърляния обикновено означава, че авторът на шаблона препраща активи, които обратното ви извикване не разпознава, а брой операции по оформление, близък до тавана, означава, че следващият, малко по-голям документ ще се провали
Избор между HTML импорт и layout API
HTML импортът печели, когато съдържанието е създадено като HTML от хора, които не са Delphi разработчици, когато шаблоните се променят по-често от кода, или когато същото съдържание трябва да се изпраща и по имейл. Декларативното дърво за оформление, описано в декларативно PDF оформление с маркиран (tagged) изход, печели, когато документът се генерира от данни чрез собствен код, когато трябва автоматично да се произведе структура за PDF/UA, или когато точният контрол върху разбивката на страници има по-голямо значение от удобството при създаване
Двата подхода не се изключват взаимно. Обичайна схема е HTML импорт за тялото на отчет, с колонтитули и блок за подпис, изчертани директно, тъй като те са фиксирана геометрия, която не бива да принадлежи на никой шаблон. Таблиците са единствената област, в която си струва да измерите и двата подхода: сложни финансови таблици понякога се разбиват на страници по-добре чрез специализирания път за таблици, описан в генериране на таблици в PDF
Задавайте CreateAcroForms съзнателно. Изключено, контролите на HTML формуляра се рендират като статично изображение, което е желаното поведение за отпечатана справка. Включено, те стават истински интерактивни полета на AcroForm, което е желаното поведение за попълваем формуляр, а последващото поведение на полетата е разгледано в добавяне на полета на формуляр към зареден PDF
HTML импортът, декларативното оформление и API-то за директно изчертаване са насочени към един и същ обект на документа в Delphi и C++Builder; пълният списък с функции е на страницата на HotPDF Delphi PDF компонента