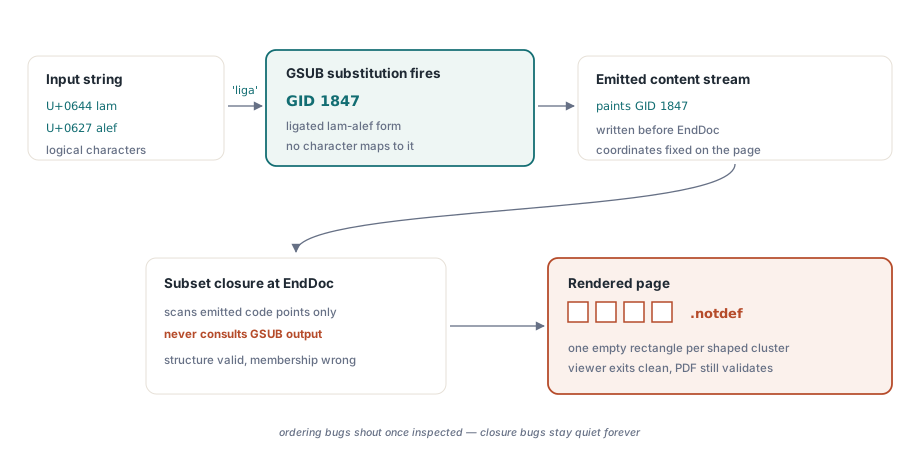
Shaped глифи се рендират като кутии .notdef, когато font subsetter пази само глифите, достижими от излъчените code points. HotPDF, нативният VCL PDF компонент за Delphi и C++Builder, е носил точно този дефект до версия 2.435.0: изходът от OpenType GSUB е бил записван във вътрешна usage bitmap, която subsetter-ът е обявявал, че ще спазва, а после никога не е чел
Това е различен провал от описания в бъг в EndDoc, тихо изключващ font subsetting. Онзи бъг беше за кога subsetting се изпълнява спрямо сериализацията, и изключваше subsetting изцяло. Този е за какво съдържа subset-ът, когато subsetting се изпълнява перфектно по разписание. Pipeline-ът стартира в точния момент, шестбуквеният subset префикс се появява в /BaseFont точно както ISO 32000-1 §9.6.4 изисква, файлът намалява, всяка латинска страница проверява чисто, а арабска страница излиза като редица празни правоъгълници. Бъговете в реда се виждат веднага щом погледнете. Бъговете в closure остават тихи завинаги, защото subset-ът е структурно валиден и грешен само относно собствения си списък членове
Защо shaped глифи се рендират като .notdef?
Защото множеството от code points, които документ излъчва, не е множеството от глифи, които документ рисува, а subsetter, объркващ двете, изхвърля всеки глиф, произведен от shaping. Text shaping превръща логическа последователност от символи в позиционирана последователност от глифи, и целта му изцяло е да произведе глифи, на които нито един единичен входен символ не съответства: арабско медиално heh, лигатура fi, деванагари conjunct, контекстуален алтернат, избран от функцията rclt. Всеки от тях е glyph ID, произведен от GSUB lookup, не такъв, който cmap таблицата ви дава за какъвто и да е символ във вашия низ. Subsetter, воден изцяло от cmap, затова обхожда грешния индекс. Той вярно пази всеки глиф, който текстът е могъл да използва преди shaping, и изхвърля точно глифите, които текстът използва след shaping. После рендерерът иска от вградения шрифт GID 1847, subset-ът е нулирал този запис в loca, и вместо него се връща glyph index 0. Glyph index 0 е .notdef по дефиниция на OpenType, поради което сигнатурата на провала е празна кутия, а не грешна буква или срив. Нищо в PDF не е малформирано; шрифтът просто не съдържа глифа, поискан от content stream-а
Code points не са глифи: трите източника на subset
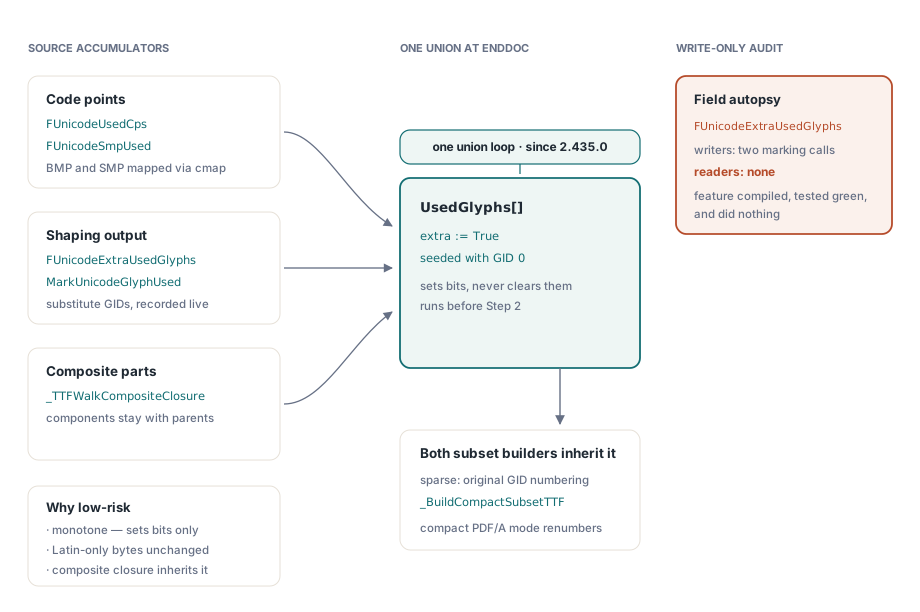
Правилен subset closure трябва да обедини три независими източника, всеки със собствен акумулатор. Първият е множеството, изведено от code points: HotPDF натрупва FUnicodeUsedCps докато BMP символи се излъчват, и FUnicodeSmpUsed за символи от допълнителна равнина, достигнати чрез surrogate двойки, после мапва всеки чрез FUnicodeCpToGid в glyph ID. Вторият е множеството, изведено от shaping — glyph ID-тата, произведени от GSUB заместване, записани чрез MarkUnicodeGlyphUsed и EnableShapingFeatureForSubset в FUnicodeExtraUsedGlyphs. Третото е composite closure: глиф, чийто numberOfContours е -1 в glyf, се сглобява от компонентни glyph ID-та, а запазването на composite при изхвърляне на неговите компоненти дава празен outline вместо .notdef, което е спорно по-лошо, защото се чете като spacing бъг
HotPDF винаги е обработвал първия и третия. BuildAndApplyUnicodeFontSubset, входната точка за subsetting, която EndDoc извиква преди сериализация, засява масива с използвани глифи с GID 0, обхожда BMP code points, обхожда списъка за SMP usage, и подава масива на subset builder, който разрешава композитни компоненти вътрешно. Вторият източник е бил написан, но никога консумиран, и понеже трите източника се провалят при различно съдържание, пропускът може да се крие с години в codebase, чийто regression корпус е предимно латински
Масивът, който е бил записван и никога четен
Договорът е бил документиран на три места и спазен в нито едно от тях. Декларацията на FUnicodeExtraUsedGlyphs заявяваше, че EndDoc subsetter-ът го обединява с usage, изведен от code points; header коментарът на ApplyArabicGSUBRefinement обещаваше, че всеки излъчен заместващ GID се прекарва през MarkUnicodeGlyphUsed, така че subsetter-ът да издърпа глифа във вградения шрифт; същото обещание се появява дословно на ApplyArabicGSUBContextualRefinement за пътя rclt. И двамата извикващи изпълниха своята половина. Grep върху всяка референция към полето уреди другата половина за около деветдесет секунди: една декларация, едно разпределение чрез SetLength вътре в RegisterUnicodeTTF, и записи в двете маркиращи рутини. Нито едно четене. Това е диагностиката, която си струва да се интернализира, защото се обобщава добре отвъд шрифтовете. Когато поле се записва от няколко call site и не се чете от нито едно, функцията, която представлява, не съществува, колкото и щателно да е коментирана. Стъпка 1 на subsetter-а е достатъчно малка, за да се прочете на един екран, а пропускът е очевиден, щом знаете къде да гледате
// Стъпка 1: извеждане на множеството от използвани глифи (както е било преди 2.435.0)
SetLength(UsedGlyphs, FUnicodeNumGlyphs);
for I := 0 to FUnicodeNumGlyphs - 1 do
  UsedGlyphs[I] := False;
UsedGlyphs[0] := True;                       // .notdef винаги присъства

for Cp := 0 to $FFFF do                      // източник 1a: BMP code points
  if (Cp < Length(FUnicodeUsedCps)) and FUnicodeUsedCps[Cp]
     and (Cp < Length(FUnicodeCpToGid)) then
  begin
    GID := FUnicodeCpToGid[Cp];
    if (GID > 0) and (GID < FUnicodeNumGlyphs) then
      UsedGlyphs[GID] := True;
  end;

for I := 0 to High(FUnicodeSmpUsed) do       // източник 1b: SMP code points
begin
  GID := FUnicodeSmpUsed[I].GID;
  if (GID > 0) and (GID < FUnicodeNumGlyphs) then
    UsedGlyphs[GID] := True;
end;

// източник 2 липсваше тук: нищо никога не се допитваше до FUnicodeExtraUsedGlyphs
Поправката с един цикъл, и маркиране на глифи сами
Поправката е обединение, а нейният аргумент за безопасност идва от посоката на операцията: тя само задава битове, никога не ги изчиства, така че никой глиф, който преди е оцелявал в subset-а, не може да започне да бъде изхвърлян
// v2.435.0: вкарва извлечените от GSUB допълнителни глифи в subset-а.
// MarkUnicodeGlyphUsed / EnableShapingFeatureForSubset записват GID-та, които
// shaping е произвел, но към които никой излъчен code point не сочи директно.
for I := 0 to FUnicodeNumGlyphs - 1 do
  if (I < Length(FUnicodeExtraUsedGlyphs)) and FUnicodeExtraUsedGlyphs[I] then
    UsedGlyphs[I] := True;
Три свойства правят това нискорискова промяна, а не преработка на font engine-а. Тя е монотонна, както по-горе. Тя е no-op за шрифтове, никога не shape-нали нищо, понеже FUnicodeExtraUsedGlyphs остава изцяло False, а байтовият изход за документ само на латиница е непроменен. И се приземява преди стъпка 2, така че и двата subset builder-а я наследяват: разреденият builder, запазващ оригиналната GID номерация, и компактният builder _BuildCompactSubsetTTF, който HotPDF избира под PDF/A, за да преномерира запазените глифи в плътен диапазон, свие maxp.numGlyphs, и излъчи старо-към-ново мапирането като stream /CIDToGIDMap, изискван от ISO 32000-1 §9.7.4.2. И двата извикват _TTFWalkCompositeClosure вътрешно, така че shaped глиф, който случайно е composite, сега също довлича своите компоненти. Composite closure никога не е бил счупен; просто никога не е бил достигнат за тези glyph ID-та, защото glyph ID-тата не са били в множеството, което той обхожда. Ако карате GSUB engine-а директно вместо да разчитате на вградените refinement преминавания, closure става ваша отговорност, и всеки заместващ glyph ID, който излъчите, трябва да бъде маркиран преди EndDoc да замрази множеството от използвани глифи
var
  Pdf: THotPDF;
  GIDs: array[0..1] of Word;
  LigGID: Word;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'shaped.pdf';
    Pdf.BeginDoc;
    Pdf.RegisterUnicodeTTF('C:\Fonts\NotoNaskhArabic-Regular.ttf');
    Pdf.ShapingFeatures := [sfArabicGSUB, sfStandardLigatures,
                            sfContextualAlternates];

    GIDs[0] := Pdf.GetUnicodeGlyphForCodepoint($0644);   // lam
    GIDs[1] := Pdf.GetUnicodeGlyphForCodepoint($0627);   // alef
    if Pdf.ApplyLigatureSubstitution(GIDs, 0, 'liga', LigGID) then
      Pdf.MarkUnicodeGlyphUsed(LigGID);   // пропуснете това и ще получите .notdef

    Pdf.EnableShapingFeatureForSubset('rclt');
    Pdf.CurrentPage.RtLTextOut(50, 700, 0, WideString(ArabicText));
    Pdf.EndDoc;
  finally
    Pdf.Free;
  end;
end;
EnableShapingFeatureForSubset е партидният аналог на извикването с единичен GID, и е умишлено консервативен. Той обхожда списъка с GSUB lookup-и за тези, окачени на четирибуквен feature таг под текущо избрания script и language път, и маркира заместващите glyph ID-та, които тези lookup-и могат да произведат. Той е защитен no-op, когато шрифтът не носи GSUB таблица или когато функцията липсва по този път, така че извикването му безусловно е безопасно. Той е и над-приближение по замисъл: може да запази глифи, които даден документ никога не рисува. За subsetting свръх-включването струва байтове, а недостатъчното включване струва коректност, което прави този компромис лесен. Структурата на тези lookup-и, и coverage таблиците, решаващи кои глифи участват, е разгледана в обиколката на GSUB стилистични алтернати в чист Delphi
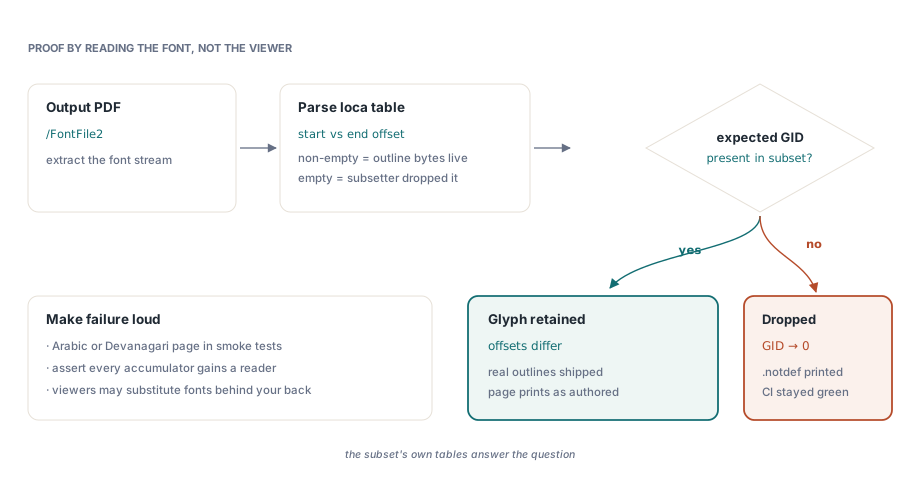
Как доказвате, че глифът действително е в subset-а?
Чрез четене на излъчения шрифт, не чрез оглеждане на страницата в viewer, който може тихомълком да замества системен шрифт зад гърба ви. Проверката, хващаща целия този клас бъг, е механична: извлечете stream-а /FontFile2 от изходния PDF, парснете loca, и потвърдете, че очакваният glyph ID носи непразен запис, тоест неговите начален и краен offset се различават. Празен запис означава, че subsetter-ът е решил, че глифът е неизползван. Два навика после правят много по-трудно да изпратите провала отново. Дръжте страница с shaped script в автоматизирания smoke корпус, а не само в ръчния proofing набор, защото арабски, деванагари и кхмерски упражняват пътища за closure, до които никакво количество латинско покритие няма да стигне. И винаги когато съществува акумулатор, проверявайте, че нещо го консумира, защото write-only поле е функция, която компилира, тества зелено на грешния корпус и не прави нищо
Къде спира поправката
Subset closure е необходим, за да се рендира shaped глиф, но не е достатъчен. Глифът също трябва да е адресируем от content stream-а, което е отделен проблем със собствена граница. Вградените refinement преминавания на HotPDF за арабски правят заместване само когато всеки заместващ glyph ID е достижим чрез Unicode presentation-form code point посредством обратно сканиране на cmap над около 690 code points в U+FB50 до U+FDFF и U+FE70 до U+FEFF. Когато заместване се приземи на glyph ID извън този диапазон, входният прозорец минава непроменен, вместо да излъчи нещо, което читателят не може да адресира; специфични за шрифта алтернати на произволни glyph ID-та се нуждаят от синтетичен private-use code point, разпределен в U+E000 до U+F8FF, за да ги пренесе през пътя за излъчване. Затова честното резюме е, че поправката в 2.435.0 премахна твърда бариера, вместо да завърши историята. Преди нея глиф е можел да бъде shape-нат правилно, излъчен правилно, и все пак да изчезне при subsetting, което означаваше, че shaping engine-ът не можеше да бъде доверен от край до край, колкото и добри да бяха неговите lookup-и. Оставащото е адресируемост, и това ограничение поне се проваля видимо в момента на излъчване, а не тихо в build стъпка, изпълняваща се след всичко, което сте наблюдавали. За страната на излъчването на същия pipeline вижте ръководството за арабски и RTL text shaping в Delphi PDF-и
Font subsetting-ът, GSUB engine-ът и shaping-ът за сложни писмености, описани тук, се доставят в стандартния HotPDF Delphi Component за Delphi и C++Builder; продуктовата страница носи пълния API справочник за именуваните по-горе Unicode font и shaping извиквания