Стойност на /Predictor от 10 до 14 в PDF речник /DecodeParms не казва на декодера кой PNG филтър да приложи. losLab PDF Library, от v3.539.21 нататък, третира всяка стойност от 10 до 15 еднакво в ApplyInflatePredictor: всеки ред от раздутия данни започва с един байт filter-type, и този байт, не речникът, избира None, Sub, Up, Average или Paeth за реда. Разликата между 10, 11, 12, 13, 14 и 15 е съвет към енкодера кой филтър да записва; от страната на декодирането тя е безсмислена, и декодер, който я уважи, дава изход, изместен с по един байт на ред. Това звучи като бележка под линия в таблица 8 на ISO 32000-1, докато не пристигне реален файл, чийто cross-reference stream е записан с /Predictor 12. Тогава цялата таблица с обекти се декодира до правдоподобно изглеждащ боклук, коренът на документа не се намира, а публичният loader докладва грешка, сочеща файловая система, а не filter параметър. Три неща трябва да се разплетат: какво всъщност обещава спецификацията, защо старата имплементация и нейните собствени регресионни тестове се съгласяваха помежду си и с нищо друго, и какво прави коригираният редов цикъл в PDFlibZLib.pas сега и за Flate, и за LZW stream-ове
Защо /Predictor 12 не значи Up на всеки ред?
Защото ISO 32000-1 §7.4.4.4, таблица 8, дефинира стойностите от 10 до 15 като PNG predictor семейство, а самият PNG формат, ISO/IEC 15948 §9, дефинира филтрирането като решение за всеки scanline, записано в байт filter-type в началото на всеки scanline. Таблица 8 изброява отделните стойности с описания като „PNG Sub prediction on all rows" и „PNG optimum prediction", но тези описания казват на енкодера какво да записва. Таблицата е изрична, че PNG predictor-ите позволяват различен филтър на всеки ред точно защото всеки ред носи собствения си таг. Файл, записан с /Predictor 12 от добре възпитан енкодер, следователно съдържа байт 2 пред всеки ред, а декодерът, който прочете този байт, получава един и същ отговор дали му е казано 12 или 15
Клопката е, че описанията се четат като набор инструкции. Predictor 2 в същата таблица наистина е фиксиран алгоритъм — TIFF horizontal differencing predictor — и изобщо не носи маркер за ред, така че разработчик, който имплементира първо Predictor 2 и после продължи надолу по таблицата, естествено приема, че 10 до 14 работят по същия начин, с различна формула всеки. Точно това предположение излезе в по-ранните версии на losLab PDF Library: редовият цикъл третираше Predictor 15 като единствената tagged разновидност, и мапваше 10 до 14 към Parms.Predictor - 10 като постоянен филтър. Четенето на редовия таг е единственото коректно поведение, а подсказката от страната на енкодера е най-добре изобщо да се игнорира, защото producer, който е ползвал PNG optimum филтриране, но е написал /Predictor 11 в речника, дори не е malformed по букваря на стандарта
Как XFA фактура превърна Flate параметър в грешка 401
Провалът излезе наяве в XFA фактура, разрешена от клиента, регистрирана в локалния корпус като xfa-invoice-1 с SHA-256 1b65f07d…46de1e — едностраничен документ, чийто cross-reference stream е Flate-компресиран с /Predictor 12. При старото четене с фиксиран алгоритъм SourceRowLength беше равно на TargetRowLength вместо на TargetRowLength + 1, така че цикълът поглъщаше байта filter-type като първи данни-байт на всеки ред и започваше всеки следващ ред с един байт закъснение. Всеки cross-reference запис след първия беше разместван, полето type се четеше от това, което всъщност беше offset байт, а resolve-натите offset-и сочеха в средата на несвързани обекти
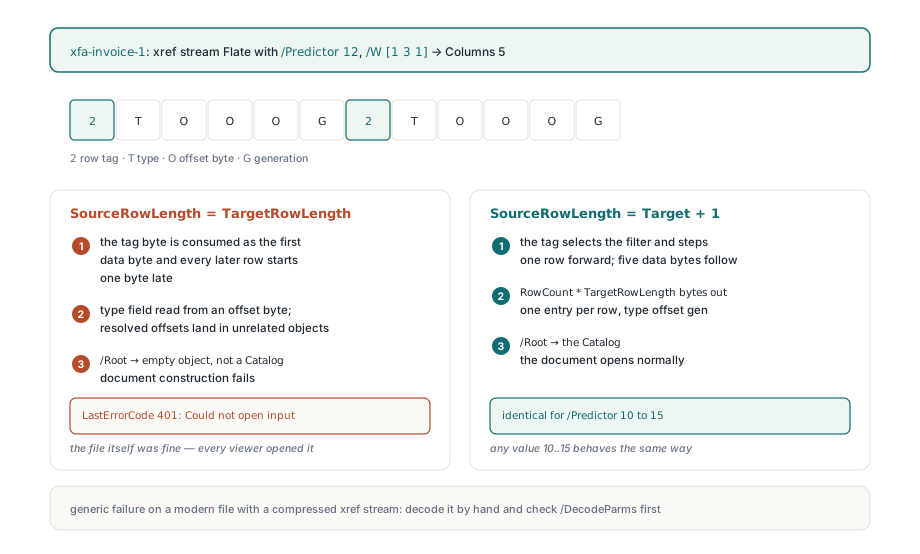
Това, което извикващият видя, беше LoadFromFile, връщащ 0, и LastErrorCode, докладващ 401, „Could not open input file", върху файл, който беше четим, нешифрован и се отваряше без проблем във всеки viewer. Отвътре веригата е кратка: cross-reference stream-ът се декодира, записите се парснаха до глупости, справката /Root resolve-на до празен обект вместо Catalog, изграждането на документа се провали, а мапването на резултата от зареждането падна до кода си по подразбиране. Понеже пробата беше XFA форма, първият заподозрян беше XFA машинерията, която нямаше нищо общо; документът никога не стигна дотам да погледне шаблон. Урокът, който си заслужава да се носи, е диагностичен: когато съвременен файл с компресиран cross-reference stream се провали при зареждане с генеричен код, декодирайте cross-reference stream-а на ръка, преди да гледате другаде, и проверете дали /DecodeParms му споменава predictor
Как Columns, Colors и BitsPerComponent оразмеряват ред
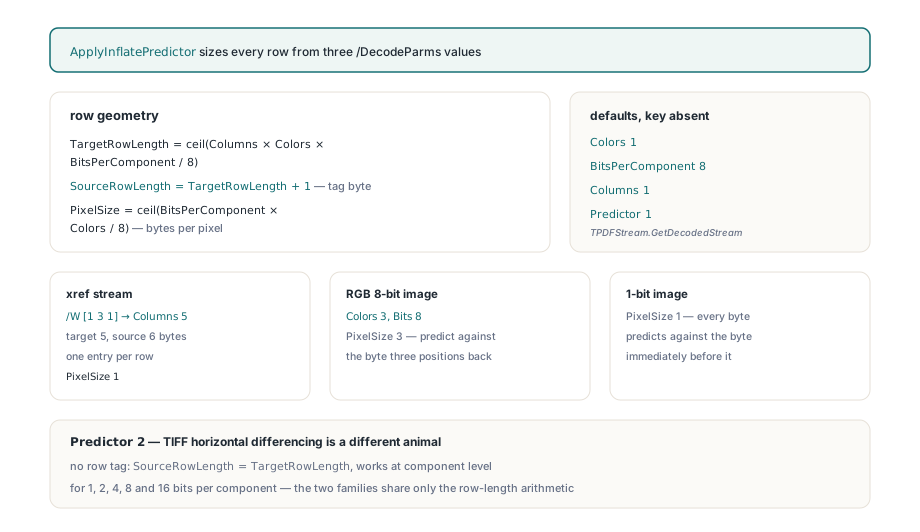
Геометрията на реда идва изцяло от три параметъра в таблица 8, и заблуда в който и да е от тях дава същия симптом като заблуда в тага. losLab PDF Library изчислява дължината на декодирания ред като ceil(Columns × Colors × BitsPerComponent / 8) — това е TargetRowLength в ApplyInflatePredictor — а за PNG семейството добавя един байт, за да получи SourceRowLength. Стойностите по подразбиране, приложени от TPDFStream.GetDecodedStream, когато ключ липсва, са тези от таблица 8: Colors 1, BitsPerComponent 8, Columns 1, Predictor 1. За cross-reference stream producer-ът задава /Columns на сумата от ширините в /W, така че /W [1 3 1] върви с /Columns 5 и всеки декодиран ред е точно един запис; самата аритметика на /W е покрита в статията за object stream-овете и cross-reference stream-овете, която спира на момента, в който payload-ът на stream-а се подава на филтъра. Филтрите Sub, Average и Paeth допълнително трябва да знаят колко назад е „байтът вляво", и PNG дефинира това като броя байтове на пълен пиксел, закръглен нагоре до поне един; losLab PDF Library го извежда като PixelSize := ceil(BitsPerComponent × Colors / 8), така че RGB 8-битово изображение предсказва всеки байт спрямо байта три позиции по-рано, докато 1-битово изображение — и всеки cross-reference stream — предсказва спрямо непосредствено предходния байт. Predictor 2 е друго животно, обработвано от отделен клон: той възстановява всеки sample, добавяйки предишния sample на същия color компонент, работи на ниво компонент за 1, 2, 4, 8 и 16 бита на компонент, и няма редов таг, така че SourceRowLength му е точно TargetRowLength. Двете predictor семейства споделят само аритметиката на дължината на реда
Какво прави коригираният редов цикъл в ApplyInflatePredictor
Декодерът е една-единствена функция, ApplyInflatePredictor(Const Input: AnsiString; Var Parms: TPDFFlateParms; MaxOutput: Integer = 0): AnsiString, а InflateStrParms е просто ApplyInflatePredictor(InflateStr(Input), Parms). Записът TPDFFlateParms носи Predictor, Colors, BitsPerComponent, Columns, плюс ExpandedTo8Bit и ColorSpace, които image декодерът ползва след предсказването. Поправката в v3.539.21 махна изцяло клона с фиксиран алгоритъм; извадката по-долу е редовият цикъл в сегашния му вид, с пропуснат TIFF клон
TargetRowLength:= Integer((BitsPerRow+ 7)div 8);
If Parms.Predictor>= 10 Then
  SourceRowLength:= TargetRowLength+ 1     // PNG семейство: таг байт на ред
Else If Parms.Predictor= 2 Then
  SourceRowLength:= TargetRowLength        // TIFF: без таг
Else
  Exit;

RowCount:= (SourceLength+ SourceRowLength- 1)div SourceRowLength;
SetLength(Result, RowCount* TargetRowLength);
SourcePos:= 1;
For Row:= 0 To RowCount- 1 Do
Begin
  TargetPos:= Row* TargetRowLength+ 1;
  If Parms.Predictor>= 10 Then
  Begin
    If SourcePos<= SourceLength Then
      Predictor:= Byte(Source[SourcePos])  // 0..4 избира row филтъра
    Else
      Predictor:= 0;
    Inc(SourcePos);
    If Predictor> 4 Then
    Begin
      Result:= '';                         // непознат таг: отказ на stream-а
      Exit;
    End;
  End
  Else
    Predictor:= 202;                       // вътрешен маркер за TIFF
  FillChar(Result[TargetPos], TargetRowLength, 0);
  // ... копирай до TargetRowLength сурови байта в Result[TargetPos] ...
  If Row> 0 Then
    PreviousRowPos:= TargetPos- TargetRowLength
  Else
    PreviousRowPos:= 0;
  Case Predictor Of
  1: // Sub: добави байта на един пиксел наляво
    For Col:= PixelSize To TargetRowLength- 1 Do
      Result[TargetPos+ Col]:= AnsiChar((Byte(Result[TargetPos+ Col])+
        Byte(Result[TargetPos+ Col- PixelSize]))and $FF);
  2: // Up: добави байта директно отгоре, първият ред няма такъв
    If Row> 0 Then
      For Col:= 0 To TargetRowLength- 1 Do
        Result[TargetPos+ Col]:= AnsiChar((Byte(Result[TargetPos+ Col])+
          Byte(Result[PreviousRowPos+ Col]))and $FF);
  3: // Average: (left + up) div 2, липсващите съседи се четат като 0
    ...
  4: // Paeth: PaethPredictor(left, up, upper-left)
    ...
  End;
End;
Четирите филтърни клона следват ISO/IEC 15948 §9 буквално, включително правилото, че липсващ ляв съсед на първия пиксел и липсващ горен ред на първия scanline се четат като нула, а PaethPredictor(A, b, C: Byte): Byte имплементира наредбата при равенство, която PNG спецификацията изисква: ляв печели над горния, горният печели над горния-ляв. Цялата аритметика е по модул 256 върху байтове. Нищо от това не зависи от Parms.Predictor, щом редовият цикъл тръгне — и това е целият смисъл: речниковата стойност отваря вратата към PNG семейството и оразмерява реда, а оттам нататък данните поемат. LZW stream-овете минават през същия код: TPDFLZWDecompressor.ApplyPredictor копира четирите полета за геометрия от TPDFLZWParms в запис TPDFFlateParms и вика ApplyInflatePredictor с тавана за изход на декомпресора, така че една-единствена поправка вдигна и двата филтъра наведнъж, а LZW регресионната фикстура се смени в същия commit. LZW-специфичните опасности — ширината на кода и параметърът /EarlyChange — са отделна тема, покрита в статията за LZW EarlyChange; обработката на predictor е надолу по веригата от всичко това и е еднаква за двата филтъра
Защо старите регресионни тестове минаваха?
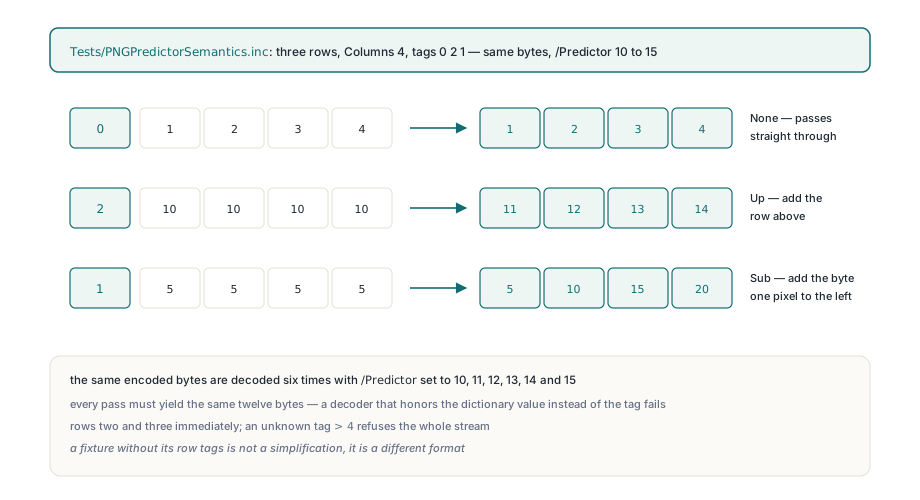
Минаваха, защото фикстурите бяха строени на ръка да пасват на имплементацията, а не от енкодер, чел стандарта. Тест, именуван за Predictor 12, хранеше декодера осем сурови байта, #1#2#3#4#10#10#10#10, с Columns 4, и очакваше Up филтърът да е приложен на втория ред. Никакъв реален producer не излъчва тази байтова последователност под /Predictor 12; реален producer излъчва десет байта, #2#1#2#3#4#2#10#10#10#10, с таг 2 в началото на всеки ред. Тестът закова погрешното четене и даде зелена светлина на всеки следващ рефакторинг. Коригираните фикстури в Tests.ZLib.pas и Tests.LZW.pas вече носят таг байта, а случай с None филтър е най-поучителният от набора: входът #0#1#2#3#0#4#5#6 с Columns 3 се декодира до #1#2#3#4#5#6 — шест байта от осем, защото два от входните байтове никога не са били данни. По-силният guard е споделен тест в Tests/PNGPredictorSemantics.inc, който върви и на Delphi, и на FPC: той строи stream, чийто раздутий payload е 15 байта — три реда Columns 4 плюс по един таг, с тагове 0, 2 и 1 в тази подредба — после декодира идентичните байтове шест пъти с /Predictor настройван на всяка от 10 до 15, и всеки пас трябва да даде същите дванайсет байта. Ако някой някога върне идеята, че речниковата стойност избира алгоритъма, пасът с Predictor 11 или 13 дава различен отговор и тестът се проваля със съобщение, назоваващо грешката
procedure RunPNGPredictorSemantics;
const
  // zlib payload, който се inflate-ва до: 0 1 2 3 4 | 2 10 10 10 10 | 1 5 5 5 5
  Encoded: AnsiString = #$78#$9C#$63#$60#$64#$62#$66#$61#$E2#$02#$02#$46#$56#$20#$00#$00#$01#$FE#$00#$4A;
  Expected: AnsiString = #1#2#3#4#11#12#13#14#5#10#15#20;
var
  Structure: TPDFStructure;
  Stream: TPDFStream;
  Parms: TPDFDictionary;
  Predictor: Integer;
begin
  for Predictor:= 10 to 15 do
  begin
    Structure:= TPDFStructure.Create;
    try
      Parms:= Structure.NewDictionary;
      Parms.Add('Predictor', Structure.NewNumeric(Predictor));
      Parms.Add('Columns', Structure.NewNumeric(4));
      Stream:= Structure.NewStream(Encoded, False);
      Stream.Dictionary.Add('Filter', Structure.NewName('FlateDecode'));
      Stream.Dictionary.Add('DecodeParms', Parms);
      if Stream.GetDecodedStream<> Expected then
        raise Exception.Create('PNG predictor ignored per-row algorithm tags');
    finally
      Structure.Free;
    end;
  end;
end;
Ред едно има таг 0 и минава през като 1 2 3 4. Ред два има таг 2, така че 10 10 10 10 става 11 12 13 14 чрез добавяне на реда отгоре. Ред три има таг 1, така че 5 5 5 5 се натрупва отляво надясно в 5 10 15 20. Фикстура с три различни филтъра в три реда е минимумът, отличаващ „чете тага" от „случайно позна", а общото правило, което тя налага, заслужава възприемане: всяка predictor фикстура трябва да е произведена от реален енкодер или поне ръчно сглобена с редовите ѝ тагове на място. Синтетични данни, прескачащи тага, не са опростяване — те са друг формат
Извикване на декодера директно и границите, които той налага
Повечето извикващи никога не пипат ApplyInflatePredictor; LoadFromFile, четецът на cross-reference, image декодерът и TPDFStream.GetDecodedStream всички го достигат вътрешно. Все пак е полезно да знаете как да го управлявате, когато stream е изваден от файл за форензичен оглед, а извадката по-долу декодира payload на cross-reference stream по начина, по който го прави loader-ът за речник с /W [1 3 1] /Columns 5 /Predictor 12
uses
  PDFlibZLib;

function DecodeXRefPayload(const RawStreamBytes: AnsiString): AnsiString;
var
  Parms: TPDFFlateParms;
begin
  FillChar(Parms, SizeOf(Parms), 0);
  Parms.Predictor:= 12;          // всяка стойност 10..15 се държи еднакво
  Parms.Colors:= 1;
  Parms.BitsPerComponent:= 8;
  Parms.Columns:= 5;             // сумата на /W [1 3 1]
  Result:= InflateStrParms(RawStreamBytes, Parms);
  // Result вече държи N * 5 байта: type(1) offset(3) gen(1) на запис.
  // Празен Result значи, че payload-ът е отхвърлен, а не само празен
end;
Границите са нарочни и си заслужава да се изкажат директно. Таг на ред, по-голям от 4, прекъсва цялото декодиране и връща празен стринг вместо частичен резултат, защото stream, нарушаващ PNG диапазона на таговете, много по-вероятно е бил параметризиран зле, отколкото да съдържа един-единствен лош байт, и тихото продължаване би възпроизвело оригиналния бъг в друг костюм. Отрязан последен ред се толерира: RowCount закръгля нагоре, липсващите байтове се четат като нула, а липсващ таг се чете като филтър 0, което позволява на stream, отрязан от грешен /Length, пак да даде непокътнатите си редове. Colors под 1, Columns под 1, BitsPerComponent извън 1, 2, 4, 8 и 16, или Predictor извън 2 и 10 до 15 се отхвърлят всички, преди да е пипнат който и да е ред, а когато е подаден таван за изхода, декодерът връща празно вместо да пропусне входа непроменен. Нищо от това не ремонтира повреден cross-reference stream; файл, чийто /Columns не се съгласява с ширините му в /W, пак се декодира до глупости, а възстановяването от това е работата на offset скенера, описан в статията за възстановяване на повреден xref, не на predictor-а. Коригираната обработка на редови тагове излезе в losLab PDF Library v3.539.21 за Delphi, C++Builder и Free Pascal, и беше валидирана срещу осем corpus набора от общо 1472 страници на FPC Win64 билда заедно с пълния Delphi headless пакет; продуктовата страница изброява възможностите на декодера и поддържаните комбинации от филтър и predictor