PDF Library for Delphi превръща PDF съдържание в два редактируеми формата без Office automation. ExportPageMarkdown и ExportDocumentMarkdown връщат семантичен Markdown с изведени заглавия, номерирани и ненумерирани списъци и таблици с вертикална черта, докато SaveDOCXToFile и SaveDOCXToStream записват WordprocessingML пакет, съдържащ параграфи, заглавия, native номерация на списъци, разпознати таблици, стилизиране на шрифта, разделители на страници и позиционирани PNG изображения
И двата пътя работят изцяло в Pascal, на сървър, без инсталиран Word и без COM. Точно това ограничение е причината функцията да съществува в PDF библиотека, а не в настолен инструмент
Защо „PDF към Word“ наистина е трудно?
Защото PDF страница не съдържа параграфи. Тя съдържа оператори за показване на текст, които поставят поредици от глифи на координати, в какъвто ред производителят ги е изписал, без задължение да означи, че две поредици принадлежат на едно и също изречение, камо ли на един и същ елемент от списък. Форматът е проектиран да опише отпечатана страница точно и успява в това, като изхвърля структурата, произвела страницата
Затова всеки конвертор трябва да възстанови онова, което генераторът е изхвърлил. Групирането на редове идва от вертикалните разстояния и подравняването по базова линия. Границите на параграфи идват от промени в разстоянията и отстъпите. Заглавие е ред, чийто шрифт е по-голям или по-плътен от основния текст и се откроява от онова, което следва. Списък е поредица от параграфи, започващи с знак за водещ символ или числов образец. Таблица е решетка от текстови блокове, чиито ръбове се подравняват през редове и колони. Всяко от тези е предположение, а предположението означава добър резултат при документи, следващи обичайните типографски конвенции, и посредствен при документи, които не ги следват
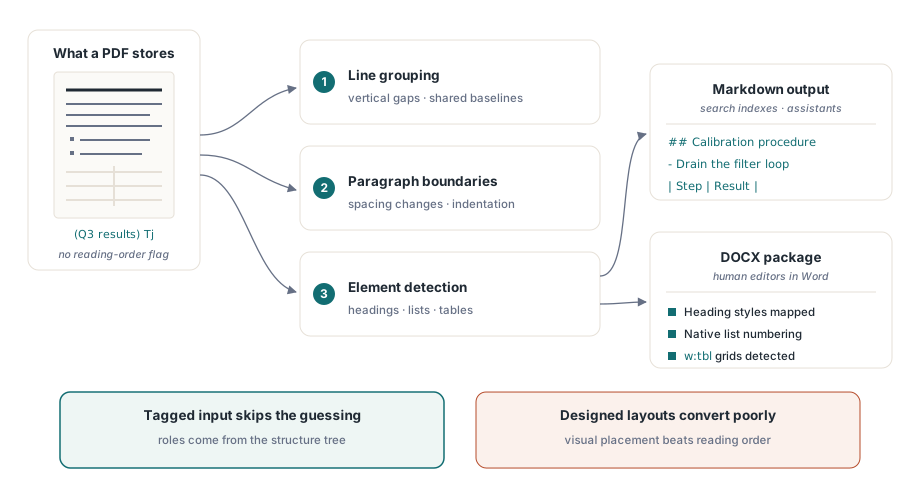
Таг-ираните PDF документи са изключението, и то голямо. Когато документът носи дърво на структурата, ролите на параграф, заглавие, списък и таблица са записани, а не отгатнати, което е причината работата по достъпност, описана в структурата за достъпност на таг-иран PDF, да се отплаща и при конвертиране. Ако контролирате производителя, таг-ирането на изхода ви е единственото действие с най-голяма възвръщаемост за всеки, който по-късно трябва да го конвертира
Изнасяне в Markdown, страница по страница
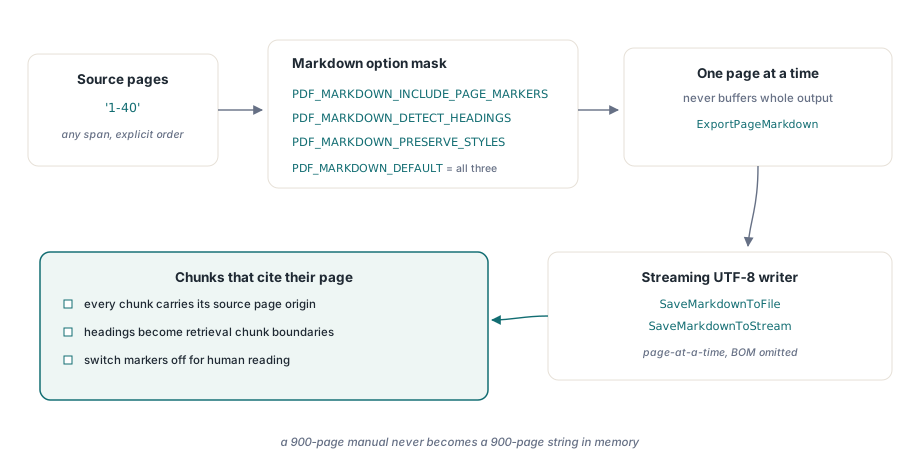
Пътят през Markdown е онзи, към който да посегнете, когато крайната цел е текстов конвейер: сайт с документация, търсещ индекс, retrieval корпус за асистент. Опциите са битова маска: PDF_MARKDOWN_INCLUDE_PAGE_MARKERS, PDF_MARKDOWN_DETECT_HEADINGS, PDF_MARKDOWN_PRESERVE_STYLES, като PDF_MARKDOWN_DEFAULT комбинира и трите
var
  Pdf: TPDFlib;
  Md: WideString;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('handbook.pdf', '');

    // Една страница, като низ
    Md := Pdf.ExportPageMarkdown(1, PDF_MARKDOWN_DEFAULT);

    // Диапазон от страници, записан поточно на диска като UTF-8 без BOM
    Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_DETECT_HEADINGS or PDF_MARKDOWN_PRESERVE_STYLES,
      'handbook.md');
  finally
    Pdf.Free;
  end;
end;
Маркерите за страници се отплащат в retrieval работата. Откъс текст, който носи страницата, от която идва, може да бъде цитиран точно, а читател, който следва цитата, попада точно там, където твърдението наистина се намира. Изключете ги, когато Markdown-ът е предназначен за човешко четене, където границите на страници от изходното оформление са шум
Поточните входни точки имат значение за големи документи. SaveMarkdownToStream и SaveMarkdownToFile записват UTF-8 страница по страница и не буферират целия изход, така че наръчник от 900 страници не се превръща първо в низ от 900 страници в паметта. Отсъствието на byte-order mark също е съзнателно: BOM в Markdown файл обърква изненадващо много генератори на статични сайтове и diff инструменти
DOCX без Office на машината
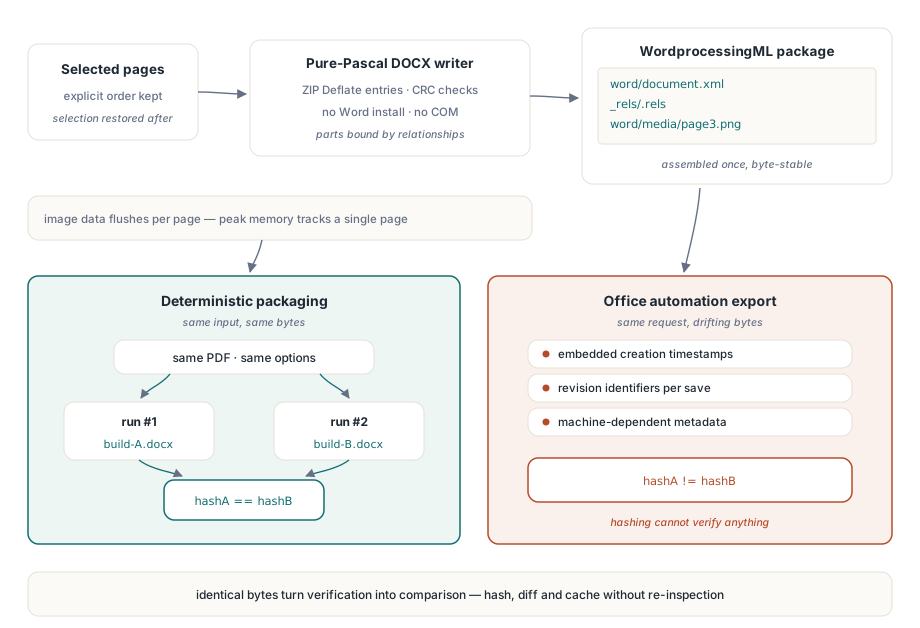
DOCX writer-ът произвежда самия пакет: ZIP записи, записани като суров Deflate с CRC проверки, WordprocessingML частите и връзките, които ги обвързват. Нищо не извиква Word, което означава, че конвертирането работи на headless сървър, вътре в service account, в контейнер, навсякъде, където Office automation е или нелицензиран, или нестабилен, или забранен
var
  Pdf: TPDFlib;
  Target: TFileStream;
begin
  Pdf := TPDFlib.Create;
  Target := TFileStream.Create('handbook.docx', fmCreate);
  try
    Pdf.LoadFromFile('handbook.pdf', '');
    Pdf.SaveDOCXToStream('1-40',
      PDF_DOCX_INCLUDE_IMAGES or PDF_DOCX_DETECT_HEADINGS or
      PDF_DOCX_PRESERVE_STYLES or PDF_DOCX_PRESERVE_PAGE_BREAKS,
      Target);
  finally
    Target.Free;
    Pdf.Free;
  end;
end;
Данните за изображения се записват при обработката на всяка страница, а не се събират и добавят накрая, така че пиковата памет следва една страница, а не целия документ. Изричният ред на страниците се запазва, а избраната PDF страница се възстановява след това, което има значение, когато изнасянето е една стъпка в по-дълга задача, при която е била избрана страница по други причини
Какво печелите от детерминистичното пакетиране?
Възпроизводимост байт по байт. Две конвертирания на един и същ вход с едни и същи опции произвеждат един и същ пакет, което означава, че можете да хеширате изхода, за да засечете промяна, да сравните две компилации на генериран документ и да кеширате агресивно, без да се притеснявате, че еднакъв вход е произвел различен артефакт
Office automation не може да обещае това. Тя вгражда времеви маркери, идентификатори на ревизии и машинно зависими метаданни, така че един и същ документ, конвертиран два пъти, се различава по начини, които осуетяват хеширането. Същото разсъждение стои зад детерминистичните идентификатори на файлове, разгледани в детерминистичните PDF ID за възпроизводими компилации: когато изходът е възпроизводим, проверката става сравнение, а не инспекция
Къде изходът е добър и къде не е
Бъдете честни с потребителите си по този въпрос, защото качеството на конвертиране варира повече в зависимост от входа, отколкото от конвертора. Таг-ирани PDF документи и чисто генерирани бизнес документи — фактури, отчети, договори — се конвертират добре: заглавията стават заглавия, таблиците оцеляват, списъците се пренумерират правилно в Word. Двуколонни академични оформления се конвертират приемливо, ако геометрията на колоните е регулярна. Таблици, разпростиращи се през прекъсвания на страници, се пресъбират чрез предположение и понякога се разделят. Силно дизайнерски маркетингови материали, при които текстът е поставен за визуален ефект, а не в ред на четене, се конвертират зле, и никакво количество предположения не поправя това
Сканираните документи са напълно отделен случай. Страница, която е едно голямо изображение, не съдържа текстови обекти, така че няма какво да се изнесе, докато не съществува текстов слой; пътят на OCR, който го произвежда, е предпоставка, а не опция. Преди да пуснете голяма партида, вземете десетина представителни файла и разгледайте изхода, а помислете и за изброяване на елементите на страницата, както е описано в търсенето на текст и изброяването на елементи на страница, за да видите какво реално съдържат страниците
За асистентски и retrieval конвейери пътят през Markdown обикновено е по-добрата цел: заглавията стават граници на откъси, таблиците остават четими като таблици с вертикална черта, а маркерите за страници дават на всеки откъс цитируемо местоположение. За човешко редактиране DOCX е отговорът, защото онова, което потребителят иска, не е текстът, а възможността да го промени
PDF Library for Delphi е PDF библиотека за Delphi, C++Builder и Lazarus със съответстващи DLL и ActiveX интерфейси, така че същите извиквания за изнасяне са достъпни от C#, C++ или скриптови хостове. Пълната документация и пробна версия са на страницата на PDF Library for Delphi PDF библиотеката за Delphi