PDF Library for Delphi записва диапазоните на page labels с AddPageLabels, а от v3.539.10 насам същото извикване работи и върху заредени файлове, чийто /PageLabels number tree е разцепен на /Kids възли: коренът се изравнява в единствен /Nums лист, преди новият диапазон да влезе, така че етикетът наистина се появява във viewer-а, вместо да бъде тихо игнориран. Типичната жертва е PDF в стил книга от layout инструмент, с римски цифри в предния апарат, арабска нумерация в тялото и приложение, етикетирано A-1, A-2, при което сте искали да презапишете само приложението — и нищо не се беше променило
Какво са PDF page labels и как се съхраняват?
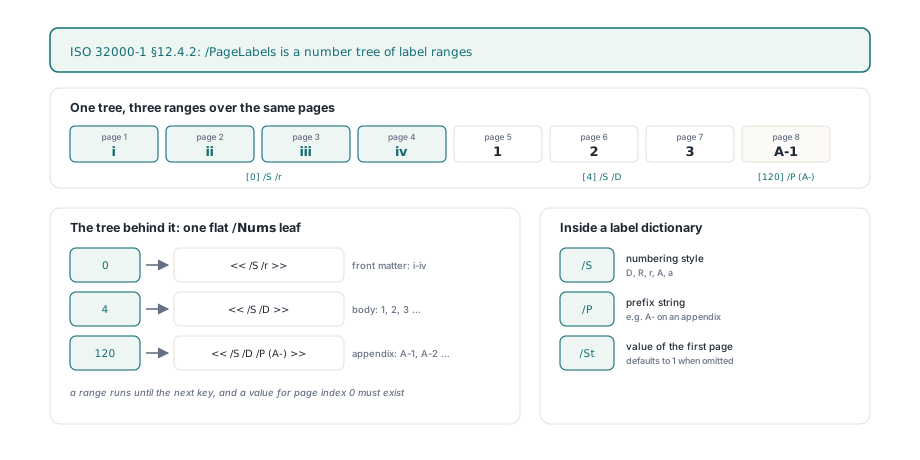
Page labels са низовете, които viewer-ът показва в своя page box вместо физическия индекс на страницата, а ISO 32000-1 §12.4.2 ги съхранява като number tree под catalog ключа /PageLabels. Всеки ключ е индекс на страница от нулата, който започва диапазон на етикетиране, а всяка стойност е речник за page label с до три записи: /S за стила на нумерацията (D, R, r, A или a), /P за prefix низ и /St за числовата стойност на първата страница в диапазона, която по подразбиране е 1. Диапазонът тече до следващия ключ, а спецификацията изисква дървото да съдържа стойност за индекс 0, така че всяка страница е покрита от някой диапазон
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Страници 1-4: i, ii, iii, iv (малък римски стил)
    Lib.AddPageLabels(1, 3, 1, '');
    // Страници 5-120: 1, 2, 3 ... (десетичен)
    Lib.AddPageLabels(5, 1, 1, '');
    // Страници 121 нататък: A-1, A-2 ... (десетичен с префикс)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
TPDFlib.AddPageLabels(Start, Style, Offset, Prefix) мапва аргументите си върху този речник без изненади, щом знаете три правила. Start е от 1, като всеки друг page аргумент в библиотеката, и се записва в дървото като Start - 1. Style върви от 0 до 5, като 0 значи само префикс, а 1 до 5 стават /S стойностите D, R, r, A и a; всичко извън този диапазон връща 0 и не пипа нищо. Offset става /St само когато е по-голям от нула, така че подаване на 0 просто пропуска ключа и viewer-ът се връща на подразбиранието 1. Понеже page labels идват с PDF 1.3, извикването пуска и EnsureMinVersion('1.3', '/PageLabels'), което вдига изходната версия на по-стар файл, освен ако изрично не сте заключили версията при запис
Защо новите page labels изчезват, когато дървото има /Kids?
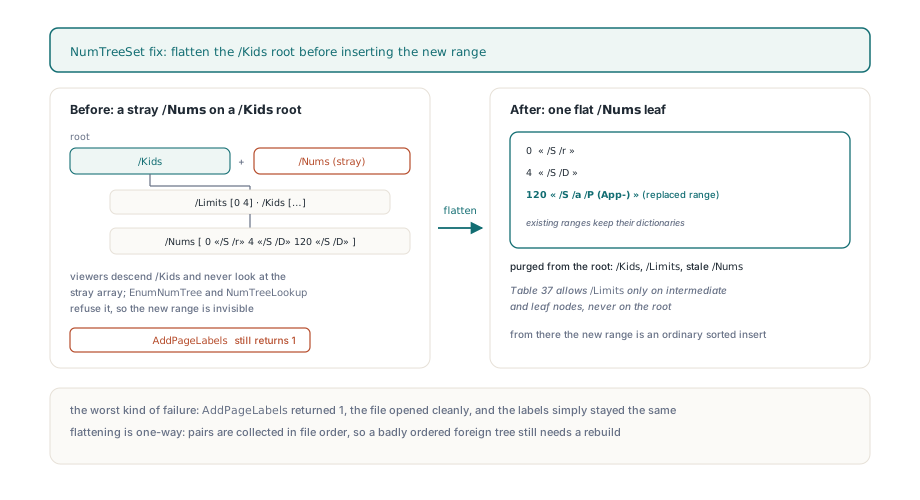
Новите етикети изчезват, защото ISO 32000-1 §7.9.7 (Table 37) изисква коренът на number tree да носи или /Kids, или /Nums, никога и двете, а по-старият helper NumTreeSet знаеше само да търси /Nums. Производителите на дълги документи често разцепват дървото на междинни възли, всеки с двойка /Limits, и ги закачат за корен, който има само /Kids. Старият код не намираше /Nums на този корен, създаваше свеж до съществуващия /Kids и вмъкваше новия диапазон там. Резултатът беше корен с два взаимно изключващи се входа. Viewer-ите слизаат през /Kids и никога не поглеждат заблудилия се масив, собственият EnumNumTree на библиотеката също проверява първо /Kids, а NumTreeLookup отказва възел, при който HasKids xor HasNums не е верно. AddPageLabels продължаваше да връща 1 и записаният файл се отваряше чисто, което е най-лошият вид провал: нищо не се оплаква, етикетите просто си остават същите
Поправката в NumTreeSet превръща корена в лист, преди да вмъкне нещо. Когато коренът носи /Kids, EnumNumTree обхожда всеки лист по ред и събира всяка двойка ключ-стойност, от този списък се строи нов плосък /Nums масив, а /Kids, /Limits и всякакви остарели /Nums се изчистват от корена, преди плоският масив да се закачи. Отпадането на /Limits не е козметично, защото Table 37 позволява този запис само на междинни и листни възли, никога на корен. Оттам нататък вмъкването е обикновено сортирано вмъкване в един масив, а съществуващите диапазони оцеляват със своите оригинални label речници. Компромисът е нарочен: дървото не се rebuild-ва после в балансирани /Kids възли. За page labels това не струва нищо, защото дори голям справочник рядко има повече от няколко десетки диапазона, а един-единствен лист е това, което повечето производители изобщо пишат
// Презапишете етикета на приложението във файл, чийто /PageLabels корен ползва /Kids
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // напр. A-1
  // Заменете диапазона, започващ на страница 121: App-a, App-b ...
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  // Съществуващите римски и десетични диапазони си остават в изравнения лист
  WriteLn('After: ', Lib.GetPageLabel(121));   // App-a
  WriteLn('Front: ', Lib.GetPageLabel(2));     // ii, непроменен
end;
Как /Nums масив може да бъде прочетен погрешно като ключове?
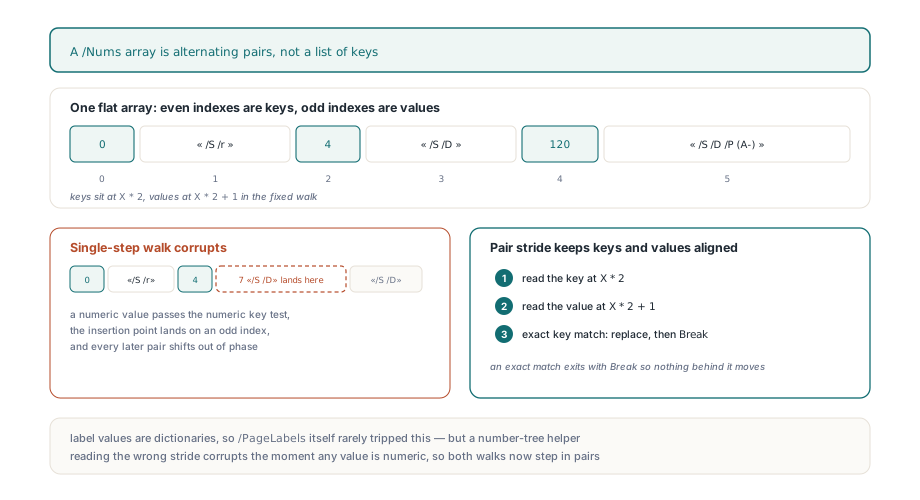
/Nums масив се чете погрешно, когато кодът го обходи елемент по елемент, защото масивът е плоска серия от редуващи се двойки, [key0 value0 key1 value1 ...], и само четните позиции са ключове. Старият цикъл на NumTreeSet тестваше всеки елемент за числов тип, така че стойност, оказала се число, се сравняваше все едно е ключ; попадение „по-малко от" можеше да сложи точката на вмъкване на нечетен индекс и да пусне новата двойка в средата на съществуваща, измествайки всяка следваща двойка от фаза. EnumNumTree имаше същото едностъпково обхождане. И двете вече итерират по двойки със стъпка две, четейки ключа на X * 2 и стойността на X * 2 + 1, а пълно съвпадение на ключ замества стойността и излиза с Break. В чест на стария код: стойностите на page labels са речници, така че този втори бъг рядко палеше върху самия /PageLabels, но number-tree helper, който чете грешната стъпка, е развален в момента, в който някоя стойност е число, и беше оправен в същия проход
Четене на етикетите обратно и round trip през текст
TPDFlib.GetPageLabel(Page) връща етикета на страница, броена от 1, и има два fallback-а, които си струва да знаете. При липса на какъвто и да е /PageLabels запис връща десетичния номер на страницата, така че извикващият може да го ползва безусловно. При налично дърво, но без диапазон, покриващ страницата, връща празен низ — точно това става, когато файл пропусне задължителния запис за индекс 0; референтната документация казва, че диапазон, започващ на страница 1, трябва да съществува, за да се показват етикетите коректно, а кодът прави това изискване видимо. Буквените стилове следват спецификацията, а не колоните на spreadsheet: след Z идва AA, после BB — повторение на буквата, вместо пренос
var
  P: Integer;
  Data: WideString;
begin
  // Бърз одит на това какво viewer-ът ще покаже в своя page box
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // Стойност на опцията 4 експортира само label диапазоните като PageLabelBegin записи
  Data := Lib.ExportDocumentData(4);
  // Импортът ги изпълнява наново чрез ClearPageLabels + AddPageLabels
  Lib.ImportDocumentData(Data, 0);
end;
За масови редакции ExportDocumentData със стойност на опцията 4 записва всеки диапазон като блок PageLabelBegin с редове PageLabelNewIndex, PageLabelStart, PageLabelPrefix и PageLabelNumStyle, а ImportDocumentData приема първия label запис, който види, за пълно заместване: вика ClearPageLabels веднъж и после подава всеки запис на AddPageLabels. Това прави текстовия round trip детерминиран дори когато оригиналният файл е ползвал /Kids дърво, защото изчистването маха целия catalog запис, а преизграденото дърво е единствен лист още от началото
Какво поправката и пак не гарантира?
Изравняването е еднопосочно и вярва на реда, който намери. EnumNumTree събира двойките в реда на файла, а GetPageLabel прилага последния диапазон, чийто ключ е по-малък или равен на индекса на страницата, така че чужд файл с листи извън реда — който §7.9.7 забранява, но който се разхожда из дивото — пак може да даде грешни етикети, докато не преизградите диапазоните с ClearPageLabels и свежи извиквания на AddPageLabels. Етикетите са вързани и за индексите на страниците, не за page обектите, така че всяка операция, сменяща броя или реда на страниците, оставя диапазоните там, където са били. Размяна на място като замяната на страници със запазени номера на обекти пази броя и затова етикетите остават верни, докато merge като сортирането на преплетени duplex сканирания ражда нова последователност от страници, която заслужава свежо записан набор диапазони
Извикванията за page labels, обработката на number tree и export/import-ът на документни данни, описани тук, излизат в PDF Library for Delphi за Delphi, C++Builder и Lazarus, с референтния запис за AddPageLabels, документиращ style стойностите и return кодовете