Речникът на един LZW енкодер винаги е с един запис напред пред декодера, който ще чете неговия изход, затова двете страни не могат да споделят един праг за ширината на кода. PDFlibPas дава на TPLLZWEncoder и TPDFLZWDecompressor отделни прагове, изведени от същия флаг EarlyChange, а това изпреварване с един запис е цялата причина флагът изобщо да съществува
Почти всяка ръчно написана LZW имплементация сбърква това на едно и също място. Първо пишете декодера, защото той ви трябва, за да отваряте файлове. Работи. После пишете енкодера, огледално копирате логиката на декодера ред по ред, защото LZW е симетричен, пускате round-trip тест, и той минава. Пускате в production. Шест месеца по-късно клиент отваря изхода ви във viewer, който не е ваш, и от средата на потока нататък е боклук. Огледалото е било бъгът: двете половини на LZW не са симетрични, а преструвката, че са, произвежда потоци, които само вашият код може да чете
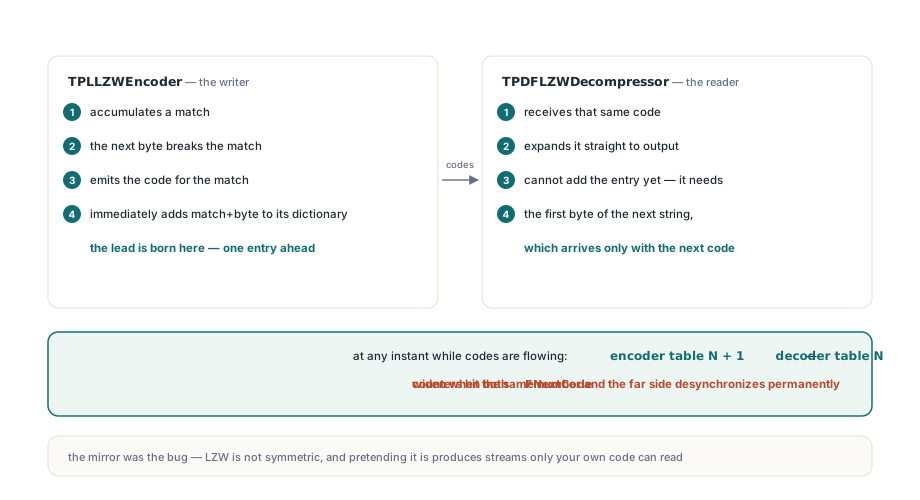
Защо енкодерът има нужда от различен праг от декодера?
Защото енкодерът научава всеки речников запис една стъпка по-рано, отколкото декодерът може. Това не е дизайнерско решение в PDFlibPas; то е присъщо на начина, по който работи LZW, и всяка коректна имплементация трябва да го компенсира някъде. Минавате по цикъла и виждате откъде идва изпреварването. Енкодерът натрупва съвпадение, открива, че следващият байт го чупи, излъчва кода за съвпадението и веднага добавя съвпадение-плюс-байт към речника си. Декодерът получава същия код и го разширява, но все още не може да добави съответния запис, защото новият запис се нуждае от първия байт на следващия string, който пристига едва със следващия код. Така във всеки момент, докато кодовете текат, таблицата на енкодера държи един запис повече от таблицата на декодера. Ако двете страни разширят кода от 9 на 10 бита, когато собственият им FNextCode удари същото число, те се разминават с един код и bit reader-ът на отсрещната страна се десинхронизира завинаги. В TPDFLZWDecompressor.ResetDictionary прагът на декодера се изчислява веднъж и се пази в FChangeCode:
// TPDFLZWDecompressor.ResetDictionary: страната на декодера при прага
FCodeSize := FInitialCodeSize;                 // 9 за PDF LZWDecode
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // се разширява, когато FNextCode достигне 511
else
  FChangeCode := FBitMask + 1;                 // се разширява, когато FNextCode достигне 512
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
Цикълът за декодиране разширява веднага след като добави запис, тествайки (FNextCode = FChangeCode) and (FCodeSize < 12) и преизчислявайки и FBitMask, и FChangeCode за новата ширина. Девет бита се превключват при 511 или 512, десет бита при 1023 или 1024, единайсет бита при 2047 или 2048, а дванайсет бита е таванът, където речникът трябва да бъде изчистен с ClearCode, вместо да расте. Енкодерът не може да преизползва нито едно от тези числа. Неговият GrowCodeSize добавя единица, за да компенсира изпреварването, така че с вдигнат EarlyChange той разширява при 512, докато декодерът разширява при 511:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 while at 9 bits
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 while at 9 bits
  // Декодерът добавя последния си висящ запис, преди да прочете EOI.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;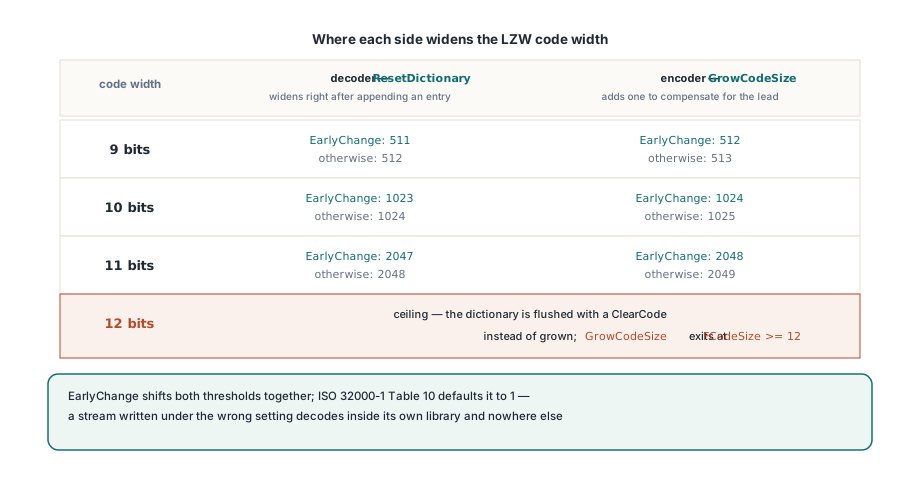
Последният data код е мястото, където двете страни най-сетне се срещат
Краят на потока е единственото място, където енкодерът трябва да спре да води и да мисли като декодер — точно за това е параметърът FinalDataCode на GrowCodeSize. Излъчете EOI кода с грешна ширина и всичко преди него си остава напълно валидно, така че дефектът се крие зад хиляди коректни байта. Последователността е следната. Енкодерът излъчва финалния си data код и, за разлика от всяка по-ранна итерация, после не добавя нищо към речника си, защото не е останал следващ байт, с който да удължи съвпадението. Декодерът прави обратното: получава този финален код и едва сега може да довърши записа, който е държал от предишния. На последната стъпка декодерът настига, изпреварването пада до нула, а ширината, с която ще чете EOI, се решава от запис, който енкодерът никога не е правил. Dec(ChangeCode) е енкодерът, който за точно едно извикване се преструва, че е декодер:
// TPLLZWEncoder.Compress, опашката на потока
EmitCode(CurCode);      // финалният код на данните, при каквато и да е текущата ширина
GrowCodeSize(True);     // може да се разшири, използвайки намаления праг
EmitCode(FEOICode);     // EOI с ширината, с която декодерът реално ще чете
FlushBits;
FlushOutput;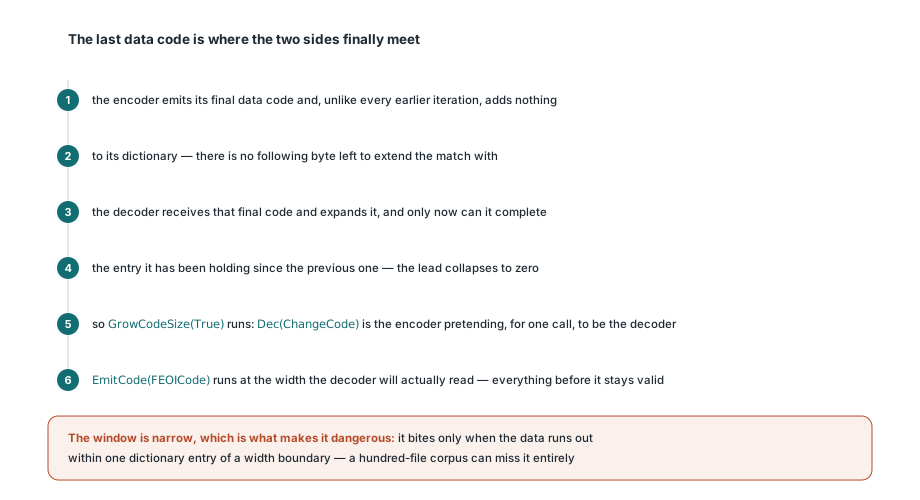
Прозорецът, в който това има значение, е тесен — точно това го прави опасен. Той хапе само когато данните случайно свършат в рамките на един речников запис от граница на ширината, така че корпус от сто тестови файла може изцяло да го пропусне, докато един клиентски файл го уцелва всеки път. Граничните случаи в Compress трябва да се карат умишлено: измислете входове, чийто речник спира на 510, 511 и 512 записа, после прочетете излъчената EOI битова ширина от потока на ръка, вместо да я извеждате от успешно декодиране
Защо минаващият round-trip тест все още може да скрие счупен поток?
Защото две имплементации, които правят една и съща грешка, са съгласни една с друга. Ако енкодерът ви и декодерът ви разширяват и двата един код твърде рано, или и двата един код твърде късно, те остават в крачка, round trip-ът възпроизвежда входа байт за байт, а тестовият пакет е зелен, докато потокът, който сте произвели, е нечетим за всичко друго. Това е най-ценното, което можете да изнесете от цялото упражнение: за LZW самосъгласуваността не струва нищо като доказателство. Затова само round-tripping не може да е основният тест, а PDFlibPas валидира LZW пътя по три други начина. Ръчно построени code потоци с очаквания битов модел, изписан на ръка, така че твърдението е за байтовете, а не за резултата от декодирането им. Двупосочна интероперабилност срещу независими имплементации, където потоци, произведени от този енкодер, се декодират другаде, а потоци, произведени другаде, се декодират от TPDFLZWDecompressor. И диференциално декодиране — четене на същите байтове два пъти с EarlyChange, вдигнат и в двете посоки, така че поток, който се декодира чисто при грешната настройка, ви казва, че границите на ширината изобщо не са били преминати:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // съзнателно грешното правило за PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A трябва да съвпада с източника; B не трябва да съвпада с него. Ако B също съвпада,
// входът беше твърде кратък, за да премине границата на ширината на кода.
Външните входове са това, което действително дава това покритие. Текущият тестов материал пресича ширини от 9, 10, 11 и 12 бита и принуждава 34 речникови нулирания в един поток — единственият реалистичен начин да се докаже, че ClearCode пътят при тавана 4095 изобщо работи. Ако вашите fixtures никога не надхвърлят няколко килобайта, нито един от тези кодове не е вървял. И когато поправка промени това, което енкодерът ви произвежда, третирайте стария изход като счупен, а не като baseline за съвместимост, който си струва да се пази; поток, който смесва ширините на кодовете неправилно, не е legacy формат, а бъг, който случайно е бил записан на диска
PDF казва 1, TIFF казва зависи
PDFlibPas подразбира EarlyChange на True и в TPLLZWEncoder, и в TPDFLZWDecompressor, защото ISO 32000-1 Table 10 дефинира EarlyChange като LZWDecode decode параметър със стойност по подразбиране 1, което означава, че дължината на кода се увеличава един код по-рано. Това е указано в ISO 32000-1, раздел 7.4.4.2, заедно с predictor параметрите, а PDF, който иска другото поведение, трябва изрично да каже /EarlyChange 0 в речника си /DecodeParms. TIFF е причината флагът да е свойство, а не константа: раздел 13 на TIFF 6.0 описва LZW компресията без същото еднозначно изказване, а енкодерите в дивата природа исторически са се разделяли по въпроса — много вероятно затова PDF спецификацията изобщо е усетила нуждата да назове параметъра. В TIFF-към-PDF pipeline настройката затова не е нещо, което можете да hardcode-нете на нито един от двата края. Каквото и да се е оказало нужно на TIFF страната, трябва да се пренесе изрично в PDF /DecodeParms, иначе конвертирате файл, който се е отварял добре, в такъв, който не се. Същата грижа важи за FillOrder, където foTop и foBottom избират от кой край на байта bit reader-ът запълва, и за TIFF Predictor 2 хоризонталното диференциране, което TPDFLZWParms носи през Predictor, Colors, BitsPerComponent и Columns. Нашите бележки за втвърдяването на вградения TIFF декодер за BigTIFF и tiled оформления покриват останалата част от този път
Два по-дребни капана, които си струва да назовем
И двата са лесни за свързване наопаки, когато имате енкодерът и декодерът отворени един до друг и предположите, че симетрията важи и тук:
InitialCodeSizeне означава едно и също нещо в двата класа.TPLLZWEncoder.InitialCodeSizeе ширината на кореновия символ, валидирана от 2 до 8, катоInitDictionaryизвеждаFClearCodeкато1 shl FInitialCodeSizeи задаваFCodeSizeнаFInitialCodeSize + 1.TPDFLZWDecompressor.InitialCodeSizeе първата ширина на кода, валидирана от 2 до 9, катоResetDictionaryизвеждаFClearCodeкато1 shl (FCodeSize - 1). За обикновени 8-битови PDF данни стойностите по подразбиране са съответно 8 и 9 и никога не забелязвате; задайте и двете на едно и също число на ръка и сте построили несъвпадаща двойка- Декодирането на недоверен LZW е проблем за безопасността на паметта, преди да е проблем за коректността, защото речниковите индекси идват направо от файла.
TPDFLZWDecompressorотхвърля всеки код над 4095 или равен/по-голям отFNextCode, отказва да добавя записи след 4095, проверява оставащия вход в битове преди всякоGetNextCodeи излагаSawExplicitEOI, така че caller-ът да различи коректно завършен поток от такъв, който просто е свършил байтовете. Осечен поток не е частичен успех. По-широкият преглед в втвърдяването на Pascal PDF parser срещу злонамерени файлове покрива класа дефекти, които тези защити затварят
С какво ви оставя това
LZW изглежда симетричен, а не е. Речникът на енкодера води с един запис през тялото на потока, а изпреварването изчезва при финалния код, така че коректната имплементация носи два прага плюс един специален случай, а флагът EarlyChange мести и двата прага заедно. Сбъркайте който и да е от тях с един код и произвеждате изход, който е валиден точно докато не е — без грешка и без изключение никъде, просто някъде един viewer рендерира шум. Честната граница е, че нищо от това не е тестируемо отвътре: нищо в собствения ви пакет не може да различи коректен поток от последователно грешен, така че проверката за интероперабилност не е незадължителен допълнителен pass — тя е единственото реално доказателство, което някога ще получите. И двата класа се доставят в PDF Library for Delphi, която също се грижи за обграждащата структурна работа, описана в бележките ни за object streams и cross-reference streams, за Delphi и C++Builder във всички версии на компилатора, които библиотеката поддържа