Преди v3.539.24 Free Pascal build-ът на PDF Library for Delphi компресираше големите потоци на парчета по 64 KB и даваше на всяко парче собствен zlib header и checksum, така че attachment от 1 MiB се превръщаше в шестнайсет залепени един към друг zlib членове. ISO 32000-1 FlateDecode очаква точно един zlib stream, а стандартен decoder спира на първия end-of-stream маркер, което означава, че всичко след първите 65 536 байта изчезваше тихо. Поправката поддържа едно zlib state живо през всички парчета и в DeflateStream, и в InflateStream
Бъгът съществуваше само във FPC частта на unit-а и само по chunked streaming пътя, което е точно причината той да оцелее: Delphi клонът беше винаги коректен, string базираните helper-и бяха винаги коректни, а малките тестови payload-и изобщо не стигаха до chunked кода. Той е близък роднина на дефектите в петте FPC porting бъга, които Delphi криеше, само че тук Delphi build-ът не прикриваше нищо. FPC клонът просто беше написан срещу грешна представа какво всъщност е zlib stream
Защо други PDF четци режат chunked zlib stream?
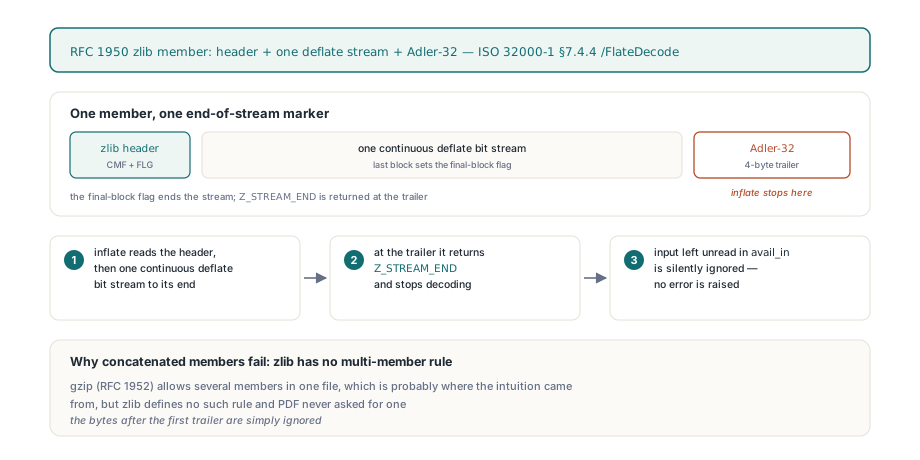
Защото zlib stream по RFC 1950 е един контейнер, а не поредица от тях, а коректен inflater приема първия Adler-32 trailer за край на данните. Форматът е двубайтов header, един непрекъснат deflate бит stream по RFC 1951, чийто последен блок носи final-block флага, и четирибайтов Adler-32 checksum върху всички некомпресирани байтове. ISO 32000-1 §7.4.4 дефинира /FlateDecode точно в тези термини. Когато inflate стигне до trailer-а, връща Z_STREAM_END и оставя остатъка от входа непрочетен в avail_in. От негова гледна точка нищо не е наопаки, затова не вдига грешка, а байтовете след trailer-а просто се игнорират. Слепените членове са легитимна идея в gzip (RFC 1952 позволява няколко члена в един файл), откъдето вероятно идва и интуицията, но zlib няма такова правило, а PDF никога не го е искал
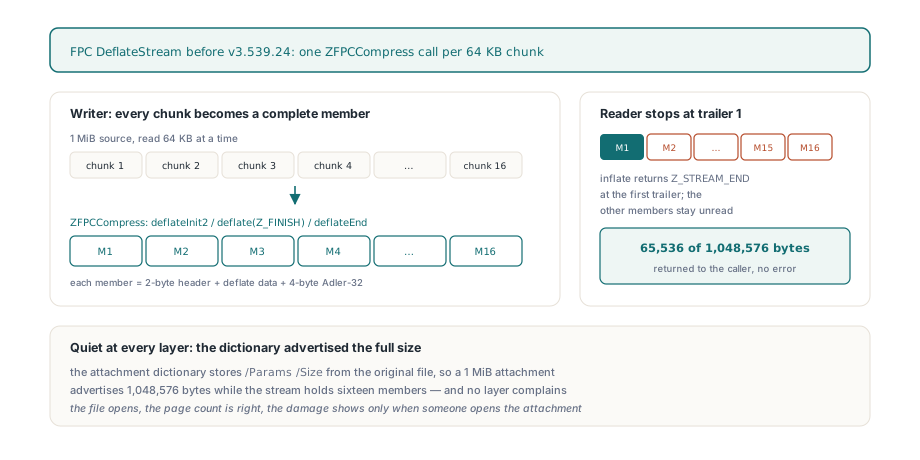
Старият FPC DeflateStream четеше източника по 64 KB и подаваше всяко парче на ZFPCCompress — helper, който пуска собствен deflateInit2, компресира с Z_FINISH и вика deflateEnd. Всяко парче излизаше затова като пълен, валиден, самозавършващ се zlib stream, а функцията слепваше парчетата в един AnsiString, преди да го запише. Резултатът изглеждаше като Flate данни, имаше коректен header и се декодираше без грешка, но се декодираше само до първите 65 536 байта. На страната на четенето InflateStream имаше огледалния дефект: викаше ZFPCInflate по веднъж на всеки 64 KB компресиран вход, а всяко извикване стартираше свеж inflateInit2. Второто парче започва по средата на deflate бит stream без zlib header, така че нов inflater го отхвърля, а напълно нормален едночленен stream от друг производител се декодираше само доколкото го носеха първите му 64 KB компресирани байтове
// FPC DeflateStream преди v3.539.24 (опростено):
// ZFPCCompress върши deflateInit2 / deflate(Z_FINISH) / deflateEnd,
// така че всяко парче от 64 KB става отделен zlib член
Repeat
  ReadCount:= Source.Read(Input[1], ChunkSize);
  If (ReadCount> 0) Then
    Compressed:= Compressed+ ZFPCCompress(Copy(Input, 1, ReadCount), 6, False);
Until (ReadCount< ChunkSize);
If (Compressed<> '') Then
  Target.WriteBuffer(PAnsiChar(Compressed)^, Length(Compressed));
Кои извиквания на PDF Library for Delphi стигаха до chunked пътя?
На FPC всеки вграден файл от 1 MiB нагоре се записваше зле, а всеки Flate stream, извлечен чрез streaming API, се четеше зле щом компресираният му размер минеше едно парче. TPDFStream.ReadFromStream решава как да кодира входящите данни. Когато Deflate е true и Stream.Size >= 1048576, предава ги през DeflateStream; под този праг чете целия източник в паметта и вика DeflateStr — едношатовия helper, който никога не е бил засегнат. ASCII85-plus-Flate филтърната верига прескача теста за размер и винаги минава през DeflateStream, така че по този път всеки payload над 64 KB вече се разпадаше на няколко члена. Публичните входни точки, които захранват ReadFromStream с включена компресия, са writer-ите за вградени файлове:
TPDFlib.EmbedFileиTPDFlib.AddEmbeddedFile, които четат файл от диска в/EmbeddedFilestreamTPDFlib.AddAssociatedFileFromStreamиTPDFlib.AddAssociatedFileFromFile, writer-ите за PDF/A-3 associated file, ползвани за e-фактура XML и други изходни данни- На страната на четенето,
TPDFlib.GetEmbeddedFileContentToStreamиGetEmbeddedFileContentToFile, които декодират презTPDFStream.WriteDecodedToStreamи оттам презInflateStream
Отказът беше тих на всеки слой. Writer-ът записва /Params /Size и MD5 /CheckSum, сметнат от оригиналния файл, така че речникът на attachment-а обявяваше пълния размер, докато stream-ът държеше шестнайсет члена. Delphi build на същата библиотека, четящ такъв файл, спираше чисто на първия Z_STREAM_END и връщаше точно 65 536 байта. GetEmbeddedFileContentToStream връщаше 1, защото съобщава дали декодирането е вдигнало грешка, а не дали изходът съвпада с /Size. Който е гонил проблем с голям документ през сливането и разделянето на гигабайтни PDF-и, познава този модел: файлът се отваря, броят страници е верен, а щетите се показват чак когато някой отвори attachment-а
Едно deflate state през всички парчета
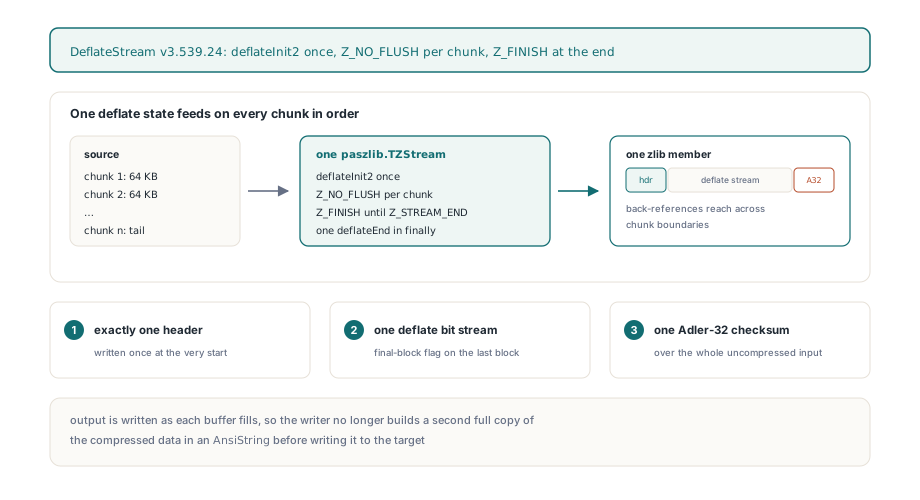
Поправеният DeflateStream в PDFlibZLib.pas инициализира един paszlib.TZStream, подава всяко парче на deflate с Z_NO_FLUSH и едва накрая изпразва компресора с Z_FINISH, докато върне Z_STREAM_END. Така излизат точно един header, един deflate бит stream, чиито back-references могат да прескачат границите между парчетата, и един Adler-32 върху целия вход. FPC клонът вече има същата структура, която Delphi клонът е имал винаги. Той също записва изхода веднага щом се произведе, вместо първо да сглоби целия компресиран резултат в AnsiString, така че writer-ът вече не строи второ пълно копие на компресираните данни в паметта, преди да ги копира в целта
// FPC DeflateStream от v3.539.24 (грешковите пътища са съкратени)
If (deflateInit2(strm, Level, Z_DEFLATED, 15, 8, Z_DEFAULT_STRATEGY)<> Z_OK) Then
  Exit;
Try
  Repeat
    ReadCount:= Source.Read(Input[0], ChunkSize);
    If (ReadCount> 0) Then
    Begin
      strm.next_in:= Pointer(Input);
      strm.avail_in:= ReadCount;
      While (strm.avail_in> 0) Do
      Begin
        strm.next_out:= Pointer(Output);
        strm.avail_out:= ChunkSize;
        Status:= deflate(strm, Z_NO_FLUSH);   // същото state, без членна граница
        Produced:= ChunkSize- strm.avail_out;
        If (Produced> 0) Then
          Target.WriteBuffer(Output[0], Produced);
        If (Status<> Z_OK) Then
          Break;
      End;
    End;
  Until (ReadCount< ChunkSize);
  Repeat                                    // един trailer за целия вход
    strm.next_out:= Pointer(Output);
    strm.avail_out:= ChunkSize;
    Status:= deflate(strm, Z_FINISH);
    Produced:= ChunkSize- strm.avail_out;
    If (Produced> 0) Then
      Target.WriteBuffer(Output[0], Produced);
  Until (Status= Z_STREAM_END);
Finally
  deflateEnd(strm);
End;
InflateStream получи симетричното пренаписване: един inflateInit2, вътрешен цикъл, който продължава да вика inflate, докато текущото парче се изразходва и изходният буфер вече не е пълен, и стоп на Z_STREAM_END. Има един страничен ефект, който си струва да знаете. Старият chunked writer беше закодил ниво 6, а новият уважава PLDeflateLevel, така че ниво, зададено чрез TPDFlib.SetCompressionLevel(1..9), вече важи и за големите вградени файлове на FPC. Това има значение, ако вече настройвате компресията за архивен изход, както е описано в намаляването на размера на PDF файлове в Delphi
Как проверявате дали Flate stream е един-единствен zlib член?
Надуйте го с обикновен zlib decoder и при връщане на Z_STREAM_END проверете две неща: декодираната дължина да е равна на дължината на източника и avail_in да е нула. Остатък от вход след крайния маркер е подписът на слепен stream. Поправката е проверена точно така: 200 KB тестови данни, обхващащи четири парчета по 64 KB, минаха през новия DeflateStream и излязоха като 534-байтов едночленен zlib stream, стандартен zlib decoder възстанови всички 200 000 байта без остатъчен вход, а същата проверка мина и на i386 cross-компилираната FPC цел. Рутината по-долу е FPC версията на тази проверка, изградена директно върху paszlib, така че не се доверява на кода, който тества
uses Classes, SysUtils, paszlib, PDFlibZLib;

function IsSingleZlibMember(Packed: TMemoryStream; out Decoded: Int64): Boolean;
var
  strm: TZStream;
  Buf: array[0..65535] of Byte;
  Status: Integer;
begin
  Result:= False;
  Decoded:= 0;
  FillChar(strm, SizeOf(strm), 0);
  if inflateInit2(strm, 15) <> Z_OK then
    Exit;
  try
    strm.next_in:= Packed.Memory;
    strm.avail_in:= Cardinal(Packed.Size);
    repeat
      strm.next_out:= @Buf;
      strm.avail_out:= SizeOf(Buf);
      Status:= inflate(strm, Z_NO_FLUSH);
    until Status <> Z_OK;
    Decoded:= strm.total_out;
    // Един член завършва точно на последния входен байт
    Result:= (Status = Z_STREAM_END) and (strm.avail_in = 0);
  finally
    inflateEnd(strm);
  end;
end;

// Прекарайте 200 000 байта през DeflateStream със стандартното парче от 64 KB
// и изисквайте един член, който се декодира обратно до пълната дължина
Source.Position:= 0;
DeflateStream(Source, Packed);
if not (IsSingleZlibMember(Packed, Decoded) and (Decoded = Source.Size)) then
  raise Exception.Create('DeflateStream produced more than one zlib member');
На ниво приложение полезният assert е този, който библиотеката не прави вместо вас: сравнете какво излиза от attachment-а с /Params /Size, записан при вкарването му. GetEmbeddedFileIntProperty с tag 5 връща този записан размер, индексите на вградените файлове са от 1, а payload-ът трябва да е поне 1 MiB, за да влезе в streaming пътя. Пуснете същия тест на всеки компилатор, с който доставяте, щом първоначалният дефект минаваше на Delphi и падаше само на FPC
procedure CheckLargeAttachmentRoundTrip(const PayloadFile, OutFile: string);
var
  PDF: TPDFlib;
  Extracted: TMemoryStream;
  I, Declared: Integer;
begin
  PDF:= TPDFlib.Create;
  try
    PDF.NewDocument;
    PDF.AddStandardFont(4);
    PDF.DrawText(80, 100, 'Large attachment round trip');
    // 1 MiB или повече влиза в chunked DeflateStream пътя в ReadFromStream
    if PDF.EmbedFile('Payload', PayloadFile, 'application/octet-stream') <> 1 then
      raise Exception.Create('EmbedFile failed');
    if PDF.SaveToFile(OutFile) <> 1 then
      raise Exception.Create('SaveToFile failed');
  finally
    PDF.Free;
  end;

  PDF:= TPDFlib.Create;
  Extracted:= TMemoryStream.Create;
  try
    if PDF.LoadFromFile(OutFile, '') = 0 then
      raise Exception.Create('LoadFromFile failed');
    for I:= 1 to PDF.EmbeddedFileCount do
    begin
      Extracted.Clear;
      if PDF.GetEmbeddedFileContentToStream(I, Extracted) <> 1 then
        raise Exception.CreateFmt('Attachment %d could not be decoded', [I]);
      Declared:= PDF.GetEmbeddedFileIntProperty(I, 5);   // /Params /Size
      if Extracted.Size <> Declared then
        raise Exception.CreateFmt('Attachment %d truncated: %d of %d bytes',
          [I, Extracted.Size, Declared]);
    end;
  finally
    Extracted.Free;
    PDF.Free;
  end;
end;
Какво не се променя с поправката?
FPC клонът запазва снисходителните си правила за декодиране и не поправя файлове, които по-стари FPC build-ове вече са написали. При достигнат MaxOutput FPC InflateStream съкращава на лимита и се връща, докато Delphi клонът вдига ERangeError, а FPC и нататък приема частично декодиран изход, когато inflate съобщава data error, защото някои PDF производители излъчват съкратени или с развален checksum stream-ове. PDF, написан от FPC build преди v3.539.24, и нататък съдържа слепени членове, а поправеният четец, като всеки друг, спира на първия Z_STREAM_END. Не се опитвайте да излекувате такъв файл, като декодирате и прекодирате stream-а в библиотеката — това само вковава трайно съкращението до 64 KB. Вградете attachment-а наново от оригиналния му източник. FPC цикълът също завършва на първото четене, върнало по-малко от пълно парче, а това е сигнал за край на данните само за stream-ове като TFileStream и TMemoryStream, така че собствен TStream, подаден на AddAssociatedFileFromStream, е най-безопасно първо да се копира в TMemoryStream. Delphi клонът, helper-ите DeflateStr и InflateStr и всеки stream под 1 MiB по обикновения Flate път се държат точно както преди
Поправеният FPC DeflateStream и InflateStream излизат в v3.539.24 на PDF Library for Delphi, която таргети Delphi, C++Builder и Free Pascal от едно кодово дърво, и където голям attachment вече би трябвало да се върне от FPC build байт по байт, точно както винаги се е връщал от Delphi