استورد FDF إلى نموذج وستعود قيم الحقول خاطئة بشكل خفي: نقطة قائمة تصل كخنجر، وعلامة حذف كشرطة إم. اقتفى مكوّن PDFium تلك العائلة الكاملة من الأعراض إلى صف واحد في جدول PDFDocEncoding الخاص به — كتلة الأحرف الخاصة في الملحق D.2 من ISO 32000-1 تبدأ عند $80 لا $7F
لماذا يعيد استيراد FDF الحرف المجاور؟
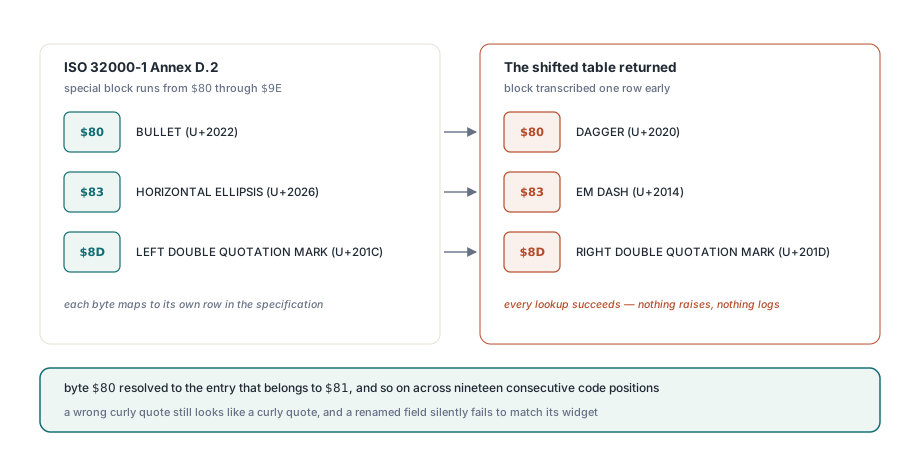
لأن جدول ترميز مُزاح موضعًا واحدًا ما يزال جدولًا يبدو صالحًا تمامًا، وكل بحث فيه ينجح. الكتلة التي يخصصها الملحق D.2 لما بين $80 و$9E نُسخت صفًا واحدًا مبكرًا، فتحللت البايتة $80 إلى الإدخال الذي يخص $81، والبايتة $81 إلى إدخال $82، وهكذا عبر تسعة عشر موضعًا متتاليًا. لا شيء أطلق استثناءً، ولا شيء سُجل، ولم يُرفض حقل أبدًا — أبلغ TPdf.ImportFDF بنفس عدد الحقول الذي اعتاد عليه دائمًا
الضرر كان موحدًا وصامتًا. بايتة تحمل $80، التي يعرّفها الملحق D.2 كـ BULLET (U+2022)، عادت كـ DAGGER (U+2020). والبايتة $83، HORIZONTAL ELLIPSIS (U+2026)، عادت كـ EM DASH (U+2014). والبايتة $8D، LEFT DOUBLE QUOTATION MARK (U+201C)، عادت كـ RIGHT DOUBLE QUOTATION MARK (U+201D) — وهي الحالة التي لا يلاحظها أحد، لأن علامة اقتباس منحنية خاطئة ما تزال تبدو علامة اقتباس منحنية في حقل نموذج. أسماء الحقول لاقت المصير نفسه الذي لاقته قيم الحقول، وهو أسوأ: اسم لم يعد يطابق عنصر الواجهة في المستند يفشل في التطبيق بصمت
سلاسل نص PDF تحمل ترميزين مختلفين
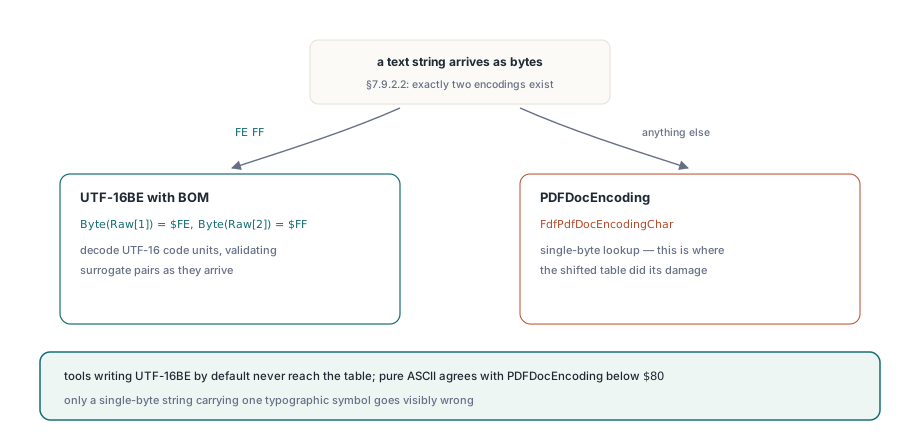
يعرّف ISO 32000-1 §7.9.2.2 نوع سلسلة النص كواحد من ترميزين بالضبط، يُختار بفحص أول بايتتين لا بأي إدخال قاموس. السلسلة التي تفتتح بعلامة ترتيب البايتات FE FF هي UTF-16BE؛ وأي شيء آخر هو PDFDocEncoding. ذلك الفرع الوحيد يقرر أي مفككي ترميز مختلفين تمامًا سيعمل، ويطبقه مكوّن PDFium داخل محلل FDF قبل أن يلمس حرفًا واحدًا
// سلسلة نص FDF: UTF-16 عند وجود BOM، وPDFDocEncoding فيما عدا ذلك
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... فك وحدات UTF-16 مع التحقق من أزواج الاستبدال
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
لهذا اختبأ الخلل طويلًا في الاختبارات العادية. أي FDF تنتجه أداة تكتب UTF-16BE افتراضيًا لا يصل إلى FdfPdfDocEncodingChar إطلاقًا، فتظل الكتلة المُزاحة خاملة. فقط السلاسل أحادية البايت — وهي ما يصدره كثير من مولّدات FDF لأسماء حقول لاتينية بسيطة لأنها أقصر — تسلك الفرع الذي تهم فيه الكتلة. أسماء الحقول ASCII الخالصة تُفكك صحيحًا على أي حال، لأن PDFDocEncoding وASCII متطابقان تحت $80. تحتاج سلسلة أحادية البايت تحوي رمزًا مطبعيًا واحدًا قبل أن يظهر أي خطأ مرئي
الجدول المُصحح، والمرساة اللتان تثبتانه
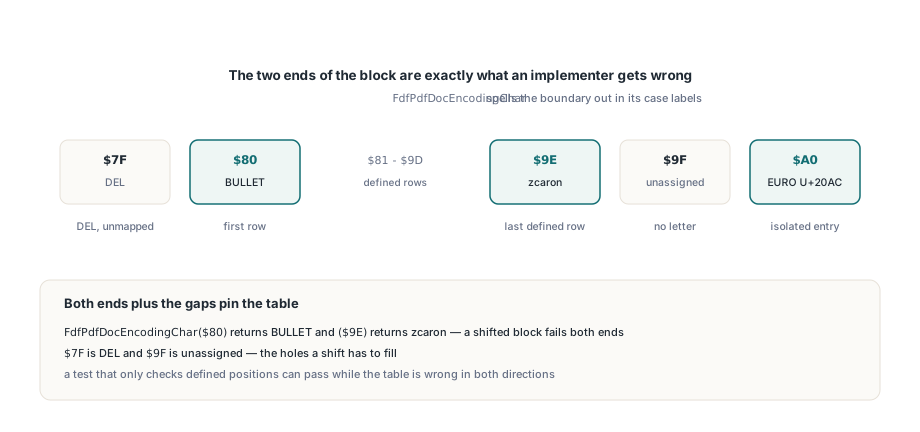
يبين مكوّن PDFium الآن الحد في FdfPdfDocEncodingChar نفسه، لأن طرفي الكتلة هما بالضبط ما يخطئ فيه المنفذ. $7F هو DEL وليس له أي معنى في PDFDocEncoding؛ الكتلة تفتتح عند $80 بـ BULLET وتمتد إلى $9E بـ zcaron؛ $9F غير معيّن؛ وعلامة اليورو تجلس منفردة عند $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // الملحق D.2 من ISO 32000-1. الكتلة تبدأ من $80 لا $7F: $7F هو DEL و
    // ليس له معنى في PDFDocEncoding، واليورو يجلس عند $A0، الذي كان
    // الفرع الافتراضي ليعيده كمسافة غير قابلة للكسر
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET، الصف الأول من الكتلة
    $81: Result := WideChar($2020);   // DAGGER
    // ... من $82 إلى $9D
    $9E: Result := WideChar($017E);   // zcaron، آخر صف معرّف
    $9F: Result := WideChar($FFFD);   // غير معيّن في الملحق D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
انظر إلى ما فعلته الإزاحة بهذين الطرفين، لأن هذا هو الموضع الذي يتوقف فيه خطأ الإزاحة الواحدة عن كونه تجميليًا. كان zcaron يجلس عند $9E في المواصفة لكنه كان عند $9D في الجدول المُزاح، فسقطت بايتة مستند قيمتها $9E بعد آخر صف نسخه أحدهم وهوت مباشرة إلى مسار الهوية الاحتياطي، عائدة بحرف تحكم C1 بدلًا من حرف. و$A0، اليورو، لم يُكتب في الجدول أصلًا — أعاده فرع الهوية كـ U+00A0 NO-BREAK SPACE، حرف ينجو من كل تحقق لاحق، ولا يطبع شيئًا، ولا يطابق أبدًا اسم الحقل الذي تبحث عنه
كيف تختبر جدول ترميز منسوخًا؟
اختبر الصف الأول والصف الأخير والفجوات — لا عينة من المنتصف. هذا هو الجزء من الإصلاح الذي يستحق حمله إلى أي جدول آخر تنسخه من مواصفة، لأن فحصًا نقطيًا في منتصف الكتلة هو بالضبط الاختبار الذي تنجو منه إزاحة الكتلة كاملة. التحقق من أن $8D يعطي علامة اقتباس مزدوجة يسرى لا يثبت شيئًا عندما يعطي $8C أيضًا شيئًا معقولًا؛ التحقق من أن $80 يعطي BULLET و$9E يعطي zcaron يثبت الطرفين معًا، والكتلة المُزاحة لا تستطيع إرضاءهما في آن واحد
procedure CheckPdfDocEncodingAnchors;
begin
  // طرفا كتلة الأحرف الخاصة في الملحق D.2: إزاحة كتلة كاملة تكسرهما
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // مواضع الكود التي تتركها المواصفة غير معرّفة يجب ألا تُفكك كحرف
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // الإدخال المعزول فوق الكتلة، سهل حذفه بالكامل
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
المواضع غير المعرّفة تستحق تأكيداتها الخاصة بدلًا من تخطيها باعتبارها غير مثيرة للاهتمام. خطأ الإزاحة الواحدة لا بد أن يضع شيئًا في مكان ما، والمكان الذي يضعه فيه دائمًا تقريبًا موضع كود تركته المواصفة فارغًا — $7F في المقدمة و$9F في الخلف. اختبار يفحص المواضع المعرّفة فقط يمكنه أن ينجح بينما الجدول خاطئ في الاتجاهين معًا؛ اختبار يثبت الفجوات يلتقط الإزاحة من التشغيل الأول
كم يكلف هذا في سير عمل نماذج ذهاب وإياب
استيراد FDF يعيد كتابة حرف واحد لكل رمز بصمت أسوأ من استيراد يفشل، لأن الفشل يظهر في مرحلة لاحقة ويبدو كشيء آخر. أسماء الحقول هي الحافة الحادة هنا. يطابق TPdf.ImportFDF الأسماء الواردة مع عناصر الواجهة في المستند المفتوح، والاسم الذي فُك حرفه واحد خطأً ببساطة لا يطابق — يبقى الحقل فارغًا، وما يزال القيمة المعادة تعد الحقل كمحلَّل، والتقرير الذي يخرج من خط المعالجة ينقصه قيمة واحدة دون أي شيء في السجل يفسر السبب. أي شخص يبني حلقة تصدير وإعادة استيراد من النوع الموصوف في تصدير واستيراد بيانات نماذج XFDF والتعليقات مع مكوّن PDFium عليه أن يمرر اسم حقل يحوي رمزًا مطبعيًا، لا ASCII خالصًا فقط، قبل أن يثق بالحلقة
ويستحق أيضًا الصدق حول حدود الإصلاح. الجدول الآن يطابق الملحق D.2 لكل قيم البايتات الـ 256، ما يجعل سلاسل FDF أحادية البايت تُفكك صحيحًا، لكن PDFDocEncoding بذاتها تغطي ذخيرة لاتينية لا أكثر — أي شيء خارجها لا بد أن يصل كـ UTF-16BE مع BOM، وهو بالضبط ما يقصده §7.9.2.2. وسلسلة UTF-16 ما تزال تحمل مخاطرها المنفصلة في جانب دلفي، لأن نقطة كود تتجاوز U+FFFF تحتاج زوج استبدال لا WideChar واحدًا، وهي المشكلة المغطاة في لماذا تكسر رموز emoji وCJK WideChar في دلفي. النقطة الأوسع تعمم إلى ما بعد جداول الترميز: محلل PDF يمكنه رفض شيء يجب أن يقبله، وهو ما تكتشفه فورًا، أو قبول شيء وإخطائه بصمت، وهو ما تكتشفه في الإنتاج. فخاخ رموز الأسماء الموصوفة في تحليل قواميس PDF بأمان تقع في الفئة الثانية، وكذلك جدول مُزاح صفًا واحدًا — مسار الكود ينجح، والقيمة المعادة تبدو معقولة، ولا يقول العكس إلا اختبار مكتوب ضد المواصفة لا ضد التنفيذ
ImportFDF وExportFDF وImportXFDF على TPdf، إلى جانب محللي FDF وXFDF خلفها، جزء من مكوّن PDFium القياسي لدلفي وC++Builder